
Event sourcing, par agrégat
Résumé. Un agrégat en event sourcing ne garde aucune ligne d'état : il garde les faits qui
lui sont arrivés, dans l'ordre, et son état est ce que donne leur rejeu. Le kit le propose par
agrégat, jamais par projet : les autres agrégats du contexte gardent leur état dans des tables,
dans les mêmes transactions. Choisissez-le là où l'historique est le métier ; il coûte un
stockage qui ne fait que croître, des événements stockés qui ne peuvent jamais être modifiés, des
données personnelles qu'il faut sceller, et des projections en retard. Cette page dit quand le
choisir et quand ne pas le choisir, comment le kit le construit, et comment y faire passer un
agrégat puis l'en faire revenir. Les règles sont dans ARCHITECTURE.fr.md,
section 4 (« Agrégats en event sourcing »), et dans les event-sourcing/* de la section 3.
Ce que c'est
Section intitulée « Ce que c'est »Un agrégat persisté par état est enregistré sous la forme de son état courant : la ligne dit ce
qui est vrai maintenant, et ce qui était vrai avant a disparu, sauf si autre chose l'a gardé. Un
agrégat en event sourcing est enregistré sous la forme des événements qu'il a enregistrés :
AttendanceRecordCreated, puis NoShowNoted, puis CancellationNoted. Le charger les rejoue,
du plus ancien au plus récent, par une méthode apply par événement ; le résultat est l'état sur
lequel décide sa commande suivante. Rien d'autre n'écrit jamais l'état, si bien que l'état que
laisse une commande et l'état que reconstruit un chargement ultérieur sont les mêmes.
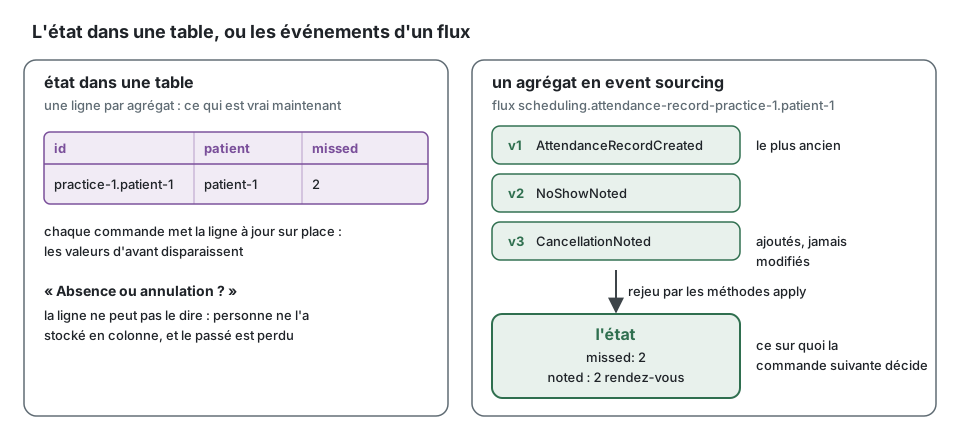
Les événements d'un agrégat forment son flux. Le store garde chaque flux, et le store entier dans l'ordre où les ajouts ont été validés, afin que les projections puissent le suivre.
Quand le choisir, et quand ne pas le choisir
Section intitulée « Quand le choisir, et quand ne pas le choisir »| Choisissez-le quand | Préférez l'état dans une table quand |
|---|---|
| l'historique est ce avec quoi travaille le métier : ce qui s'est passé, dans quel ordre, qui a décidé, tel qu'on le croyait alors (un relevé de présence, un grand livre, une réclamation, un dossier) | le métier demande ce qui est vrai maintenant, et l'historique est un journal pour le support |
| une question ultérieure a besoin de faits que personne n'a stockés en colonnes (« combien de patients ont manqué deux fois après une annulation ? ») | les lectures sont des listes et des détails de l'état courant |
| plusieurs modèles de lecture sont dérivés des mêmes faits, et de nouveaux seront ajoutés et remplis à partir du passé | un seul modèle de lecture, ou aucun |
| les corrections sont elles-mêmes des faits (une contre-passation, une remise), jamais une modification | les corrections sont des modifications |
| l'agrégat est petit et vit longtemps, avec un nombre modeste d'événements par flux | un flux grossirait sans limite en peu de temps, ou l'agrégat est un document modifié champ par champ |
Un journal d'audit n'est pas une raison à lui seul : le kit enregistre qui a fait quoi autour de chaque cas d'usage (Journal d'audit), quelle que soit la persistance de l'agrégat.
Ce qu'il coûte
Section intitulée « Ce qu'il coûte »| Coût | Ce que cela signifie ici |
|---|---|
| Le stockage ne fait que croître | un flux n'est jamais raccourci ; les snapshots raccourcissent le rejeu, pas le flux |
| Les événements stockés sont immuables | la forme d'un événement stocké une fois est lue aussi longtemps que vit l'agrégat : un changement est une nouvelle version avec un upcaster, pour toujours (event-sourcing/upcaster-required) |
| Données personnelles | un événement ne peut pas être modifié pour oublier une personne : les valeurs personnelles sont scellées avec une clé par personne concernée, et l'effacement détruit la clé (ci-dessous) |
| Les projections sont en retard | une projection alimentée par le store est cohérente à terme avec les flux ; une lecture qui doit voir l'écriture qu'elle suit lit l'agrégat, ou une projection alimentée dans l'unité de travail |
| Les ajouts sont sérialisés | le store PostgreSQL donne les positions dans l'ordre des validations en verrouillant la tête du store jusqu'à la fin de chaque transaction qui ajoute : deux ajouts ne s'exécutent jamais côte à côte, quels que soient leurs flux. Cela convient à un agrégat métier, pas à un flot massif. Un ajout qui perd face à un autre est une ConcurrencyError que l'appelant réessaie : une version en double, mais aussi un échec de sérialisation (une unité de travail en REPEATABLE READ ou SERIALIZABLE) ou un interblocage avec des verrous de ligne que la même transaction a pris dans un autre ordre. Ajoutez en dernier dans une unité de travail pour garder la tête verrouillée le moins longtemps possible |
| Le débogage | l'état n'est pas dans une ligne : un bogue se trouve en rejouant un flux, ce que font les tests sans base de données (givenEvents) |
| L'équipe | méthodes apply, upcasters, snapshots et reconstructions sont de nouvelles habitudes ; les règles tiennent la partie mécanique |
Comment le kit le construit
Section intitulée « Comment le kit le construit »| Pièce | Où | Ce qu'elle fait |
|---|---|---|
EventSourcedAggregate<E, S> |
kernel, domain/ |
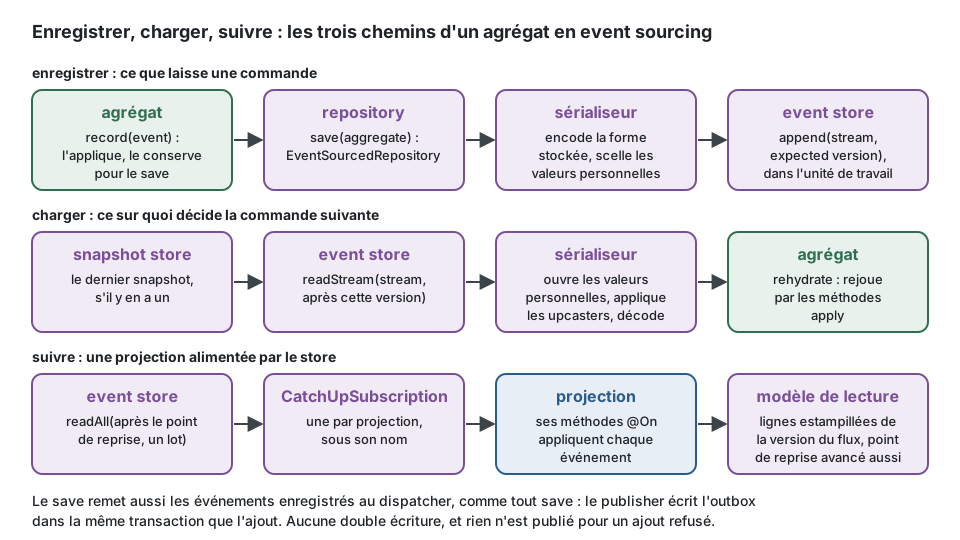
une commande vérifie ses invariants sur l'état, puis this.record(event) ; l'événement est appliqué par la méthode que appliers() nomme pour lui et gardé pour le save. La méthode statique rehydrate(id, history) de l'agrégat appelle replay, qui applique l'historique à partir d'un snapshot quand il y en a un et n'enregistre rien |
| méthodes apply | l'agrégat | apply<Fact>(event), une par événement, le seul endroit qui écrit l'état (event-sourcing/state-in-apply) ; elles n'enregistrent rien |
| le codec | infrastructure/persistence/<aggregate>-events.mapper.ts |
defineStoredEvent(Event, { version, encode, decode, upcasters }) par événement, avec le type nommé de ses données |
| le repository | le port dans domain/repositories/, son adaptateur dans infrastructure/persistence/ |
le même port que pour tout agrégat ; l'adaptateur délègue à EventSourcedRepository, qui ajoute à la version à laquelle l'agrégat a été chargé (sinon une ConcurrencyError) |
| le store | port EventStore ; PostgreSQL par knex, drizzle, prisma et TypeORM ; en mémoire pour les tests |
ajout avec une version attendue, chaque flux dans l'ordre, le store entier par position, tenu par une même suite de contrat |
| les snapshots | SnapshotPolicy du repository, par agrégat |
tous les N événements, avec une version de forme qui leur est propre ; expectSnapshotEquivalence les prouve |
| les projections | @Projection(name, { feed: 'event-store' }) |
appliquées par une CatchUpSubscription avec un point de reprise stocké, reconstruites depuis la position zéro par EventStoreProjectionRebuild |
ddd-ts-kit generate aggregate <context> <Name> --event-sourced écrit l'agrégat avec son
événement de naissance et sa méthode apply, le codec, un builder qui rejoue un historique et une
spec en événements donnés ; generate domain-event sur un tel agrégat ajoute l'événement à son
union, à appliers() avec une méthode apply vide, et au codec. describe, list et CONTEXT.md
disent quels agrégats sont en event sourcing.
Pas de double écriture. Ajouter les événements et publier les événements d'intégration ne
font qu'une transaction : le store rejoint la transaction de l'unité de travail, et le
publisher est un gestionnaire before-commit des événements du domaine, qui écrit l'outbox. Le
kit a choisi « le store alimente l'outbox » plutôt que « l'outbox lit le store » : les événements
d'intégration gardent l'outbox, son relais, ses nouvelles tentatives et son langage publié, et un
agrégat en event sourcing publie exactement comme un agrégat persisté par état.
eventStoreUnitOfWorkContract y tient chaque store transactionnel : rien n'est publié pour un
ajout annulé ou refusé par un conflit de concurrence.
Frontières. Le domaine et les cas d'usage ne nomment jamais le store
(event-sourcing/store-behind-repository) : ils chargent et enregistrent par le port. Une
projection n'ajoute jamais rien à un flux (event-sourcing/projection-never-appends). Les
événements sont nommés au passé (event-sourcing/past-tense).
La chaîne complète, en mémoire
Section intitulée « La chaîne complète, en mémoire »Les pièces du tableau, dans un seul fichier, sur le store en mémoire du kernel : un agrégat à
deux événements, son codec, et l'EventSourcedRepository auquel délègue l'adaptateur de son
repository. Un projet le répartit entre domain/ et infrastructure/persistence/, comme le
disent les commentaires.
import {  ConceptError,  EventSerializer,  EventSourcedAggregate,  EventSourcedRepository,  InMemoryEventStore,  defineStoredEvent,  type AggregateHistory,  type Appliers,  type DomainEvent,  type StoredEventTypes,} from '@ddd-ts-kit/kernel';
// domain/events : des faits, au passéexport class AttendanceRecordCreated implements DomainEvent {  static readonly eventName = 'scheduling.attendance-record.created';
  readonly name = AttendanceRecordCreated.eventName;
  constructor(    readonly aggregateId: string,    readonly occurredAt: Date,    readonly patientId: string,  ) {}}
export class AttendanceRecordNoShowNoted implements DomainEvent {  static readonly eventName = 'scheduling.attendance-record.no-show-noted';
  readonly name = AttendanceRecordNoShowNoted.eventName;
  constructor(    readonly aggregateId: string,    readonly occurredAt: Date,    readonly appointmentId: string,  ) {}}
export type AttendanceRecordEvent = AttendanceRecordCreated | AttendanceRecordNoShowNoted;
export class AttendanceRecordError extends ConceptError {  static alreadyNoted(appointmentId: string) {    return AttendanceRecordError.refusal('ALREADY_NOTED', `Appointment ${appointmentId} is already noted.`, {      appointmentId,    });  }}
// domain/aggregates : l'état est la somme des événementsexport class AttendanceRecord extends EventSourcedAggregate<AttendanceRecordEvent> {  private noted: readonly string[] = [];
  private constructor(id: string) {    super(id);  }
  static create(id: string, patientId: string, now: Date): AttendanceRecord {    const record = new AttendanceRecord(id);    record.record(new AttendanceRecordCreated(id, now, patientId));
    return record;  }
  static rehydrate(id: string, history: AggregateHistory<AttendanceRecordEvent>): AttendanceRecord {    return new AttendanceRecord(id).replay(history);  }
  get missed(): number {    return this.noted.length;  }
  /** Une commande : vérifie sur l'état, puis enregistre ce qu'elle a décidé. */  noteNoShow(appointmentId: string, now: Date): void {    if (this.noted.includes(appointmentId)) {      throw AttendanceRecordError.alreadyNoted(appointmentId);    }
    this.record(new AttendanceRecordNoShowNoted(this.id, now, appointmentId));  }
  /** Une méthode apply par événement : un événement qui n'en a pas ne compile pas. */  protected appliers(): Appliers<AttendanceRecordEvent> {    return {      [AttendanceRecordCreated.eventName]: () => undefined,      [AttendanceRecordNoShowNoted.eventName]: (event) => this.applyNoShowNoted(event),    };  }
  /** Le seul endroit qui écrit l'état ; elle n'enregistre rien. */  private applyNoShowNoted(event: AttendanceRecordNoShowNoted): void {    this.noted = [...this.noted, event.appointmentId];  }}
// infrastructure/persistence/attendance-record-events.mapper.ts : une forme stockée par événementinterface AttendanceRecordCreatedData {  readonly patientId: string;}
interface AttendanceRecordNoShowNotedData {  readonly appointmentId: string;}
const attendanceRecordEvents: StoredEventTypes<AttendanceRecordEvent> = {  [AttendanceRecordCreated.eventName]: defineStoredEvent(AttendanceRecordCreated, {    version: 1,    encode: (event): AttendanceRecordCreatedData => ({ patientId: event.patientId }),    decode: (data, { aggregateId, occurredAt }) =>      new AttendanceRecordCreated(aggregateId, occurredAt, data.text('patientId')),  }),  [AttendanceRecordNoShowNoted.eventName]: defineStoredEvent(AttendanceRecordNoShowNoted, {    version: 1,    encode: (event): AttendanceRecordNoShowNotedData => ({ appointmentId: event.appointmentId }),    decode: (data, { aggregateId, occurredAt }) =>      new AttendanceRecordNoShowNoted(aggregateId, occurredAt, data.text('appointmentId')),  }),};
// infrastructure/persistence : ce à quoi délègue l'adaptateur du port de repositoryconst store = new InMemoryEventStore();const records = new EventSourcedRepository({  store,  category: 'scheduling.attendance-record',  serializer: new EventSerializer<AttendanceRecordEvent>(attendanceRecordEvents),  rehydrate: (id, history) => AttendanceRecord.rehydrate(id, history),});
const now = new Date('2026-03-09T10:00:00Z');
await records.save(AttendanceRecord.create('practice-1.patient-1', 'patient-1', now)); // ajoute à la version 0
const record = await records.findById('practice-1.patient-1'); // rejoue le fluxrecord?.noteNoShow('appointment-1', now);record?.noteNoShow('appointment-2', now);
if (record !== undefined) {  await records.save(record); // ajoute deux événements, en attendant la version 1}
// le flux contient created (version 1), no-show-noted (version 2), no-show-noted (version 3)await store.readStream('scheduling.attendance-record-practice-1.patient-1');
// deux commandes chargent la même version : le premier ajout gagne, le second est refuséconst first = await records.findById('practice-1.patient-1');const second = await records.findById('practice-1.patient-1');first?.noteNoShow('appointment-3', now);second?.noteNoShow('appointment-4', now);
if (first !== undefined && second !== undefined) {  await records.save(first);  await records.save(second).catch((error: unknown) => error); // ConcurrencyError, code CONCURRENCY_CONFLICT : réessayer la commande}
Au lieu de changer l'état dans la commande et d'enregistrer à côté :
noteNoShow(appointmentId: string, now: Date): void { this.noted = [...this.noted, appointmentId]; // event-sourcing/state-in-apply : un rejeu ne le ferait jamais this.record(new AttendanceRecordNoShowNoted(this.id, now, appointmentId));}enregistrez le fait, et laissez sa méthode apply changer l'état, de la même façon pour la commande et pour chaque rejeu ultérieur :
noteNoShow(appointmentId: string, now: Date): void { this.record(new AttendanceRecordNoShowNoted(this.id, now, appointmentId)); // l'applique : applyNoShowNoted}Les événements stockés se versionnent comme des contrats avec le passé
Section intitulée « Les événements stockés se versionnent comme des contrats avec le passé »Un événement d'intégration est un contrat avec d'autres contextes (Versionnement des événements) ; un événement stocké est un contrat avec chaque version passée du code. Le kit applique la même discipline avec son propre mécanisme :
- Les données d'un événement stocké sont un type nommé dans son fichier de codec, renvoyé par
encode. Chaque type nommé qu'il atteint est déclaré dans le même fichier lui aussi (à part lePersonalValuedu kit) : un type du domaine importé d'ailleurs changerait la forme stockée sans que personne ne le voie, donc le codec le traduit en un type stocké qui lui est propre. ddd-ts-kit docs --stored-eventsenregistre l'empreinte de ce type, et des types qu'il atteint, pour chaque version, dansstored-events.lock.json, une fois que la forme de la version est celle à stocker. Une version enregistrée n'est jamais réécrite.ddd-ts-kit docs --check, que le pipeline généré exécute (npm run docs:check), échoue tant qu'une version déclarée n'est pas enregistrée : une version ne peut pas atteindre la branche principale, ni donc une version publiée (release), sans être enregistrée. Avant la fusion, une version enregistrée qui n'a jamais été stockée peut encore être retirée du fichier de verrouillage à la main et enregistrée à nouveau.- Un changement du type est une nouvelle version :
version: 2et l'upcaster depuis la version 1,upcasters: { 1: (data) => ({ ...data, reason: '' }) }. L'événement stocké n'est jamais réécrit : il est transformé à chaque lecture. ddd-ts-kit checkrefuse une version enregistrée dont la forme a changé, une version supérieure à 1 sans upcaster depuis chaque version inférieure, et une version inférieure à la dernière enregistrée. ESLint tient les deux vérifications qu'un seul fichier montre.
Un événement du domaine peut changer librement tant que encode et decode le traduisent
toujours vers et depuis les formes stockées : c'est le type stocké, pas la classe, qui est le
contrat.
Supposons que la version 1 de AttendanceRecordCancellationNoted ne stockait aucun motif, et que
le métier demande maintenant les mots du patient. Le codec déclare la version 2 et l'upcaster
qui lit une version 1 comme une version 2 ; les événements déjà stockés restent tels quels :
// contexts/scheduling/infrastructure/persistence/attendance-record-events.mapper.ts (une entrée)import { defineStoredEvent, personalData, type DomainEvent, type PersonalValue } from '@ddd-ts-kit/kernel';
export class AttendanceRecordCancellationNoted implements DomainEvent {  static readonly eventName = 'scheduling.attendance-record.cancellation-noted';
  readonly name = AttendanceRecordCancellationNoted.eventName;
  constructor(    readonly aggregateId: string,    readonly occurredAt: Date,    readonly cancelled: { readonly patientId: string; readonly appointmentId: string; readonly reason: string | undefined },  ) {}}
/** La forme stockée de la version 2 : ce dont `docs --stored-events` prend l'empreinte. */interface AttendanceRecordCancellationNotedData {  readonly patientId: string;  readonly appointmentId: string;  /** Les mots du patient, scellés avec la clé du patient : effacés avec elle. */  readonly reason: PersonalValue | null;}
export const cancellationNoted = defineStoredEvent(AttendanceRecordCancellationNoted, {  version: 2,  encode: ({ cancelled }): AttendanceRecordCancellationNotedData => ({    patientId: cancelled.patientId,    appointmentId: cancelled.appointmentId,    reason: cancelled.reason === undefined ? null : personalData(cancelled.patientId, cancelled.reason),  }),  decode: (data, { aggregateId, occurredAt }) =>    new AttendanceRecordCancellationNoted(aggregateId, occurredAt, {      patientId: data.text('patientId'),      appointmentId: data.text('appointmentId'),      reason: data.optionalText('reason'),    }),  // la version 1 n'avait pas de motif : elle est lue comme une version 2 sans motif, à chaque fois, jamais réécrite  upcasters: { 1: (data) => ({ ...data, reason: null }) },});
Données personnelles : crypto-shredding
Section intitulée « Données personnelles : crypto-shredding »Un événement ne peut pas être modifié pour oublier une personne, et les sauvegardes le gardent de toute façon. Le kit scelle plutôt les valeurs personnelles :
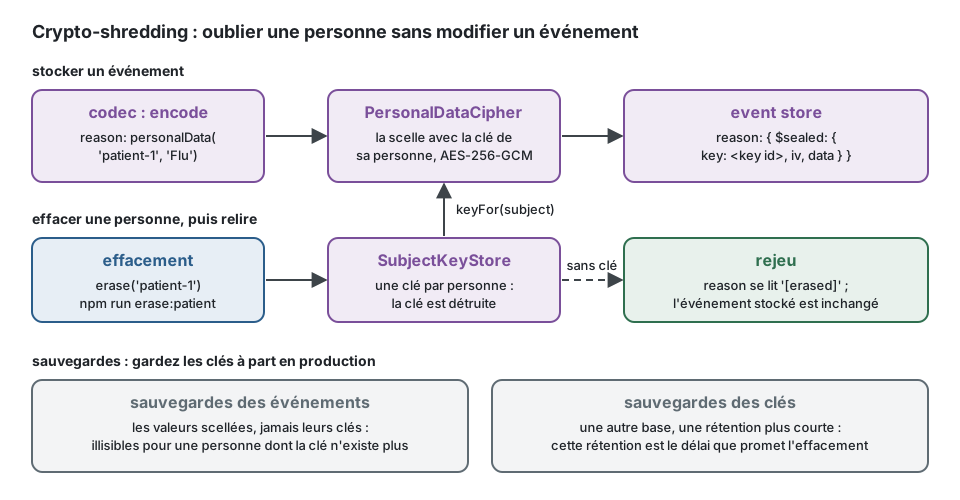
personalData(subjectId, value)marque une valeur dansencode;PersonalDataCipherla scelle avec la clé de sa personne concernée (AES-256-GCM, un nonce neuf par valeur, l'identifiant de la clé écrit à côté) avant qu'elle atteigne le store, et l'ouvre quand l'événement est lu.SubjectKeyStoreest le port des clés, une par personne concernée : en mémoire, ou une table du store PostgreSQL.erase(subject)supprime la clé, et un rejeu lit alorsERASED_PERSONAL_DATA([erased]) à la place de chaque valeur scellée avec elle. Une clé ultérieure de la même personne n'ouvre jamais une valeur plus ancienne.- Une projection reconstruite après un effacement montre la valeur effacée ; une projection qui détient déjà la valeur en clair doit être reconstruite, ou appliquer un événement d'effacement qui lui est propre.
Tout le mécanisme en quelques lignes, sur les stores en mémoire du kernel :
import {  ERASED_PERSONAL_DATA,  EventSerializer,  InMemoryEventStore,  InMemorySubjectKeyStore,  PersonalDataCipher,  defineStoredEvent,  personalData,  type DomainEvent,  type PersonalValue,  type StoredEventTypes,} from '@ddd-ts-kit/kernel';
export class AttendanceRecordCancellationNoted implements DomainEvent {  static readonly eventName = 'scheduling.attendance-record.cancellation-noted';
  readonly name = AttendanceRecordCancellationNoted.eventName;
  constructor(    readonly aggregateId: string,    readonly occurredAt: Date,    readonly patientId: string,    readonly reason: string | undefined, // les mots du patient : une donnée personnelle  ) {}}
interface AttendanceRecordCancellationNotedData {  readonly patientId: string;  readonly reason: PersonalValue | null;}
const events: StoredEventTypes<AttendanceRecordCancellationNoted> = {  [AttendanceRecordCancellationNoted.eventName]: defineStoredEvent(AttendanceRecordCancellationNoted, {    version: 1,    encode: (event): AttendanceRecordCancellationNotedData => ({      patientId: event.patientId,      reason: event.reason === undefined ? null : personalData(event.patientId, event.reason),    }),    decode: (data, { aggregateId, occurredAt }) =>      new AttendanceRecordCancellationNoted(aggregateId, occurredAt, data.text('patientId'), data.optionalText('reason')),  }),};
const keys = new InMemorySubjectKeyStore();const serializer = new EventSerializer(events, { cipher: new PersonalDataCipher(keys) });const store = new InMemoryEventStore();const stream = 'scheduling.attendance-record-practice-1.patient-1';
const noted = new AttendanceRecordCancellationNoted('practice-1.patient-1', new Date(), 'patient-1', 'Flu');await store.append(stream, 0, [await serializer.serialize(noted)]);// stocké : { patientId: 'patient-1', reason: { $sealed: { key: '<key id>', iv: '...', data: '...' } } }
const [stored] = await store.readStream(stream);
if (stored !== undefined) {  const before = await serializer.deserialize(stored);  before.reason; // 'Flu' : ouvert avec la clé de patient-1
  await keys.erase('patient-1'); // le droit à l'effacement : la clé est détruite
  const after = await serializer.deserialize(stored);  after.reason === ERASED_PERSONAL_DATA; // true : '[erased]', et l'événement stocké n'est pas touché}
Ce qu'atteint un effacement, c'est exactement ce qui perd la clé :
- les flux et les snapshots vivants, immédiatement ;
- chaque sauvegarde des événements prise après l'effacement, qui contient les valeurs scellées sans leur clé ;
- une sauvegarde prise avant l'effacement contient à la fois les valeurs scellées et leur clé
quand la table des clés est sauvegardée avec les événements, ce qui est le cas de
PostgresSubjectKeyStoredans la base de données des événements. Une telle sauvegarde ouvre encore les valeurs jusqu'à son expiration : l'effacement n'est complet qu'une fois disparue la dernière sauvegarde plus ancienne que lui.
Gardez donc les clés à part en production : un SubjectKeyStore sur une autre base de données
dont les sauvegardes ont une rétention plus courte que celles des événements
(new PostgresSubjectKeyStore(run) prend n'importe quel SqlRun, une seconde connexion suffit
donc), ou un adaptateur à vous sur un service de gestion de clés, derrière le même port. Alors les
sauvegardes des événements ne portent jamais les clés, et la rétention des sauvegardes des clés
est le délai que promet l'effacement.
Ce qu'il ne fait pas : les identifiants ne sont pas scellés. Un flux nommé d'après un patient
(scheduling.attendance-record-<practice>.<patient>) garde cet identifiant dans le store.
Utilisez des identifiants qui ne signifient rien en dehors de l'application.
L'exemple garde les clés dans la table subject_keys du schéma scheduling de sa propre base de
données, à côté des événements, pour rester exécutable avec un seul PostgreSQL ; son README le
dit et nomme ce que change un déploiement. Son effacement (npm run erase:patient) détruit la clé
d'un patient et reconstruit les projections alimentées par le store, afin que le modèle de lecture
de l'historique perde aussi le motif en clair.
Projections alimentées par le store
Section intitulée « Projections alimentées par le store »Une projection qui n'a besoin que des faits de son propre contexte est d'ordinaire appliquée là
où les événements du domaine sont distribués, dans la transaction de la commande. Une projection
d'agrégats en event sourcing peut plutôt suivre le store : déclarée
@Projection(name, { feed: 'event-store' }), elle est appliquée par une CatchUpSubscription
sous son nom, qui lit le store après son point de reprise, applique un lot et avance le point de
reprise dans une même unité de travail. Une projection ajoutée plus tard commence à la position
zéro et est donc remplie à partir de tout l'historique. EventStoreProjectionRebuild rejoue le
store dans une copie vide du modèle de lecture et l'échange contre l'ancien, sans arrêter
l'abonnement. Chaque ligne est estampillée de la version de son flux (storedStampOf), si bien
qu'un événement appliqué deux fois ne change rien.
Le modèle de lecture de l'historique de l'exemple est une telle projection (un extrait) :
@Projection('scheduling.attendance-history', { feed: 'event-store' })export class AttendanceHistoryProjection {  constructor(private readonly history: AttendanceHistory) {}
  @On(AttendanceRecordNoShowNoted)  async noShowNoted(event: AttendanceRecordNoShowNoted): Promise<ReadModelWrite> {    const stamp = storedStampOf(event) ?? stampOf(event); // la version du flux : appliqué deux fois, ne change rien    // ... insère ou met à jour l'entrée `${event.aggregateId}#${stamp.version}` si elle est plus récente  }}
applyingProjection(projection, serializer) relit les événements avec le sérialiseur d'un
agrégat, et refuse (DeclarationError) une projection dont les méthodes @On nomment un
événement que ce sérialiseur ne déclare pas : un tel événement serait sinon ignoré à chaque lot,
en silence. Une projection alimentée par le store suit les événements d'un seul agrégat en
event sourcing ; un modèle de lecture qui en joint deux est fait de deux projections, ou d'une
projection alimentée par le distributeur.
givenEvents(rehydrate, events).when(command).thenEvents([...]): le comportement de l'agrégat à partir d'un historique, sans base de données.expectSnapshotEquivalence({ events, rehydrate, policy, state }): un snapshot reconstruit l'état du rejeu complet, pour chaque version de l'historique.eventStoreContracteteventStoreUnitOfWorkContractpour un store ; la suite de contrat des repositories du kit s'applique à l'adaptateur comme à tout autre.
Une spec de l'agrégat se lit comme les faits dont elle part, la commande, et les faits qu'elle enregistre :
import { describe, expect, it } from 'vitest';import { givenEvents } from '@ddd-ts-kit/testing';import { EventSourcedAggregate, type AggregateHistory, type Appliers, type DomainEvent } from '@ddd-ts-kit/kernel';
class AttendanceRecordCreated implements DomainEvent {  static readonly eventName = 'scheduling.attendance-record.created';
  readonly name = AttendanceRecordCreated.eventName;
  constructor(    readonly aggregateId: string,    readonly occurredAt: Date,    readonly patientId: string,  ) {}}
class AttendanceRecordNoShowNoted implements DomainEvent {  static readonly eventName = 'scheduling.attendance-record.no-show-noted';
  readonly name = AttendanceRecordNoShowNoted.eventName;
  constructor(    readonly aggregateId: string,    readonly occurredAt: Date,    readonly appointmentId: string,  ) {}}
type AttendanceRecordEvent = AttendanceRecordCreated | AttendanceRecordNoShowNoted;
// l'agrégat de « La chaîne complète, en mémoire »declare class AttendanceRecord extends EventSourcedAggregate<AttendanceRecordEvent> {  static rehydrate(id: string, history: AggregateHistory<AttendanceRecordEvent>): AttendanceRecord;  get missed(): number;  noteNoShow(appointmentId: string, now: Date): void;  protected appliers(): Appliers<AttendanceRecordEvent>;}
const rehydrate = (id: string, history: AggregateHistory<AttendanceRecordEvent>) => AttendanceRecord.rehydrate(id, history);const now = new Date('2026-03-09T10:00:00Z');const created = new AttendanceRecordCreated('practice-1.patient-1', now, 'patient-1');
describe('AttendanceRecord', () => {  it('notes a no-show and counts it as missed', () => {    givenEvents(rehydrate, [created, new AttendanceRecordNoShowNoted('practice-1.patient-1', now, 'appointment-1')])      .when((record) => record.noteNoShow('appointment-2', now))      .thenEvents([AttendanceRecordNoShowNoted])      .thenState((record) => expect(record.missed).toBe(2));  });
  it('refuses to note an appointment twice', () => {    givenEvents(rehydrate, [created, new AttendanceRecordNoShowNoted('practice-1.patient-1', now, 'appointment-1')])      .when((record) => record.noteNoShow('appointment-1', now))      .thenError('ALREADY_NOTED', { appointmentId: 'appointment-1' });  });});
Passer un agrégat en event sourcing, et revenir en arrière
Section intitulée « Passer un agrégat en event sourcing, et revenir en arrière »Vers l'event sourcing, un agrégat à la fois :
- Générez le codec et les événements avec la CLI, et ajoutez les méthodes apply : l'agrégat compile à la fois avec ses lignes et avec ses événements pendant les étapes suivantes.
- Déclarez un événement de naissance qui porte tout l'état courant (
<Name>Migrated, ou l'événement de naissance avec ses champs), avec sa forme stockée. - Un script de migration, en une transaction par lot : pour chaque ligne, ajoutez cet événement au flux de l'agrégat à la version 0. Un flux qui existe déjà est sauté : le script peut être relancé.
- Basculez la liaison du port de repository vers l'adaptateur de l'event store. La table passe en lecture seule ; supprimez-la dans une migration ultérieure, une fois qu'une version publiée a tourné sur les flux.
- Reconstruisez les projections que la table alimentait, à partir du store si elles deviennent alimentées par le store.
Retour à l'état dans une table : rejouez chaque flux une fois pour obtenir l'état, écrivez la ligne, rebasculez la liaison du port, et gardez les flux comme archive ou supprimez-les, après avoir vérifié ce que la loi demande de l'historique (les clés d'effacement partent avec eux). Les deux sens laissent intacts le port, les cas d'usage et les événements du domaine ; seuls changent l'intérieur de l'agrégat, son adaptateur et son stockage.
Ce que reçoit chaque adaptateur
Section intitulée « Ce que reçoit chaque adaptateur »| Store | Statut |
|---|---|
| en mémoire | InMemoryEventStore, InMemorySnapshotStore, InMemoryCheckpointStore, InMemorySubjectKeyStore : tests et applications à processus unique ; non transactionnel |
| PostgreSQL par knex | createKnexEventSourcing, tables créées par createEventStoreTables dans une migration |
| PostgreSQL par drizzle | createDrizzleEventSourcing, tables déclarées par eventStoreTables pour drizzle-kit |
| PostgreSQL par Prisma | createPrismaEventSourcing sur les requêtes brutes du client, modèles de prisma/event-store.postgresql.prisma |
| PostgreSQL par TypeORM | createTypeOrmEventSourcing sur l'entity manager, tables sous la forme de eventStoreEntities |
| MySQL, SQLite | non fournis : le store s'appuie sur des instructions propres à PostgreSQL (un jeu d'enregistrements jsonb, une mise à jour et une insertion en une seule instruction) |
| KurrentDB (EventStoreDB) | un adaptateur ultérieur. Ses flux, ses révisions attendues et ses abonnements $all conviennent au port, mais c'est un store séparé : l'outbox et le store des événements traités du contexte ne peuvent pas partager sa transaction, si bien que « pas de double écriture » passerait à « l'outbox lit le store » (un abonnement qui publie), ses positions sont des décalages dans un journal, pas la suite sans trou 1, 2, 3 qu'énonce le contrat, et son client et son image serveur sont trop lourds pour que les suites de ce dépôt l'exécutent honnêtement |
Tous les stores PostgreSQL sont une seule implémentation dans le kernel (PostgresEventStore et
ses compagnons sur un SqlRun) ; chaque package d'ORM ne fait qu'exécuter ses instructions, et
chacun est tenu par les mêmes suites de contrat.
- Un event store par schéma de base de données ; un contexte qui garde le sien lie ses stores dans son module plutôt que dans la plateforme.
- Les ajouts sont sérialisés par store (voir plus haut).
- Une projection alimentée par le store dont les lignes viennent chacune de plusieurs flux ne peut pas être estampillée par la seule version du flux : estampillez-la par identifiant d'événement et par instant.
- La vérification du passé est une liste de mots, pas une grammaire ; un verbe irrégulier qu'elle ne connaît pas est désactivé avec une raison.
generate projectionetgenerate repositoryn'ont pas encore de forme event sourcing : la projection alimentée par le store et l'adaptateur du repository s'écrivent à la main (l'exemple montre les deux).
- Martin Fowler, « Event Sourcing », 2005, https://martinfowler.com/eaaDev/EventSourcing.html
- Greg Young, Versioning in an Event Sourced System, Leanpub, 2017
- Vaughn Vernon, Implementing Domain-Driven Design, Addison-Wesley, 2013, annexe A
- Martin Kleppmann, Designing Data-Intensive Applications, O'Reilly, 2017, chapitres 4 et 11
- « Crypto-shredding », tel que le décrivent pour les event stores Mathias Verraes et d'autres : effacer en détruisant la clé
Voir aussi
Section intitulée « Voir aussi »- Agrégats, Événements du domaine et événements d'intégration
- Outbox transactionnelle, Versionnement des événements
- CQRS tel qu'il est utilisé ici
- L'exemple :
examples/scheduling, le relevé de présence du contexte scheduling