
@ddd-ts-kit/pino
Le port Logger du noyau sur pino : des lignes JSON sur la sortie
standard, les champs de corrélation du travail en cours sur chaque ligne, les secrets
d'authentification masqués, un vidage (flush) pour l'arrêt. Rien dans domain/ ni dans
application/ n'importe ce package, ni ne journalise quoi que ce soit : la racine de
composition lie l'adaptateur, et l'infrastructure, la présentation et les aspects écrivent par le
port.
npm i @ddd-ts-kit/pino pinonpm i -D pino-pretty # seulement pour le format lisibleÉcrit pour pino 10. pino-pretty 13 est un peer facultatif : il n'est chargé que lorsque le
format pretty est demandé.
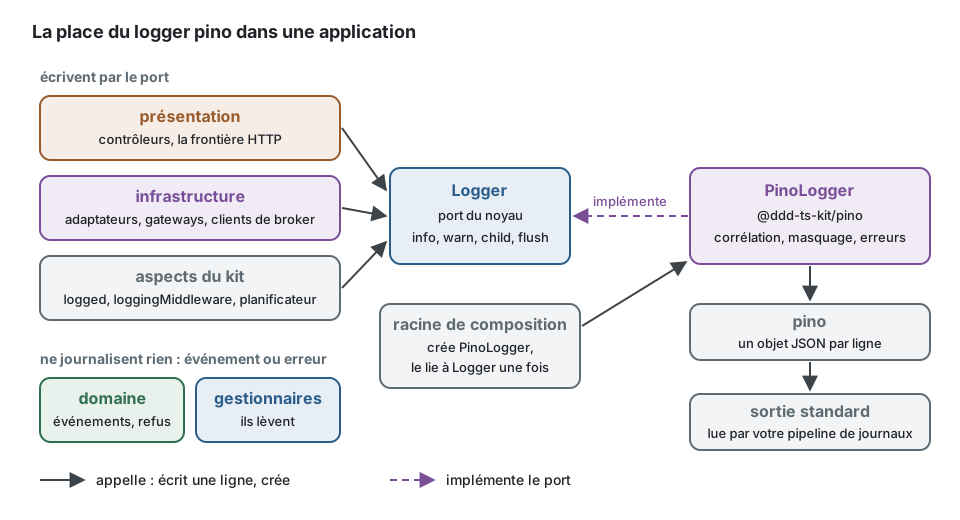
Le domaine et les gestionnaires (handlers) disent ce qui s'est passé par des événements et des
erreurs, jamais par une ligne de journal. Ce qui écrit les entoure : les adaptateurs de
infrastructure/, les contrôleurs de presentation/, et les aspects (logged,
loggingMiddleware, le planificateur de jobs). Tous reçoivent le Logger du noyau ; la racine
de composition y lie PinoLogger une fois. Remplacer pino plus tard change cette seule liaison,
jamais un point d'appel.
Racine de composition
Section intitulée « Racine de composition »import type { ExecutionScope, LogLevel } from '@ddd-ts-kit/kernel';import { createPinoLogger, type PinoLogger } from '@ddd-ts-kit/pino';import { traceLogFields } from '@ddd-ts-kit/tracing';
export interface LogSettings { readonly level: LogLevel; // LOG_LEVEL readonly format: 'json' | 'pretty'; // LOG_FORMAT readonly service: string; readonly environment: string; readonly scrubMessages: boolean; // LOG_SCRUB_MESSAGES}
export function createLogger(scope: ExecutionScope, settings: LogSettings): PinoLogger { return createPinoLogger({ ...settings, fields: () => traceLogFields(scope) });}import { tracing } from '@/platform/tracing'; // en premierimport { createLogger } from '@/platform/observability/create-logger';import { AsyncLocalStorageExecutionScope } from '@ddd-ts-kit/kernel';import { createApplication, kernelModule } from '@ddd-ts-kit/di';
const scope = new AsyncLocalStorageExecutionScope();const logger = createLogger(scope, config.log);
const app = createApplication({ modules: [kernelModule({ executionScope: scope, logger }), ...contexts],});
process.once('SIGTERM', () => void shutdown());
async function shutdown(): Promise<void> { await app.stop(); // vide le rapporteur d'erreurs, puis le logger, en dernier await tracing.shutdown();}init --logger pino écrit ce create-logger.ts (il renvoie un NoopLogger quand il ne reçoit
aucun réglage : c'est ainsi que les outils et les tests restent silencieux) ;
platform/lay-foundations.ts l'appelle une fois et composeApplication passe le logger à
kernelModule({ logger }).
Une ligne de l'application, telle qu'elle est écrite :
{"level":"info","time":"2026-03-01T10:00:00.000Z","service":"shop-api","environment":"production","correlationId":"9f2c","origin":"http","actorId":"user-1","tenantId":"acme","trace_id":"4bf92f3577b34da6a3ce929d0e0e4736","span_id":"00f067aa0ba902b7","context":"shipping","message":"order shipped"}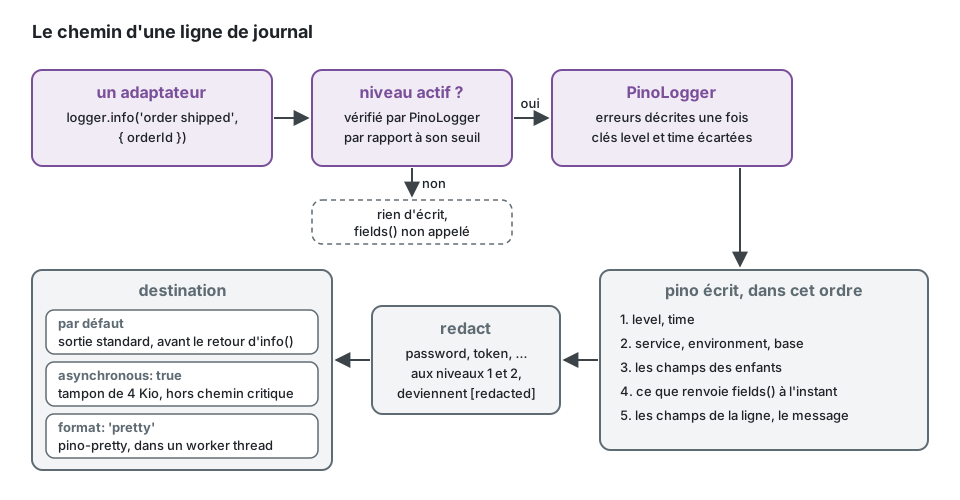
Corrélation. fields est lu à chaque ligne écrite, par le mixin de pino : aucun point
d'appel ne passe d'identifiant. traceLogFields(scope) renvoie les identifiants de trace et de
span à l'intérieur d'un span, et, à l'intérieur de la portée d'exécution, l'identifiant de
corrélation, l'identifiant de causalité, l'origine, l'acteur et le tenant. Ce package ne
dépend pas du package de traçage : toute fonction () => LogFields convient,
() => logFieldsOf(scope.current()) comprise. Une fonction qui lève une exception ne donne aucun
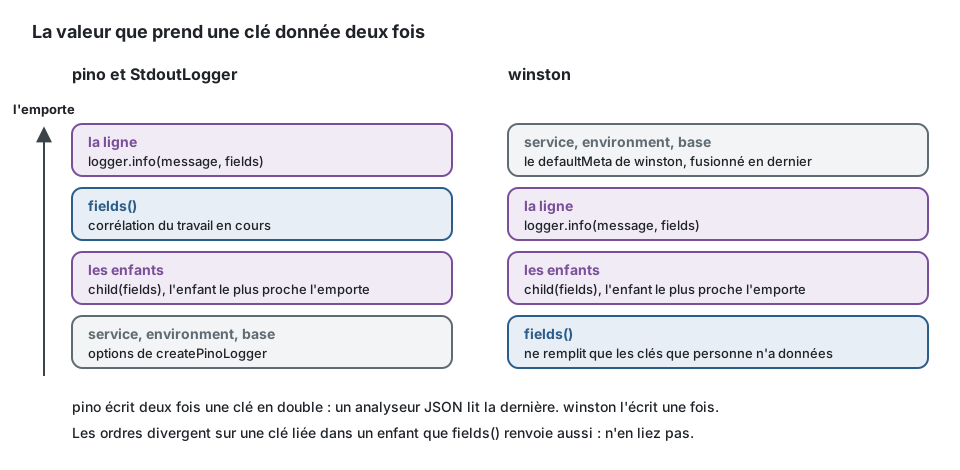
champ, jamais une ligne perdue. Les champs de la ligne l'emportent sur fields, qui l'emportent
sur ceux d'un enfant : pino écrit d'abord les liaisons d'un enfant, puis ce que renvoie le mixin,
si bien qu'une clé donnée par les deux est écrite deux fois et qu'un analyseur JSON lit celle de
fields. StdoutLogger les ordonne de la même façon ; @ddd-ts-kit/winston non (là, un enfant
l'emporte sur fields). Ne liez pas dans un enfant une clé que fields renvoie.
Une instance à vous. Le projet qui configure déjà pino continue de le faire, et prend les pièces qu'il veut :
import { CREDENTIAL_KEYS, type ExecutionScope } from '@ddd-ts-kit/kernel';import { pino } from 'pino';import { PinoLogger, correlationMixin, credentialRedaction } from '@ddd-ts-kit/pino';import { traceLogFields } from '@ddd-ts-kit/tracing';
declare const scope: ExecutionScope; // celle que crée la racine de composition
const instance = pino({  mixin: correlationMixin(() => traceLogFields(scope)),  redact: credentialRedaction([...CREDENTIAL_KEYS, 'iban']),});
export const logger = new PinoLogger(instance);
createPinoLogger écrit level par son nom et le message sous message, comme le
StdoutLogger du package des aspects et comme @ddd-ts-kit/winston : un même tableau de bord
lit les trois. Une instance à vous garde les clés que vous lui avez données (msg et un niveau
numérique par défaut).
Journaliser depuis un adaptateur
Section intitulée « Journaliser depuis un adaptateur »Un adaptateur reçoit le Logger du noyau dans son constructeur, comme tout autre port, et
n'importe jamais ce package. Liez une fois, dans un enfant, ce que porte chaque ligne de
l'adaptateur ; mettez sur chaque ligne ce qui change d'un appel à l'autre. Les champs de
corrélation y sont déjà : fields les ajoute.
import type { Logger } from '@ddd-ts-kit/kernel';
interface Carrier {  readonly name: string;  book(orderId: string, weightGrams: number): Promise<string>; // le numéro de suivi}
export class CarrierGateway {  private readonly logger: Logger;
  constructor(    private readonly preferred: Carrier,    private readonly fallback: Carrier,    logger: Logger,  ) {    this.logger = logger.child({ context: 'shipping' }); // sur chaque ligne de cet adaptateur  }
  async book(orderId: string, weightGrams: number): Promise<string> {    try {      return await this.preferred.book(orderId, weightGrams);    } catch (error) {      // Traitée ici, pas relancée : elle vaut une ligne, avec l'erreur décrite par le logger.      this.logger.warn('carrier unavailable, booking with the fallback', {        orderId,        carrier: this.preferred.name,        error: error instanceof Error ? error : String(error),      });
      return this.fallback.book(orderId, weightGrams);    }  }}
Le message est une constante et les identifiants sont des champs : un tableau de bord compte les lignes par message, une recherche retrouve une commande par son champ, et aucune donnée personnelle ne se glisse dans le texte.
import type { Logger } from '@ddd-ts-kit/kernel';
declare const logger: Logger;declare const order: { readonly id: string; readonly customerEmail: string; readonly lines: readonly unknown[] };
// Au lieu de : un message distinct par commande, un courriel en clair, une recherche qui ne peut pas filtrer.logger.info(`order ${order.id} shipped to ${order.customerEmail}`);
// Écrivez : le même message à chaque fois, les identifiants en champs, rien de personnel.logger.info('order shipped', { orderId: order.id });
// Les champs coûteux à construire ne sont construits que si la ligne est écrite.if (logger.isLevelEnabled('debug')) {  logger.debug('order shipped, detail', { orderId: order.id, lineCount: order.lines.length });}
Une erreur que le code laisse passer (il la lève, ou la relance) n'est pas journalisée en
chemin : le bus, la route ou le job la remonte une fois à l'ErrorReporter, et les aspects
journalisent son type et son code. Ne journalisez une erreur que là où elle est traitée et
s'arrête, comme le fait le repli ci-dessus.
Mode développement
Section intitulée « Mode développement »createPinoLogger({ level: 'debug', format: 'pretty', fields: () => traceLogFields(scope) });[10:00:00.000] INFO: order shipped service: "shop-api" correlationId: "9f2c" context: "shipping"Le format pretty est le transport que pino documente pour pino-pretty : il tourne dans un
worker thread, il prend donc un descripteur de fichier ou un chemin comme destination, pas un
flux, et flush() attend le worker. Pour des lignes lisibles sur un flux à vous, construisez
l'instance sur pino-pretty utilisé comme flux, pino(options, pretty({ destination })), et
enveloppez-la dans new PinoLogger(instance). Gardez-le hors de la production : choisissez le
format par la configuration (LOG_FORMAT=pretty dans .env, json partout ailleurs).
Confidentialité
Section intitulée « Confidentialité »Les lignes de journal sont l'endroit où les données personnelles fuient : elles sont écrites
partout, lues par tout le monde et conservées longtemps. Trois choses sont faites dans
l'adaptateur, pour qu'aucun point d'appel n'ait à s'en souvenir. La liste des clés de secret, la
description d'une erreur et les deux marqueurs (CREDENTIAL_KEYS, describeError, REDACTED,
SCRUBBED_MESSAGE) sont ceux du noyau, partagés par tous les loggers du port.
Les secrets d'authentification sont masqués par le redact de pino lui-même, dans les champs
d'une ligne, d'un enfant et de fields de la même façon. La valeur de ces clés est remplacée par
[redacted], au premier niveau d'une ligne et un niveau en dessous (headers.authorization,
body.password) :
password, authorization, cookie, set-cookie, token, secret, apiKey, api_key,
access_token, refresh_token, accessToken, refreshToken, client_secret
redact: ['iban', 'ssn'] complète la liste. Les noms sont comparés exactement, casse comprise,
et rien n'est cherché plus profond qu'un niveau : journalisez la partie que vous visez, pas une
requête HTTP entière.
Une erreur passée en champ (logger.error('payment failed', { error }) : la LogValue du
port admet une Error) est écrite telle que la décrit describeError du noyau, de la même façon
depuis tous les loggers du port : sa classe en type, son code quand c'est une
DomainError, son message, sa propre stack, puis sa cause de la même façon, jusqu'à huit
niveaux. Chaque erreur d'une chaîne est écrite une fois : le sérialiseur standard de pino pour la
clé err replierait chaque cause dans le message et la pile de la première, aussi l'adaptateur
le désactive pour les lignes qui passent par le port. Les erreurs sont cherchées parmi les champs
de la ligne, pas à l'intérieur d'objets imbriqués.
Les messages des erreurs inattendues peuvent être retirés. Le message d'une erreur est le
premier endroit où apparaissent des données personnelles : un pilote cite la ligne qu'il a
refusée. Par défaut, il est gardé, parce qu'une ligne de journal qui dit [message removed] coûte
à chaque investigation. Avec une option, seuls survivent les messages que le projet a écrits
lui-même, ceux de ses DomainError ; classe, code, pile et cause restent pour les autres, et la
pile perd sa première ligne, qui répète le message :
createPinoLogger({ scrubMessages: true }); // ou new PinoLogger(instance, { scrubMessages: true })C'est le scrubMessages que prend chaque logger du port (StdoutLogger, pino, winston,
InMemoryLogger) et celui de @ddd-ts-kit/sentry, avec la même règle, le même
SCRUBBED_MESSAGE et le même compromis : activez-le quand les journaux sortent de vos mains ou
quand aucun opérateur ne doit y lire ces données. Ce que dit le message d'une ligne de journal
lui-même reste à votre charge : écrivez order shipped et mettez les identifiants dans des
champs.
Le kit lui-même ne confie jamais une erreur à un logger : l'aspect logged,
loggingMiddleware et le planificateur de jobs écrivent seulement errorType et errorCode
(identifyError du noyau), jamais un message, quoi que dise scrubMessages, et l'erreur va à
l'ErrorReporter. La description ci-dessus vaut pour l'erreur que votre propre code choisit de
journaliser : logger.error('payment failed', { error }).
| Port | pino | |
|---|---|---|
debug |
debug (20) |
|
info |
info (30) |
le seuil par défaut |
warn |
warn (40) |
|
error |
error (50) |
Le port n'a ni trace ni fatal : rien de ce qui passe par lui ne les utilise. Une ligne sous
le seuil coûte une comparaison : ses champs ne sont pas lus, et fields n'est pas appelé. Le
seuil d'une instance modifié en cours d'exécution (instance.level = 'debug') est suivi par
l'adaptateur et par ses enfants. isLevelEnabled(level) répond selon ce seuil : interrogez-le
avant de construire des champs coûteux.
child(fields) est un enfant pino : les champs sont sérialisés une fois, à la création de
l'enfant, et ne coûtent rien par ligne. Une clé liée deux fois (par un enfant et par son parent,
par un enfant et par fields, ou par l'un d'eux et par la ligne) est écrite deux fois sur la
ligne, comme le fait pino ; un analyseur JSON lit la dernière, dans cet ordre : service,
environment et base, les enfants du plus ancien au plus proche, fields, la ligne. level
et time font exception : un champ portant ce nom est écarté, pour qu'aucun champ ne contrefasse
l'en-tête d'une ligne.
flush(): Promise<void> se résout une fois que ce que pino avait mis en tampon a été confié à sa
destination : le worker d'un transport, ou le tampon d'une destination asynchrone. Il ne rejette
jamais. app.stop() l'appelle, en dernier, après l'arrêt des modules et le vidage du rapporteur
d'erreurs : l'arrêt journalise lui aussi. Sans l'application du package di, appelez-le
vous-même à cet endroit.
Le port appelle un vidage une fois, à l'arrêt, et ne précise pas ce qui est journalisé ensuite.
Ici le logger reste utilisable : une ligne journalisée après le vidage est écrite comme les
autres, et avec asynchronous: true elle attend dans le tampon le crochet de sortie de pino.
Performances
Section intitulée « Performances »Par défaut, chaque ligne est écrite sur la sortie standard avant le retour de l'appel. Rien n'est jamais perdu, et un lecteur lent de la sortie standard ralentit l'application.
asynchronous: true met 4 Kio en tampon et écrit hors du chemin critique
(pino.destination({ sync: false })), ce qui rend pino rapide sous charge. Le prix est ce qu'un
processus mort n'avait pas encore écrit. flush() écrit le tampon, de même que le propre crochet
de sortie de pino sur process.exit et sur une exception non interceptée. Un signal qui termine
le processus sans gestionnaire (SIGKILL, l'OOM killer du système, un SIGTERM
que personne n'écoute) perd jusqu'à 4 Kio des lignes les plus récentes, celles qui l'auraient
expliqué ; de même une sortie dans les premiers instants, avant l'ouverture de la destination.
Gardez le défaut, sauf si la journalisation apparaît dans un profil.
Une ligne coûte une copie d'objet de ses champs (erreurs décrites, clés d'en-tête écartées), puis
pino : environ 3 microsecondes en tout là où @ddd-ts-kit/winston en prend 7 (Node 24, un
enfant, quatre champs de corrélation, trois champs, un récepteur qui jette tout).
Le masquage est compilé par pino : une recherche par clé de secret au premier niveau de la ligne,
et un passage par joker pour le niveau en dessous, dont la fonction de censure regarde le nom de
chaque clé. Un chemin à joker par clé serait la façon évidente de l'écrire et coûte dix fois
plus : mesuré sur pino 10, treize d'entre eux font passer une ligne d'environ une microseconde à
environ neuf. Les appels de journalisation ne lèvent jamais d'exception : des champs qui ne
peuvent être ni lus ni sérialisés (un accesseur qui lève une exception) donnent la ligne sans
eux, marquée logError: "unserializable fields".
Lequel choisir
Section intitulée « Lequel choisir »Prenez StdoutLogger du package des aspects quand des lignes JSON sur la sortie standard vous
suffisent : aucune dépendance, la même forme de ligne. Prenez pino quand le volume de journaux
compte, quand le framework parle déjà pino (Fastify), ou quand vous voulez ses transports.
Prenez @ddd-ts-kit/winston quand l'équipe utilise déjà des transports et des formats winston.
Les trois implémentent un même port et sont tenus par une même suite de contrat : en changer
tient en une ligne de la racine de composition.
Nest a son propre LoggerService, utilisé par le framework pour ses propres messages et par
new Logger(context) dans les classes Nest. Le code applicatif du kit n'en a jamais besoin : les
gestionnaires et les adaptateurs reçoivent le Logger du noyau. Pour faire passer ce que Nest
journalise lui-même par la même instance, donnez-lui un pont de quelques lignes ; le kit n'en
livre aucun, car il lierait ce package à Nest :
const nest = logger.child({ context: 'nest' });const bridge: LoggerService = {  log: (message: unknown) => nest.info(String(message)),  warn: (message: unknown) => nest.warn(String(message)),  error: (message: unknown) => nest.error(String(message)),  debug: (message: unknown) => nest.debug(String(message)),};
const app = await NestFactory.create(AppModule, { logger: bridge });
nestjs-pino est l'alternative quand les classes Nest journalisent beaucoup : donnez-lui
l'instance pino que vous avez construite, et enveloppez la même instance dans
new PinoLogger(instance) pour le kit.
Dans un test
Section intitulée « Dans un test »Rien de ce package : l'application de test lie l'InMemoryLogger du noyau, et ses entries
sont des données. Pour tenir un autre adaptateur du port au même comportement, lancez le
contrat :
import { beforeEach, describe, expect, it } from 'vitest';import { LOG_LEVELS } from '@ddd-ts-kit/kernel';import { createPinoLogger } from '@ddd-ts-kit/pino';import { loggerContract, type LoggedLine } from '@ddd-ts-kit/testing/contracts';
loggerContract({ describe, it, expect, beforeEach }, {  name: 'PinoLogger',  createLogger: (setup) => { // { level, fields, scrubMessages }    const written: string[] = [];    const logger = createPinoLogger({ ...setup, destination: { write: (line) => written.push(line) } });
    return { logger, lines: () => written.map((line) => lineOf(JSON.parse(line))) };  },});
/** Une ligne écrite telle que le contrat la lit : le niveau par son nom, le message, les autres champs. */function lineOf({ level, message, time: _time, ...fields }: Record<string, unknown>): LoggedLine {  const known = LOG_LEVELS.find((one) => one === level);
  if (known === undefined) {    throw new Error(`Not a level of the port: ${String(level)}`);  }
  return { level: known, message: String(message), fields };}