
Moteurs d'autorisation : dans le processus ou un service dédié
Résumé. Le kit décide des permissions derrière un seul port, Authorizer, et livre trois
implémentations qui tournent dans le processus : les rôles (RBAC), les politiques (policies) sur
attributs (ABAC) et les relations à la manière de Zanzibar (ReBAC). Des moteurs dédiés existent
pour le même travail : OpenFGA et SpiceDB pour les relations, Cedar et Open Policy Agent pour les
politiques. Cette page les compare et dit quand passer de l'authorizer dans le processus à un
service vaut ce qu'il coûte. Pour les relations, le kit tient les deux bouts aux mêmes suites de
contrat : un magasin de tuples dans le PostgreSQL du projet (le port et sa suite sont livrés avec
@ddd-ts-kit/auth, l'application d'exemple en a un adaptateur Knex, et init --authz rebac
démarre un projet sur le magasin en mémoire avec une note pour le remplacer), et
@ddd-ts-kit/openfga, les deux mêmes ports sur un serveur
OpenFGA, son modèle généré à partir du même schéma. Les autres services disposent d'une suite de
contrat à laquelle tenir un adaptateur.
Ce qui est choisi
Section intitulée « Ce qui est choisi »Un cas d'usage déclare la permission qu'il exige (appointment.cancel), un middleware
interroge l'Authorizer avant que le gestionnaire (handler) ne s'exécute, et une requête de
recherche demande un périmètre d'accès. La page de concept
authentification et autorisation explique
les trois modèles. Le choix porte ici sur l'endroit où la décision est calculée et sur celui où
vivent ses données :
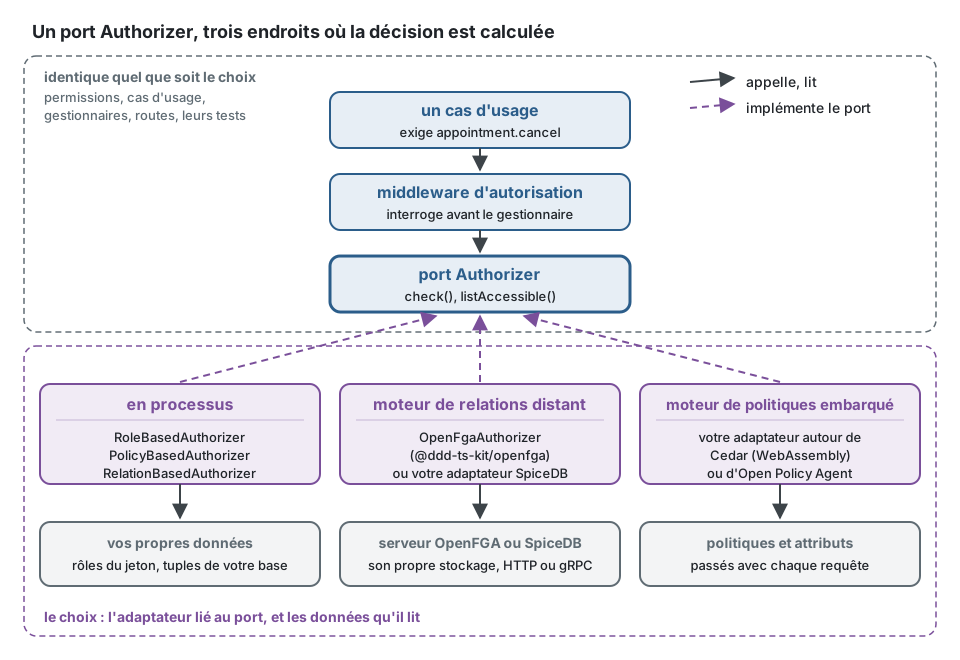
Les gestionnaires, les permissions, les routes et les tests des gestionnaires ne changent pas
avec ce choix. L'adaptateur et les données dont il a besoin, si. Le port tient en deux méthodes :
chaque moteur de cette page répond à check ; listAccessible est facultative, et absente là où
le moteur ne sait pas énumérer (Cedar, OPA sans évaluation partielle), si bien que demander un
périmètre à un tel adaptateur échoue bruyamment. Authorizer lui-même est une classe abstraite,
le jeton d'injection qu'un adaptateur étend ; l'interface ci-dessous n'en montre que la forme :
import type { AccessScope, CheckRequest, Decision, ListRequest } from '@ddd-ts-kit/auth';
// La forme d'Authorizer, tirée de @ddd-ts-kit/auth : ce que demandent un middleware et un gestionnaire de recherche.export interface AuthorizerShape {  check(request: CheckRequest): Promise<Decision>; // { allowed: true } ou { allowed: false, reason: 'NO_RELATION' }  listAccessible?(request: ListRequest): Promise<AccessScope>; // all, none, des identifiants ou un filtre pour le port de lecture}
Comparaison
Section intitulée « Comparaison »Les faits concernant les tiers ont été vérifiés le 2026-10-10 auprès des sources listées à la fin.
| Kit, dans le processus | OpenFGA | SpiceDB | Cedar | Open Policy Agent | |
|---|---|---|---|---|---|
| Modèle | RBAC, ABAC ou ReBAC, superposés si on le souhaite | ReBAC d'après Zanzibar, avec des conditions sur les tuples | ReBAC d'après Zanzibar, avec des caveats | des politiques sur le principal, l'action, la ressource et le contexte : RBAC et ABAC, les relations par des hiérarchies d'entités | des politiques à usage général sur une entrée et des données JSON |
| Langage | TypeScript : une table des rôles, des fonctions de politique, un DSL de schéma | un DSL de modélisation (aussi en JSON) | un langage de schéma | le langage de politiques Cedar, avec un schéma et un validateur | Rego |
| Déploiement | une bibliothèque dans le processus de l'API | un serveur avec son propre stockage (PostgreSQL, MySQL, SQLite), HTTP et gRPC | un serveur avec son propre stockage (PostgreSQL, CockroachDB, Spanner, MySQL), gRPC et HTTP | une bibliothèque (Rust, avec une version WebAssembly pour JavaScript) ; ou le service hébergé Amazon Verified Permissions | un serveur, un sidecar ou une bibliothèque ; une cible WebAssembly existe |
| Où vivent les données | votre base de données, dans la transaction de la modification quand vous écrivez des tuples | le stockage du moteur, écrit par son API | le stockage du moteur, écrit par son API | vous passez les entités avec chaque requête (ou stockez les politiques dans le service hébergé) | poussées ou tirées dans le moteur, ou passées en entrée |
| Cohérence | celle de votre stockage ; aucun jeton de cohérence | une préférence par requête entre latence plus faible et cohérence plus forte | des niveaux par requête, avec des ZedTokens pour « au moins aussi frais que » | la requête est évaluée sur ce que vous passez | celle des données que vous avez chargées |
| Lister « ce que cet acteur peut voir » | constant pour les rôles ; indisponible pour les politiques sur attributs ; expansion inverse pour les tuples, bornée | ListObjects | LookupResources | pas une fonction du moteur : il évalue une requête à la fois (l'évaluation partielle est la piste de recherche associée) | pas intégré : l'évaluation partielle peut produire un filtre, au prix d'un travail |
| Licence | MIT (ce dépôt) | Apache-2.0 | Apache-2.0 | Apache-2.0 | Apache-2.0 |
| Gouvernance | ce projet | CNCF incubating (depuis octobre 2025), lancé chez Auth0/Okta | AuthZed, une entreprise ; pas un projet de la CNCF | CNCF sandbox (accepté en octobre 2025), lancé chez AWS | CNCF graduated |
| Dernière version vue | sans objet | v1.22.0 (2026-10-06) | v1.56.2 (2026-09-11) | 4.13.0 (2026-09-15) | v1.21.1 (2026-09-29) |
Non vérifié pour cette page : la liste exacte des stockages que chaque serveur prend en charge aujourd'hui, les noms actuels des options de cohérence, et l'état des fonctions de liste ou d'évaluation partielle dans Cedar et OPA. Ils sont donnés d'après la documentation des projets telle que l'auteur la connaît, et doivent être confirmés dans la documentation liée avant toute décision.
Critères de choix
Section intitulée « Critères de choix »- La forme des droits. Des droits qui suivent les fonctions des personnes vont avec les rôles. Des droits qui dépendent de propriétés (le statut d'un rendez-vous, le temps avant qu'il commence) vont avec les politiques. Des droits par élément et partagés (le praticien de ce calendrier, un assistant qui y est délégué, une clinique qui possède de nombreux calendriers) vont avec les relations.
- Les listes. « Montrer les rendez-vous que je peux voir » doit devenir un filtre de requête. Demandez d'abord à chaque moteur comment il répond à une liste, à vos volumes.
- La cohérence après une modification. Quand un patient est retiré d'un rendez-vous, combien de temps l'accès peut-il durer encore ? Dans le processus avec des tuples SQL, le tuple est validé avec la modification. Avec un moteur distant, l'écriture est une seconde étape, par l'outbox, et les lectures peuvent être en retard à moins de transporter un jeton de cohérence.
- Combien de systèmes posent la question. Une API qui s'interroge sur ses propres données n'a pas besoin d'un service partagé. Plusieurs services, en plusieurs langages, qui s'interrogent sur les mêmes objets, si.
- Qui écrit les règles. Des développeurs en TypeScript, ou une équipe sécurité dans un langage de politiques, avec sa propre relecture et ses propres outils.
- L'exploitation. Un moteur distant est un service à état sur le chemin de chaque requête HTTP : latence, disponibilité, sauvegardes, montées de version, et un mode de défaillance à décider (refuser quand il est indisponible).
Ce que le kit prend en charge et a vérifié
Section intitulée « Ce que le kit prend en charge et a vérifié »D'après @ddd-ts-kit/auth :
- Trois authorizers, un port, une suite de contrat.
RoleBasedAuthorizer,PolicyBasedAuthorizeretRelationBasedAuthorizer(point d'entrée/rebac) implémententAuthorizeret passentauthorizerContract. Chacun refuse l'acteur anonyme, et un acteur système n'a aucun droit à moins que le modèle ne lui en donne un. - La superposition. La façade d'accès interroge les politiques d'instance, puis l'authorizer : « des rôles pour les actions, des politiques pour les quelques règles par élément » ne demande aucun magasin de tuples, et le README en fait le point de départ.
- Les relations. Un DSL de schéma avec union, intersection, exclusion et tuple-to-userset,
un
defineSchemaqui valide, une protection contre les cycles et une limite de profondeur (16 par défaut, avec la réponseDEPTH_EXCEEDED, jamais une supposition), unexpandqui trace une vérification pour le débogage, une enveloppe du magasin qui refuse les tuples que le schéma ne décrit pas. Une version réduite du schéma de l'application d'exemple, et une vérification :
import { definePermissions } from '@ddd-ts-kit/auth';import { defineSchema, from, InMemoryRelationTupleStore, RelationBasedAuthorizer, union } from '@ddd-ts-kit/auth/rebac';import type { Actor } from '@ddd-ts-kit/kernel';
const schedulingPermissions = definePermissions('scheduling', {  'appointment.cancel': { description: 'Cancel an appointment' },});
// Qui est quoi pour quel élément : un cabinet a des responsables, un calendrier son titulaire et ses assistants.const schema = defineSchema({  user: {},  practice: { relations: { manager: ['user'] }, permissions: { manage: union('manager') } },  calendar: {    relations: { holder: ['user'], assistant: ['user'], practice: ['practice'] },    permissions: { run: union('holder', 'assistant', from('practice', 'manage')) },  },  appointment: {    relations: { patient: ['user'], calendar: ['calendar'] },    permissions: { change: union('patient', from('calendar', 'run')) },  },});
const tuples = new InMemoryRelationTupleStore();const authorizer = new RelationBasedAuthorizer({  schema,  store: tuples,  mapping: { appointment: { [schedulingPermissions['appointment.cancel'].id]: 'change' } },});
await tuples.write([  { object: 'calendar:dr-grace', relation: 'assistant', subject: 'user:ada' },  { object: 'appointment:42', relation: 'calendar', subject: 'calendar:dr-grace' },  { object: 'appointment:42', relation: 'patient', subject: 'user:bob' },]);
const ada: Actor = { id: 'ada', type: 'user', roles: [], attributes: {} };
// { allowed: true } : ada est assistante du calendrier qui porte le rendez-vous 42.export const decision = await authorizer.check({ actor: ada, permission: schedulingPermissions['appointment.cancel'], resource: { type: 'appointment', id: '42' },});- Les tuples dans la transaction. Avec un magasin de tuples adossé à SQL, le gestionnaire écrit le tuple dans l'unité de travail de la commande : le rendez-vous et sa relation sont validés ensemble. Le package contient un exemple testé, avec le cas du retour arrière (rollback).
- Changer de modèle change l'adaptateur donné au module d'autorisation, et ses données. Des rôles aux relations, les cas d'usage qui ne nommaient aucune ressource doivent en nommer une.
Ce que le README déclare non implémenté, par comparaison avec Zanzibar :
- aucun jeton de cohérence : chaque vérification lit le magasin tel qu'il est à cet instant ;
- ni caveats ni tuples conditionnels : une condition sur des attributs relève d'une politique ;
- ni évaluation distribuée, ni cache des vérifications, ni parallélisation : l'évaluation est séquentielle, dans le processus ;
- ni sujet public générique (wildcard), ni versionnement du schéma ou outil de migration, ni API de surveillance (watch) ;
expandest la trace d'une vérification, pas l'arbre de usersets de Zanzibar ;- lister par expansion inverse coûte une lecture du magasin par sujet atteint et lève une erreur au-delà d'une limite (10000 sujets atteints par défaut) plutôt que de rendre une liste partielle. Ce n'est pas un index de recherche.
OpenFGA. @ddd-ts-kit/openfga implémente le magasin de
tuples et l'authorizer sur un serveur OpenFGA, avec le SDK officiel (0.9.7) comme dépendance
de pair optionnelle. Le modèle d'autorisation est généré à partir du schéma de relations du
projet (authorizationModelOf), écrit quand il diffère (ensureAuthorizationModel) et comparé
(modelDrift) : une seule source de vérité. Les deux adaptateurs passent les suites de contrat
des adaptateurs dans le processus, en mémoire et contre openfga/openfga v1.22.0 dans le job
d'intégration. init ne le câble pas encore : liez les deux adaptateurs à la main dans la
plateforme, comme le montre le README du package :
import type { PermissionMapping, Schema } from '@ddd-ts-kit/auth/rebac';import { ensureAuthorizationModel, OpenFgaAuthorizer, OpenFgaRelationTupleStore } from '@ddd-ts-kit/openfga';import { openFgaClient } from '@ddd-ts-kit/openfga/sdk';
declare const relationshipSchema: Schema; // le defineSchema(...) que lisait l'authorizer dans le processusdeclare const permissionMapping: PermissionMapping; // inchangé lui aussideclare const config: { readonly openfga: { readonly url: string; readonly storeId: string } };
const client = openFgaClient({ apiUrl: config.openfga.url, storeId: config.openfga.storeId });
// Au déploiement ou au démarrage : le modèle du magasin devient celui que génère le schéma.const { modelId, changes } = await ensureAuthorizationModel(client, relationshipSchema);console.log(`authorization model ${modelId}`, changes);
// Les deux mêmes ports, liés au serveur au lieu de la table du projet.export const tuples = new OpenFgaRelationTupleStore(client, relationshipSchema);export const authorizer = new OpenFgaAuthorizer({ client, mapping: permissionMapping, listObjectsLimit: 1000 });
SpiceDB correspond à CheckPermission, LookupResources et WriteRelationships derrière les
mêmes ports ; aucun adaptateur n'est livré. init --authz custom génère un squelette
d'adaptateur, sa spec de contrat et le fichier des permissions. Cedar et OPA ne sont pas
mentionnés dans le dépôt : en brancher un passe par le même port, sans rien de préparé.
Le magasin de tuples PostgreSQL ou OpenFGA
Section intitulée « Le magasin de tuples PostgreSQL ou OpenFGA »Les deux contiennent les mêmes tuples et répondent aux mêmes ports ; le schéma du projet est la source unique des deux. Ce qui diffère, c'est l'endroit où s'exécute l'évaluation, et le fait qu'un tuple soit validé ou non avec la modification qu'il décrit.
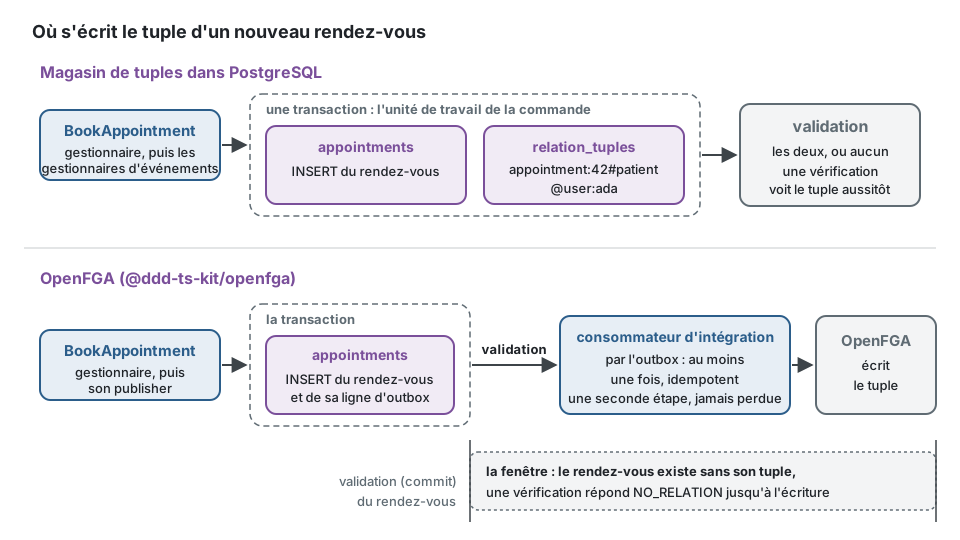
Quel que soit celui qui écrit le tuple, les gestionnaires nomment un fait de leur contexte, jamais le modèle : l'adaptateur d'un port formulé dans les mots du contexte connaît les tuples, et la liaison décide où ils vont.
// À éviter : le gestionnaire connaît le modèle d'autorisation, et appelle un service dans la transactionasync execute(command: BookAppointment): Promise<string> { const appointment = Appointment.book(this.ids.next(), command.booking); await this.appointments.save(appointment); await this.openFga.write({ writes: [{ object: `appointment:${appointment.id}`, relation: 'patient', user: `user:${command.actor.id}` }] }); return appointment.id;}import type { RelationTupleStore } from '@ddd-ts-kit/auth/rebac';
// application/ports/scheduling-relationships.port.ts : ce que la plateforme doit savoir, dans les mots du contexte.export abstract class SchedulingRelationships { abstract recordAppointment(appointment: { readonly appointmentId: string; readonly calendarId: string; readonly patientId: string; }): Promise<void>;}
// infrastructure/persistence/tuple-scheduling-relationships.repository.ts : l'adaptateur connaît le modèle.export class TupleSchedulingRelationships implements SchedulingRelationships { constructor(private readonly tuples: RelationTupleStore) {}
async recordAppointment({ appointmentId, calendarId, patientId }: Parameters<SchedulingRelationships['recordAppointment']>[0]): Promise<void> { await this.tuples.write([ { object: `appointment:${appointmentId}`, relation: 'patient', subject: `user:${patientId}` }, { object: `appointment:${appointmentId}`, relation: 'calendar', subject: `calendar:${calendarId}` }, ]); }}Dans l'application d'exemple, le gestionnaire de l'événement du domaine AppointmentBooked
appelle recordAppointment : les événements du domaine sont distribués dans l'unité de travail
de la commande, donc avec le magasin Knex les tuples sont validés avec le rendez-vous. Lié à
OpenFgaRelationTupleStore, l'écriture est un appel distant qui ne peut pas entrer dans la
transaction, et elle ne doit pas se perdre : un tuple qui n'arrive jamais, c'est un patient qui
n'accède jamais à son rendez-vous. Le même appel passe donc dans le consommateur d'un événement
d'intégration publié par l'outbox (ou d'une commande ou d'un job mis en file de la même façon) :
livré au moins une fois, le consommateur idempotent. Un gestionnaire de phase after-commit ne le
remplace pas : il s'exécute au plus une fois, un échec est seulement journalisé et signalé, et un
arrêt brutal entre la validation et l'appel le perd (voir
quand un événement du domaine est traité).
L'adaptateur et le port ne changent pas.
| Magasin de tuples dans PostgreSQL | OpenFGA (@ddd-ts-kit/openfga) |
|
|---|---|---|
| Où vivent les tuples | une table du projet, écrite dans la transaction de la commande | le stockage du serveur OpenFGA, par son API |
| Un tuple et son agrégat | validés ensemble, ou pas du tout | deux étapes : l'agrégat est validé, puis le tuple est écrit (par l'outbox, au moins une fois, idempotent) |
| Évaluation | dans le processus de l'API, séquentielle, bornée par une limite de profondeur | dans le serveur, parallèle, avec ses caches |
| Listes | expansion inverse, une lecture par sujet atteint, refusée au-delà de 10000 | ListObjects, évalué dans le serveur ; plafonné par OPENFGA_LIST_OBJECTS_MAX_RESULTS (1000) et OPENFGA_LIST_OBJECTS_DEADLINE (3 s), qui coupent la liste sans erreur : l'adaptateur refuse une réponse au plafond, et une coupure par le délai n'est pas visible |
| Cohérence | celle de la base de données : ce qui est validé est vu | une préférence par requête ; le kit ne transporte aucun jeton |
| Partagé avec d'autres services | non : les données d'une seule application | oui : n'importe quel service, dans n'importe quel langage, interroge le même serveur |
| Exploitation | rien de plus à faire tourner | un service à état sur le chemin de chaque requête HTTP, son stockage, ses montées de version |
| Modèle | le schéma, en TypeScript | généré à partir du même schéma ; dérive vérifiée |
Choisissez d'abord le magasin PostgreSQL : il est cohérent par construction et ne coûte rien à faire tourner. Passez à OpenFGA quand une mesure le dit : un acteur qui atteint plus de tuples que l'expansion inverse ne devrait en parcourir, des listes qui doivent être rapides sur de grandes hiérarchies partagées, ou un second service, dans n'importe quel langage, qui doit poser les mêmes questions sur les mêmes objets. Le passage est une liaison et une migration des tuples (les lire dans la table, les écrire dans le magasin), pas un changement des cas d'usage.
Limites, et quand ne pas l'utiliser
Section intitulée « Limites, et quand ne pas l'utiliser »Les authorizers dans le processus cessent de convenir quand :
- un acteur atteint plus de quelques milliers de tuples et que des listes sont nécessaires (la borne que le README donne lui-même pour l'expansion inverse) ;
- plusieurs services doivent partager une même vue de qui peut accéder à quoi ;
- vous avez besoin de jetons de cohérence, de tuples conditionnels ou d'un flux de surveillance (watch) ;
- les règles doivent être possédées et auditées hors du code de l'application.
Un moteur de relations dédié est le mauvais premier pas quand les droits sont une table des rôles et trois règles de propriété. Il ajoute une dépendance à état à chaque requête HTTP et fait des écritures un processus en deux étapes : l'agrégat est validé, puis le tuple est écrit, et pendant un court moment les deux sont en désaccord. Décider de ce qu'une requête voit dans cette fenêtre est votre travail.
Un moteur de politiques (Cedar, OPA) ne stocke pas les relations à votre place et ne répond pas nativement aux listes. Il convient quand la décision dépend d'attributs que vous pouvez passer avec la requête, ou quand un seul langage de politiques doit couvrir les applications et l'infrastructure. Pour le partage par élément à grande échelle, il faut d'abord aller chercher les données, et c'est la partie difficile.
Amazon Verified Permissions est un service Cedar hébergé par un seul fournisseur de cloud : un appel distant et une dépendance envers ce fournisseur. Ses limites et ses prix n'ont pas été vérifiés pour cette page.
Aucun ne remplace les invariants. « Un rendez-vous ne peut pas être annulé deux fois » n'est pas une permission. Voir invariants, permissions et validation.
Recommandation selon la situation
Section intitulée « Recommandation selon la situation »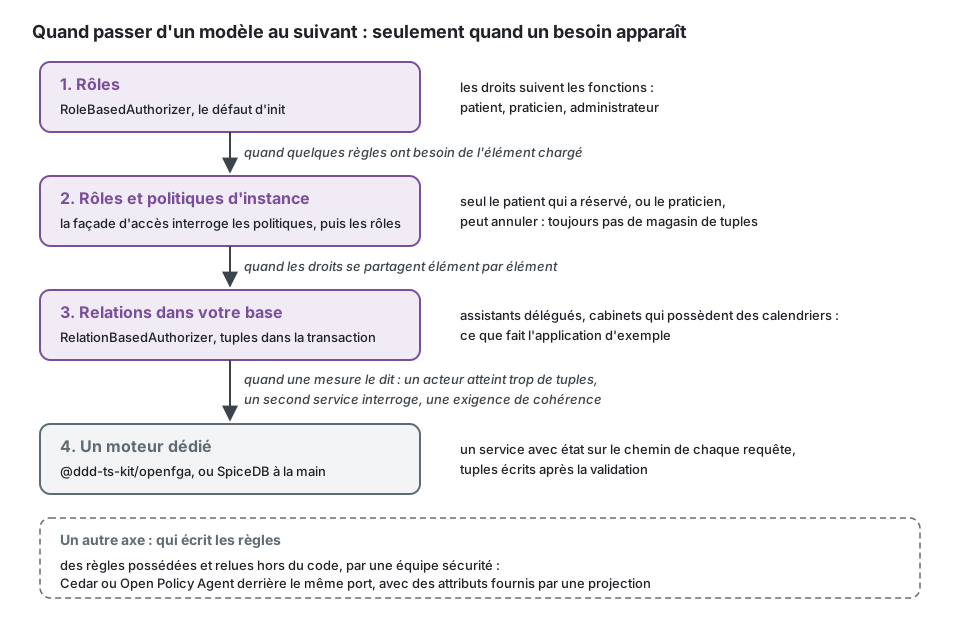
| Situation | Choix |
|---|---|
| Nouveau projet, les droits suivent les fonctions des personnes (patient, praticien, administrateur) | les rôles dans le processus, le choix par défaut d'init |
| Quelques règles par élément : seul le patient qui a réservé ou le praticien peut annuler | les rôles plus des politiques d'instance ; toujours pas de magasin de tuples |
| Partage par élément : assistants délégués, cliniques qui possèdent des calendriers | les relations dans le processus, avec un magasin de tuples SQL écrit dans le gestionnaire |
| Listes sur de grandes hiérarchies partagées, ou expansion inverse qui atteint sa limite | d'abord une projection des identifiants accessibles ; ensuite @ddd-ts-kit/openfga derrière le port (son ListObjects est plafonné lui aussi, 1000 objets par défaut, refusé au plafond) ou SpiceDB à la main |
| Plusieurs services et langages qui s'interrogent sur les mêmes objets | OpenFGA (@ddd-ts-kit/openfga) ou SpiceDB comme service partagé ; choisir selon les besoins de cohérence, le stockage et la gouvernance |
| Règles sur attributs possédées par une équipe sécurité, relues comme des politiques | Cedar (embarqué) ou OPA, derrière le port, avec des attributs fournis par une projection |
| Déjà chez un fournisseur de cloud, sans vouloir faire tourner de moteur | Amazon Verified Permissions, en acceptant l'appel distant et la dépendance au fournisseur |
Quand passer à l'étape suivante, en une phrase : quand un besoin mesuré existe (la taille des listes, un second consommateur des mêmes droits, une exigence de cohérence que le magasin ne peut pas donner), pas avant. Consignez le choix dans un enregistrement de décision : il change les modes de défaillance.
packages/auth/README.mdde ce dépôt : « Choosing a model », « Relationships », « Keeping relationships in sync », « Testing » ;packages/openfga/README.md.- Ruoming Pang et al., « Zanzibar: Google's Consistent, Global Authorization System », USENIX ATC 2019.
- OpenFGA : https://openfga.dev/docs et https://github.com/openfga/openfga/releases (v1.22.0, Apache-2.0) ; incubation à la CNCF : https://www.cncf.io/blog/2025/11/11/openfga-becomes-a-cncf-incubating-project/
- SpiceDB : https://authzed.com/docs/spicedb et https://github.com/authzed/spicedb/releases (v1.56.2, Apache-2.0).
- Cedar : https://docs.cedarpolicy.com et https://github.com/cedar-policy/cedar/releases (4.13.0, Apache-2.0) ; CNCF : https://www.cncf.io/projects/cedar/ ; la version JavaScript : https://www.npmjs.com/package/@cedar-policy/cedar-wasm
- Amazon Verified Permissions : https://docs.aws.amazon.com/verifiedpermissions/
- Open Policy Agent : https://www.openpolicyagent.org/docs et https://github.com/open-policy-agent/opa/releases (v1.21.1, Apache-2.0).
- Niveaux de maturité de la CNCF lus dans les données du landscape de la CNCF (https://github.com/cncf/landscape), vérifiés le 2026-10-10.
Voir aussi
Section intitulée « Voir aussi »- Authentification et autorisation
- L'acteur et la portée d'exécution
- Invariants, permissions et validation
- Identité
- Outbox transactionnelle : comment une écriture distante de tuple reste fiable
- Configuration :
stack.authz