
Travailler en parallèle sans collisions
Résumé. Plusieurs personnes, ou plusieurs agents de code, peuvent construire un même projet en même temps si le travail est découpé le long des deux coutures que l'architecture a déjà : le contexte délimité (bounded context) et le cas d'usage vertical. Presque tout ce qui est à l'intérieur d'un contexte lui est privé et peut être écrit en parallèle sans risque. Une courte liste de fichiers est partagée par construction (la configuration, les barrels et les documents générés, la racine de composition, les migrations, le langage publié d'un amont) et doit être modifiée en séquence. Ce guide liste les deux, explique les worktrees, l'ordre de fusion et qui régénère quoi, et se termine par un plan concret : quatre contextes d'une application de prise de rendez-vous construits par quatre workers après un amorçage commun.
Deux façons de découper
Section intitulée « Deux façons de découper »Par contexte délimité. Un worker, un contexte. L'arborescence fermée met tout ce dont un
contexte a besoin sous src/contexts/<context>/, et les règles interdisent d'atteindre un autre
contexte autrement que par son langage publié. Deux workers dans deux contextes modifient donc
des répertoires disjoints.
Par cas d'usage vertical, à l'intérieur d'un contexte. Une commande ou une requête, de bout en
bout : son dossier sous application/commands/ ou application/queries/, sa route, ses specs.
Deux cas d'usage d'un même contexte partagent le fichier de l'agrégat et le barrel généré du
contexte, ils entrent donc en conflit plus souvent que deux contextes. Ne parallélisez à
l'intérieur d'un contexte qu'une fois la forme de l'agrégat stabilisée.
Ne découpez pas par couche (« tu écris le domaine, j'écris les gestionnaires ») : chaque moitié est intestable tant que l'autre n'existe pas, et les deux se rencontrent dans chaque fichier.
Ce qui peut se faire en parallèle, et ce qui doit être séquencé
Section intitulée « Ce qui peut se faire en parallèle, et ce qui doit être séquencé »| Fichier ou zone | Écrit par | En parallèle ? | Comment s'y prendre |
|---|---|---|---|
src/contexts/<A>/** et src/contexts/<B>/** |
des workers différents | oui | disjoints par construction |
| deux dossiers de cas d'usage d'un même contexte | des workers différents | en grande partie | ils se rencontrent dans l'agrégat, le barrel et le fichier des routes : fusionnez souvent |
ddd-ts-kit.config.json |
init, generate context, generate service, generate worker, generate adr --deviation |
non | créez tous les contextes et toutes les relations à l'amorçage ; les changements ultérieurs un par un, par le propriétaire de la plateforme |
src/platform/compose-application.ts, src/platform/platform.module.ts, src/platform/platform-test.module.ts |
generate context (la racine de composition), generate gateway (les deux modules, dans le style déclaré), des modifications à la main |
non | les régions d'enregistrement sont écrites entre des marqueurs ; deux branches qui ajoutent chacune un contexte les touchent toutes les deux |
les registres de la plateforme : src/platform/database/schema.ts (avec Prisma, prisma/schema.prisma), src/platform/auth/permissions.ts, src/platform/auth/role.ts, src/platform/auth/access-policies.ts (style explicite), src/platform/audit/audited-events.ts, src/platform/job-settings.ts, les attributions sous src/platform/auth/, et l'utilitaire src/platform/resilience/own-policy.ts |
generate context, generate repository (le premier d'un contexte ; chacun avec Prisma), generate command --aggregate sur un agrégat qui n'a pas encore de repository, generate route-group --role avec un nouveau rôle, generate policy (style explicite), generate integration-event, generate job, generate adapter (le premier d'un projet câblé sur tsyringe) |
non | lancez ces générateurs sur le tronc avant que les workers ne commencent ; generate --help --json dit quelles sortes écrivent des fichiers partagés (writesShared) et lesquels |
src/main.ts |
des modifications à la main | non | le propriétaire de la plateforme |
test/architecture/extractable.spec.ts, knip.json (le premier contexte) |
init, generate context |
non | de même : écrits avec chaque contexte |
<context>.declarations.ts (le barrel, avec ce qui est injecté dans chaque constructeur), <context>.dependencies.ts en mode découverte |
chaque generate dans ce contexte, docs, et npm run dev |
par contexte | dérivés : ne jamais fusionner à la main, régénérer (ci-dessous) |
docs/context-map.md, les listes générées de chaque CONTEXT.md |
ddd-ts-kit docs, chaque generate |
non, mais peu coûteux | dérivés : régénérer après la fusion |
openapi/*.yaml, docs/integration/asyncapi.yaml, docs/integration/event-catalog.md |
npm run docs:generate |
non, mais peu coûteux | dérivés et déterministes : régénérer après la fusion |
.dependency-cruiser.cjs |
depcruise-config --write, generate context |
non, mais peu coûteux | dérivé de la configuration : régénérer |
| les migrations de base de données | l'outillage de l'ORM | non | un schéma par contexte garde les tables séparées, mais la séquence des migrations est une seule liste : numérotez au moment de la fusion |
le published-language/ d'un amont |
le propriétaire de l'amont, et generate gateway lancé pour un consommateur (le contrat de lecture) |
non pour ses consommateurs | fusionnez d'abord le contrat ; les consommateurs partent de lui |
src/shared-kernel/ |
les copropriétaires | non | rare par conception ; un changement à la fois |
package.json, le fichier de verrouillage |
quiconque ajoute une dépendance | non | ajoutez les dépendances à l'amorçage ou dans un changement dédié |
Le principe derrière ce tableau : un fichier est sûr quand un seul worker en est propriétaire, et un fichier dérivé n'est jamais un problème de fusion tant que personne n'essaie de le fusionner.
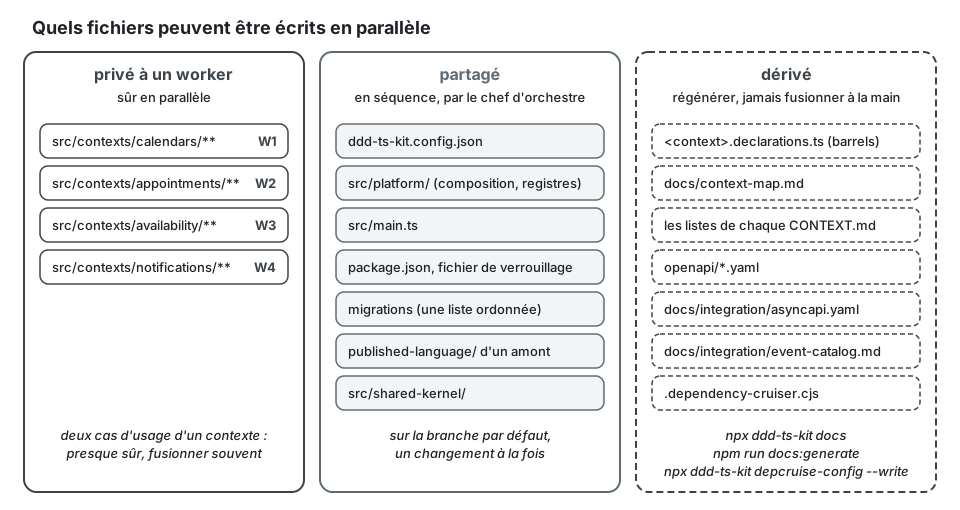
Les fichiers générés : régénérer, jamais résoudre à la main
Section intitulée « Les fichiers générés : régénérer, jamais résoudre à la main »Le barrel, la carte des contextes, les listes des CONTEXT.md, la configuration de
dependency-cruiser, le document OpenAPI, le document AsyncAPI et le catalogue des événements sont
tous des fonctions des sources. Quand deux branches ont modifié l'un d'eux, le conflit ne porte
aucune information. Prenez l'un ou l'autre côté, puis :
npx ddd-ts-kit docs # carte des contextes, listes des CONTEXT.md, barrelsnpm run docs:generate # OpenAPI, AsyncAPI, catalogue des événementsnpm run verifyEn entier, pour la branche qui arrive en second. Ici, le worker de notification a ajouté
GET /notifications/preferences pendant que la branche par défaut recevait
GET /people/invitations de identity. Le document OpenAPI trie ses chemins : les deux nouvelles
entrées tombent au même endroit, juste avant /people/me, et git ne sait pas les placer l'une
après l'autre :
git fetch origingit merge origin/main# CONFLICT (content): Merge conflict in openapi/openapi.yamlgit checkout --theirs openapi/openapi.yaml # n'importe quel côté : le fichier est réécrit ci-dessousnpx ddd-ts-kit docsnpm run docs:generatenpm run verifygit status --short # chaque fichier que les générateurs ont réécritgit add openapi/openapi.yaml # fichier par fichier, puis relire le diff indexégit diff --cached --statgit commit --no-editLe document régénéré porte les deux routes, /notifications/preferences de cette branche et
/people/invitations de la branche par défaut, parce que les deux sont désormais dans les
sources.
Les générateurs sont déterministes (sortie triée, indépendante de l'ordre d'enregistrement), si
bien que deux personnes qui régénèrent à partir des mêmes sources obtiennent les mêmes octets.
docs --check et declarations/barrel-current font échouer le pipeline si quelqu'un a oublié.
Qui régénère : celui qui fusionne en second. La première branche à arriver est cohérente par elle-même ; la seconde se rebase sur la branche par défaut ou la fusionne, régénère, et commite le résultat avec son propre changement. Dans une équipe d'agents, confiez cette tâche au chef d'orchestre, pas à chaque worker.
Les migrations
Section intitulée « Les migrations »Chaque contexte possède ses tables dans son propre schéma de base de données, si bien que deux contextes ne modifient jamais la même table. Ce qu'ils partagent, c'est la liste ordonnée des fichiers de migration. Générez la migration en dernier, juste avant la fusion, au-dessus de la branche par défaut à jour ; si deux branches ont chacune ajouté « la prochaine » migration, la seconde régénère la sienne. Ne modifiez jamais une migration qui a été exécutée quelque part.
Le langage publié d'un amont
Section intitulée « Le langage publié d'un amont »Un consommateur ne peut pas être construit contre un contrat qui bouge encore. Fusionnez d'abord la déclaration de l'amont (l'événement, son publisher, le catalogue régénéré), dans sa propre petite pull request, puis laissez les consommateurs commencer. Voir « Les contrats d'abord » dans Travailler en équipe.
Les worktrees de git
Section intitulée « Les worktrees de git »Un worktree est un second répertoire de travail du même dépôt, sur une autre branche. Il permet à plusieurs workers de tourner à la fois sur une même machine sans stash ni changement de branche :
git worktree add ../scheduling-appointments -b feat/appointments-bookgit worktree add ../scheduling-calendars -b feat/calendars-working-hoursPour un worker par contexte, la CLI le fait en une commande :
npx ddd-ts-kit worker-scope appointmentsElle ajoute un worktree sur la branche build/appointments (par défaut dans
../<project>-appointments ; --worktree <path> et --branch <name> changent l'un et l'autre),
y écrit .ddd-ts-kit/worker.json qui nomme le contexte, et affiche la consigne de ce worker :
le répertoire qu'il peut écrire, les générateurs qu'il peut lancer, ses lignes de
docs/architecture/slices.md, les contrats qu'il consomme. --dry-run affiche la même chose sans
rien toucher. Elle a besoin d'un dépôt avec au moins un commit, et un worktree existant est
conservé : seul le fichier est réécrit. init liste .ddd-ts-kit/ dans .gitignore, si bien que
le fichier n'est jamais commité. Le fichier tient en une ligne utile :
{ "context": "appointments"}La consigne est remplie à partir du projet. Dans l'application d'exemple, un extrait de ce
qu'affiche npx ddd-ts-kit worker-scope notification --dry-run (le chemin raccourci, main
comme tronc, et les générateurs, les étapes et le compte rendu omis) :
You build the bounded context notification of scheduling.
Worktree: ../scheduling-notification/   Branch: build/notification   Trunk: main
Scope- You may write: src/contexts/notification/** and test/e2e/<use-case>.e2e.spec.ts of your slices.- You may not write anything else. Shared files (config, src/platform, src/main.ts,  package.json, lockfile, migrations, docs/) and other contexts are refused by the guard:  report the need, do not work around it.
Slices, in this order (rows of docs/architecture/slices.md)- #31 Contacts known from identity (projection): `@Projection` over `identity.person.registered` ; ...- #32 Send a notification for a fact of an appointment: `port notification Mailer`; ...- #33 Plan, withdraw and send reminders: `command notification PlanReminder --aggregate Reminder --permission reminder.plan`; ...- #34 Sent notifications of a person: `query notification SearchNotifications --permission notification.read --search` (`GET /notifications`) ; ...
Contracts you consume (read-only): src/contexts/scheduling/published-language/, src/contexts/identity/published-language/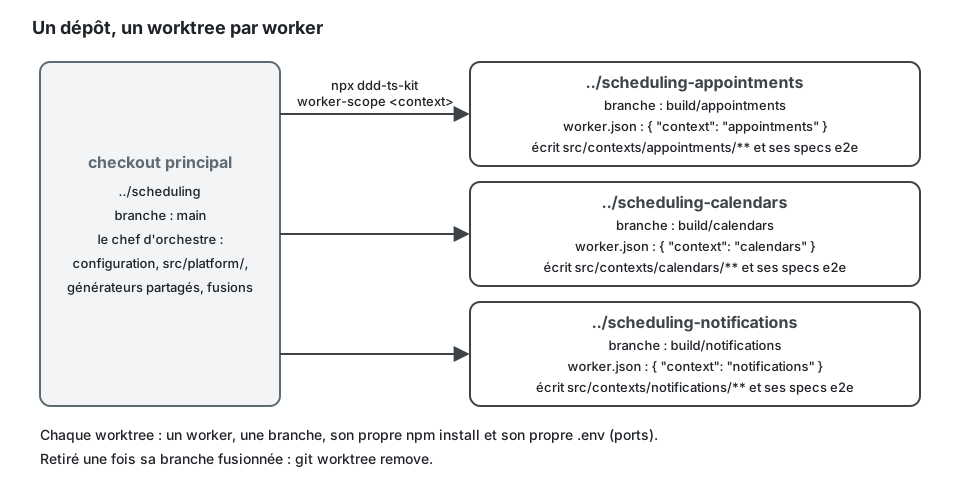
Chaque worktree a besoin de son propre npm install (les dépendances ne sont pas partagées
entre worktrees) et de ses propres ports si deux d'entre eux lancent npm run dev ou les tests
de bout en bout en même temps : le docker-compose.yml généré prend ses ports dans .env, donnez
donc à chaque worktree son propre .env. Les tests rapides n'ont besoin d'aucun serveur (les
specs d'adaptateurs peuvent tourner sur un PostgreSQL dans le processus), et c'est ce qui rend
praticables quatre workers sur un seul ordinateur portable.
Les règles qui empêchent les worktrees de faire du tort :
- un worker par worktree, une branche par worktree ; un worktree n'est pas un lieu de partage ;
- indexez fichier par fichier, et relisez le diff indexé avant de commiter : un
git addlarge dans un répertoire où écrit un autre processus commite le travail à moitié fini de quelqu'un d'autre ; - retirez le worktree quand sa branche est fusionnée (
git worktree remove).
Pour les agents de code en particulier : un agent à qui l'on dit de travailler « dans le contexte
appointments » et qui est lancé dans le checkout principal lira quand même, et pourra modifier,
n'importe quoi. Donnez-lui un worktree et nommez le répertoire dont il est propriétaire. Le
hook du plugin refuse un fichier écrit à la main là où un générateur existe et toute
modification d'un fichier généré (les trois contrats, le barrel, .dependency-cruiser.cjs), et
demande confirmation avant un changement des fichiers gouvernés (la configuration, celle du lint,
des tests, du compilateur et du pipeline). Pour son agent context-builder, il va plus loin :
avec un .ddd-ts-kit/worker.json dans le worktree, une écriture hors de
src/contexts/<context>/ et des specs de bout en bout est refusée, de même qu'un générateur
qui écrit des fichiers partagés et un changement de dépendance. Un worker passe --local-only
à generate : la commande refuse alors, et n'écrit rien, quand la sorte écrirait hors de son
contexte :
$ npx ddd-ts-kit generate job notification SendDueConfirmations --every 15m --command SendNotification --local-onlyError: --local-only: this command would write 2 shared files: src/platform/auth/relate-system-actors.ts, src/platform/job-settings.ts. fix: Nothing was written. Have it run on the trunk without --local-only (the conductor of a parallel build does it), merge the trunk, then go on; a generated document listed alone means the trunk is stale: run `ddd-ts-kit docs` there first.L'ordre de fusion
Section intitulée « L'ordre de fusion »- L'amorçage, seul, en premier.
- Les contrats, l'amont avant l'aval : suivez les flèches de la carte des contextes.
- Les tranches à l'intérieur de chaque contexte, dans n'importe quel ordre d'un contexte à l'autre.
- Les consommateurs d'un événement, après la fusion de la déclaration de l'événement (ils n'ont pas besoin que le comportement du producteur existe : un gestionnaire est testé avec des événements construits à partir de la déclaration).
- Les specs de bout en bout qui traversent plusieurs contextes, en dernier, quand les deux côtés sont en place.
Fusionnez petit et souvent. Deux branches qui ont vécu chacune une semaine entreront en conflit dans l'agrégat et dans chaque fichier dérivé ; le même travail en dix pull requests n'entre en conflit nulle part.
Un plan concret : quatre contextes, quatre workers
Section intitulée « Un plan concret : quatre contextes, quatre workers »Une application de prise de rendez-vous avec quatre contextes : calendars, appointments,
availability, notifications (analytics est ajouté plus tard de la même façon ; l'identité
est achetée, pas construite). L'application d'exemple de ce dépôt a suivi le même genre de plan
sur ses propres quatre contextes (identity, scheduling, notification, analytics), avec
scheduling partagé entre deux workers sur deux agrégats : son tableau est
examples/scheduling/docs/architecture/slices.fr.md.
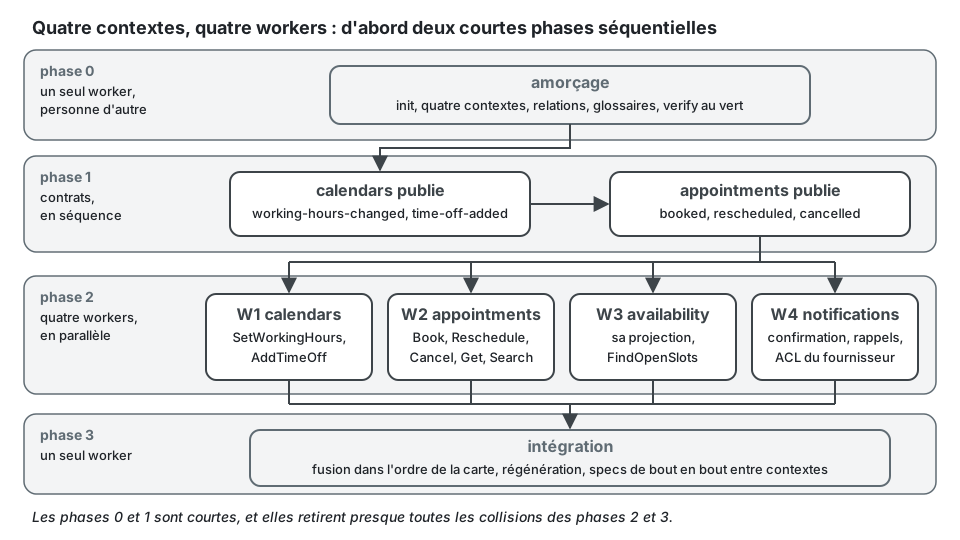
Phase 0, amorçage commun (un worker, personne d'autre ne commence).
npx ddd-ts-kit init --context calendars:supporting --context appointments:core \ --context availability:supporting --context notifications:supportingpnpm install && pnpm run verify # npm install && npm run verify avec --package-manager npmEnsuite, toujours en séquence, parce que chacun de ces changements modifie la configuration ou un
enregistrement partagé : les amonts de chaque contexte (appointments nomme calendars ;
availability nomme calendars et appointments ; notifications nomme appointments), les
premiers termes de chaque glossaire, et toute dépendance dont la stack a besoin. Fusionnez. À
partir de là, la configuration est gelée pour la durée de la phase.
Phase 1, contrats (en séquence, chacun dans une petite pull request). Les deux amonts
déclarent leurs événements d'intégration avec generate integration-event. Les agrégats
derrière eux peuvent être des coquilles vides : ce qui compte, ce sont le type, la version et le
contenu déclarés. Régénérez le catalogue. Fusionnez calendars d'abord, puis appointments.
Phase 2, quatre workers, chacun dans un worktree, chacun propriétaire d'un répertoire.
| Worker | Possède | Construit | Dépend de (déjà fusionné) |
|---|---|---|---|
| W1 | src/contexts/calendars/ |
l'agrégat Calendar, SetWorkingHours, AddTimeOff, leurs routes ; émet les deux événements |
rien |
| W2 | src/contexts/appointments/ |
l'agrégat Appointment, les commandes et requêtes de réservation, la contrainte d'absence de double réservation ; émet les trois événements |
les événements déclarés de calendars, s'il garde une copie locale des horaires de travail |
| W3 | src/contexts/availability/ |
les gestionnaires d'intégration qui alimentent sa projection, FindOpenSlots |
les événements déclarés des deux amonts |
| W4 | src/contexts/notifications/ |
le gestionnaire sous le nom de consommateur notifications.appointments-appointment-booked (la forme générée, <context>.<reaction>), le job notifications.send-reminders, la couche anticorruption du fournisseur |
les événements déclarés d'appointments |
La consigne de chaque worker dit : le seul répertoire qu'il peut écrire, les fichiers qu'il ne
doit pas toucher (la configuration, src/platform/, src/main.ts, un autre contexte, tout
document généré), qu'il ne doit pas régénérer les documents partagés, et qu'il s'arrête et rend
compte si sa tranche semble exiger un changement hors de son répertoire. worker-scope affiche
cette consigne. W3 et W4 testent leurs gestionnaires avec des événements construits à partir des
déclarations ; ils n'attendent pas que W1 et W2 aient fini.
Phase 3, intégration (un worker). Fusionnez dans l'ordre de la carte (calendars,
appointments, availability, notifications), régénérez les fichiers dérivés après chaque
fusion, écrivez les migrations en séquence, puis ajoutez les specs de bout en bout qui
traversent plusieurs contextes (réserver un rendez-vous, observer la confirmation et la
disparition du créneau) et lancez npm run verify.
Le plugin consigne le même plan sous forme de tableau : la skill plan-slices produit
docs/architecture/slices.md, où chaque ligne est un contract, un skeleton (un agrégat et
son repository, dont les générateurs écrivent aussi des fichiers partagés) ou une slice, avec
un propriétaire et les lignes dont elle dépend. Les contrats et les squelettes appartiennent au
chef d'orchestre, les tranches au worker de leur contexte, et seul le chef d'orchestre modifie
le fichier. npx ddd-ts-kit status le relit : les tranches par statut et par propriétaire, et
les TODO(domain), TODO(platform) et it.todo restants dans chaque contexte ;
npx ddd-ts-kit todo <context> les liste sous la forme file:line.
Quatre lignes de ce tableau dans l'application d'exemple, telles que status et worker-scope
les lisent :
| # | Contexte | Sorte | Tranche | Commencer par | Dépend de | Propriétaire | Statut |
|---|---|---|---|---|---|---|---|
| 3 | notification | skeleton | Notification, Reminder | aggregate notification <Name> puis repository notification <Name>, deux fois |
conductor | done | |
| 31 | notification | slice | Contacts known from identity (projection) | @Projection sur identity.person.registered |
4 | notification | todo |
| 32 | notification | slice | Send a notification for a fact of an appointment | port notification Mailer ; adapter notification Mailer --kind external --decorators ; command notification SendNotification --aggregate Notification --permission notification.send ; integration-handler notification scheduling scheduling.appointment.booked, .confirmed, .rescheduled, .cancelled |
3, 5, 31 | notification | todo |
| 34 | notification | slice | Sent notifications of a person | query notification SearchNotifications --permission notification.read --search (GET /notifications) |
32 | notification | todo |
La ligne 3 est un squelette : ses générateurs écrivent l'index des schémas de la plateforme, le
chef d'orchestre la lance donc sur le tronc. Les lignes 31, 32 et 34 appartiennent au worker
notification, comme la ligne 33, laissée hors de cet extrait ; le worker commence chacune
une fois fusionnées les lignes dont elle dépend.
Ce qui fait fonctionner le plan, c'est que les phases 0 et 1 ne sont délibérément pas parallèles. Elles prennent une petite fraction du temps total et retirent presque toutes les collisions du reste.
Limites et quand ne pas s'en servir
Section intitulée « Limites et quand ne pas s'en servir »- Le parallélisme n'aide pas la découverte. Tant que les frontières et le langage bougent encore, quatre workers produisent quatre hypothèses incompatibles. Ne découpez qu'une fois l'amorçage et les contrats fusionnés.
- À l'intérieur d'un contexte, le gain est faible. Les cas d'usage partagent l'agrégat ; au-delà de deux workers, les fusions coûtent plus que ce que le parallélisme rapporte.
- Un contexte dont le contrat de l'amont n'est pas stable ne peut pas commencer. Séquencez-le.
- Les agents multiplient le coût autant que la vitesse. Chacun porte sa propre fenêtre de contexte ; quatre workers dépensent environ quatre fois les tokens d'un seul, voir Économie de tokens. Sur une même machine, ils partagent aussi la mémoire, le processeur, les ports et le démon Docker.
- Rien ne verrouille un fichier entre des personnes. Les règles interdisent les imports entre
contextes ; elles n'empêchent pas deux branches de modifier la configuration. Le séquencement
ci-dessus est une discipline, tenue par la revue et par la consigne que reçoit chaque worker.
Le confinement par
.ddd-ts-kit/worker.jsondécrit plus haut ne s'applique qu'à l'agentcontext-builderdu plugin, dans une session Claude Code, et laisse passer en cas d'échec comme le reste du hook ;--local-onlyvaut pour tout le monde, mais seulement pour ce qu'écritgenerate. - Le plan suppose le style déclaré avec un barrel par contexte. Dans le style explicite,
<context>.module.tsest un fichier d'enregistrement maintenu à la main à l'intérieur de chaque contexte : toujours privé au contexte, mais un point de conflit entre deux cas d'usage de ce contexte.
- Documentation de Git,
git-worktree, https://git-scm.com/docs/git-worktree - Matthew Skelton et Manuel Pais, Team Topologies, IT Revolution, 2019.
- Sam Newman, Building Microservices, 2e édition, O'Reilly, 2021, chapitre 5 (contrats et conception partant du consommateur).
- Ce dépôt : le README de la CLI (ce qu'écrit chaque
générateur, les régions entre marqueurs, les barrels dérivés,
worker-scope), les skillsparallel-worketplan-slices.