
@ddd-ts-kit/scheduling
Les jobs planifiés et les jobs en arrière-plan d'un projet construit avec le kit. Un job planifié est une classe de la couche application qui dit quand elle s'exécute et déclenche des cas d'usage : il ne décide rien, les règles métier restent dans le domaine. Le planificateur ouvre une portée d'exécution autour de chaque exécution, s'assure qu'une seule instance de l'application exécute une occurrence donnée, et enregistre ce qu'il en est advenu. Un job en arrière-plan est mis en file par un cas d'usage et exécuté plus tard par le worker de ce package (voir « Jobs en arrière-plan » plus bas). Pourquoi un job ne fait que déclencher un cas d'usage, et comment en concevoir un qui supporte d'être exécuté deux fois : Jobs planifiés.
npm i @ddd-ts-kit/scheduling| Point d'entrée | Contient | Importe |
|---|---|---|
@ddd-ts-kit/scheduling |
InProcessJobScheduler, nextOccurrence, latestOccurrence, systemJobTimers, les ports JobTimers et JobCheckpoints, JobTimeoutError, JobAbortedError, JobLockUnavailableError, reportFailedRuns, UNEXPECTED_ERROR, les noms des métriques ; pour les jobs en arrière-plan QueueWorker, StoredJobQueue, le port JobStore, InMemoryJobStore, tenantKeyOf, reportFailedBackgroundJobs, JobInterruptedError, InvalidEnqueueError, UnknownBackgroundJobError, AttemptsExhaustedError ; pour les gestionnaires de processus StoredProcessRunner, NoTimeoutJobError |
le kernel |
@ddd-ts-kit/scheduling/testing |
ManualJobScheduler, ManualJobTimers |
le kernel |
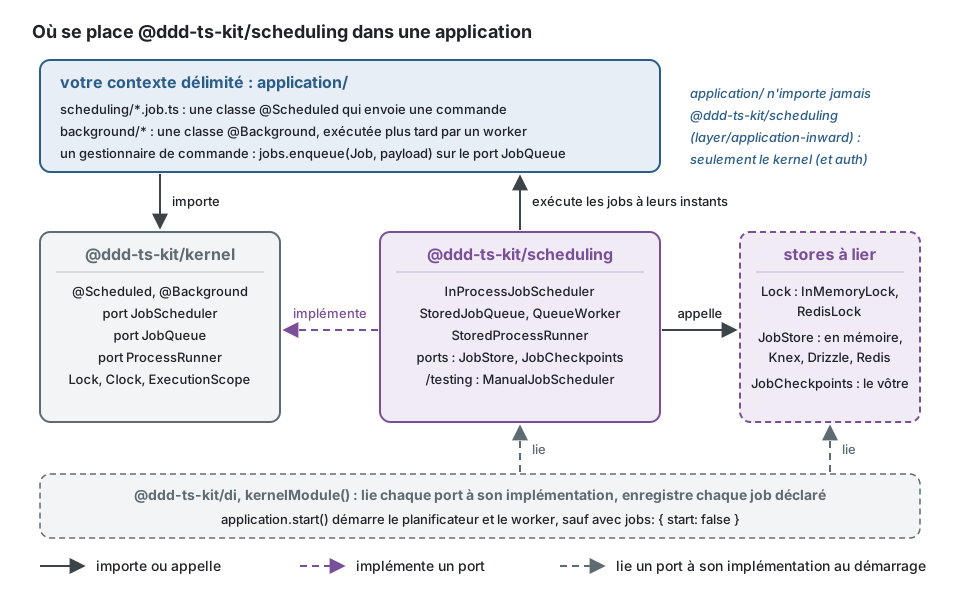
Les déclarations (@Scheduled, @Background), les ports (JobScheduler, JobQueue,
ProcessRunner) et l'analyseur des planifications vivent dans @ddd-ts-kit/kernel, si bien que
application/ importe le kernel et rien d'autre. @ddd-ts-kit/di lie JobScheduler à un
InProcessJobScheduler dans son module kernel et enregistre les jobs déclarés : une application
construite avec lui n'a besoin d'aucune ligne de ce README, hormis le job lui-même.
JobScheduler n'est pas le Scheduler de @ddd-ts-kit/aspects. Celui-là est un minuteur pour
les nouvelles tentatives et les délais d'expiration (schedule(work, delayMs)) ; celui-ci connaît
les jobs, les planifications et les instances.
import { AuthorizedCommand, CommandBus, systemActor, type Actor } from '@ddd-ts-kit/kernel';import { Scheduled, type JobExecution, type ScheduledJob } from '@ddd-ts-kit/kernel/declarations';
// la commande du cas d'usage, dans application/commands/send-payment-reminders/declare class SendPaymentReminders extends AuthorizedCommand {  constructor(actor: Actor, dueOn: Date);}
@Scheduled('billing.send-payment-reminders', { cron: '0 7 * * 1-5', timeZone: 'Europe/Paris' })export class SendPaymentRemindersJob implements ScheduledJob {  constructor(private readonly commands: CommandBus) {}
async run(execution: JobExecution): Promise<void> { await this.commands.execute( new SendPaymentReminders(systemActor('billing.send-payment-reminders'), execution.scheduledAt), ); }}-
Où :
application/scheduling/, dans un fichier nommé*.job.ts, un job par fichier. -
Le nom est
<context>.<job-name>, en minuscules, écrit comme une chaîne littérale et unique dans l'application : c'est l'acteur système sous lequel le job s'exécute, la clé de son verrou, son libellé dans les métriques et la clé de ses réglages. Il survit au renommage de la classe. -
Ses dépendances sont ce que prend son constructeur, chaque paramètre typé par un port, comme pour toute déclaration du kit :
constructor(private readonly commands: CommandBus) {}, sans liste dans le décorateur. Un job reçoit des bus et des ports. Il ne reçoit pas de repository : ce qu'il en ferait est un cas d'usage. -
run(execution)reçoit :Champ scheduledAtl'instant où l'exécution était due. Passez-le à la commande : « les rappels de ce matin-là » sont le même travail, quel que soit le moment où il s'exécute réellement startedAtl'instant où elle a commencé : plus tard, du fait de la gigue, d'une attente en file ou d'un rattrapage attempt1 avec ce planificateur, qui ne retente jamais signalannulé quand l'exécution dépasse son délai d'expiration ou que le planificateur s'arrête ; un job long le vérifie entre deux étapes -
La commande est envoyée sous l'acteur système du job, comme le fait un gestionnaire d'événement d'intégration pour son consommateur. Avec
@ddd-ts-kit/auth, accordez à cet acteur la permission de la commande, ou déclarez la commande@Public()quand rien d'autre ne peut l'envoyer. -
Vérifié au chargement du fichier : un nom qui n'est pas
<context>.<job-name>, un cron illisible ou qui ne se déclenche jamais, un intervalle nul, un fuseau horaire inconnu et une option hors de ses valeurs lèvent uneDeclarationErrorqui nomme le job.
La portée d'exécution
Section intitulée « La portée d'exécution »Le planificateur ouvre une ExecutionScope autour de chaque exécution, si bien que le job n'en
écrit rien :
| Champ du contexte | Valeur |
|---|---|
origin |
schedule |
actor |
systemActor('<job name>') |
correlationId |
un nouveau à chaque exécution, tiré de l'IdGenerator |
scheduledAt |
l'instant où l'exécution était due |
deadline |
le démarrage plus timeoutMs, quand le job en a un |
Les colonnes d'audit, le journal d'audit, les champs des journaux, le traçage et la corrélation apposée sur les événements publiés fonctionnent donc comme pour une requête.
Global ou par tenant
Section intitulée « Global ou par tenant »Un job le dit, explicitement. tenancy: 'global' (la valeur par défaut) s'exécute une fois par
occurrence dans aucun tenant : les utilitaires de persistance qui en exigent un
(tenantScopeOf) le refusent, et un cas d'usage qui travaille par tenant reçoit le tenant
dans sa commande. tenancy: 'per-tenant' s'exécute une fois par tenant du TenantDirectory
donné au planificateur (option tenants ; enregistrer un tel job sans elle lève
InvalidJobScheduleError) :
import {  InMemoryTenantDirectory,  type Clock,  type ExecutionScope,  type IdGenerator,  type JobExecution,  type Lock,} from '@ddd-ts-kit/kernel';import { InProcessJobScheduler } from '@ddd-ts-kit/scheduling';
declare const clock: Clock, lock: Lock, scope: ExecutionScope, ids: IdGenerator;declare function closeMonthOf(tenantId: string, month: Date): Promise<void>;
const scheduler = new InProcessJobScheduler({ clock, lock, scope, ids, tenants: new InMemoryTenantDirectory(['acme', 'globex']) });
scheduler.register({  name: 'billing.close-month',  schedule: { cron: '0 2 1 * *' },  tenancy: 'per-tenant',  // appelé deux fois par occurrence : une fois avec le tenantId 'acme', puis une fois avec 'globex'  run: async (execution: JobExecution) => {    if (execution.tenantId !== undefined) {      await closeMonthOf(execution.tenantId, execution.scheduledAt);    }  },});
L'exécution de chaque tenant a lieu dans sa propre portée d'exécution, tenantId renseigné, et
execution.tenantId dit au job lequel ; les exécutions d'une même occurrence partagent son
identifiant de corrélation et s'exécutent l'une après l'autre. Un tenant qui échoue n'arrête pas
les autres : l'occurrence échoue avec la première erreur une fois que chaque tenant a eu son
exécution. Un signal annulé (délai d'expiration, arrêt) s'arrête avant le tenant suivant.
Planifications
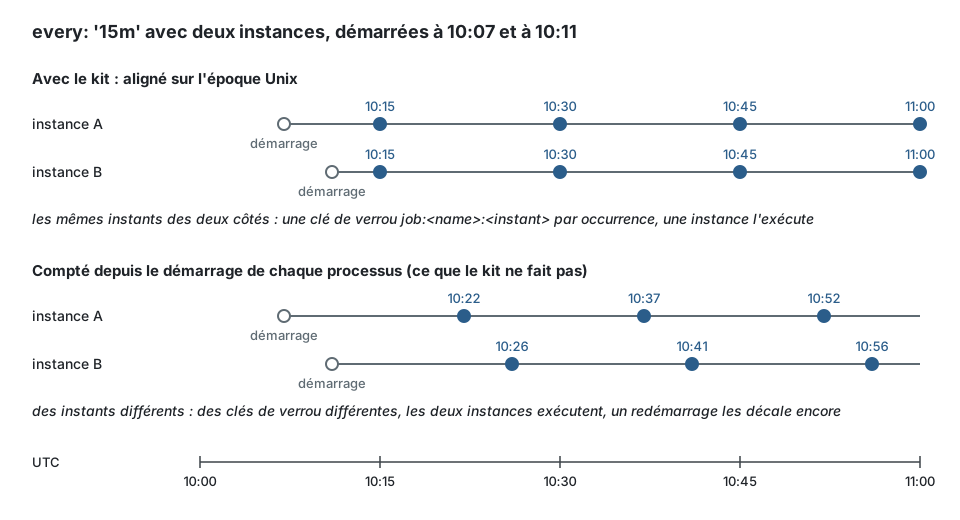
Section intitulée « Planifications »{ every: '15m' } // ou un nombre de millisecondes{ cron: '0 7 * * 1-5', timeZone: 'Europe/Paris' } // timeZone vaut UTC par défautLes intervalles sont un nombre entier de millisecondes, ou un nombre et une unité : '500ms',
'30s', '15m', '2h', '1d'. Ils sont alignés sur l'époque Unix, pas sur le démarrage du
processus : '15m' tombe à :00, :15, :30 et :45, '1d' à minuit UTC. C'est ce qui fait que
chaque instance nomme les mêmes instants, et qu'un redémarrage les conserve. Un intervalle qui ne
divise pas une journée ('7h') dérive par rapport à l'heure murale, et aucun ne suit un fuseau
horaire : pour « chaque matin », écrivez un cron.
Le cron a les cinq champs standard, sans les secondes :
| Champ | Valeurs | Noms |
|---|---|---|
| minute | 0-59 | |
| heure | 0-23 | |
| jour du mois | 1-31 | |
| mois | 1-12 | jan à dec |
| jour de la semaine | 0-7, 0 et 7 sont le dimanche | sun à sat |
Chaque champ accepte *, une valeur, un intervalle a-b, un pas sur l'un ou l'autre (*/15,
8-18/2) et des listes de ceux-ci (0,30, mon-fri). Les noms ignorent la casse. Quand le jour
du mois et le jour de la semaine sont tous deux restreints (aucun ne commence par *), un jour qui
convient à l'un ou à l'autre convient, comme dans tout cron : 0 0 13 * fri est le 13 et chaque
vendredi. Non pris en charge : @daily et ses semblables, ?, L, W, #, un pas sur une
valeur seule (5/15), un intervalle qui fait le tour (fri-mon).
Les fuseaux horaires sont des noms IANA, évalués avec Intl.DateTimeFormat, sans dépendance :
les règles sont celles du runtime, mises à jour avec lui. Les champs sont lus sur les horloges
du fuseau, champs de jour compris.
| Quand les horloges sont | Un job fixé à une heure (30 2 * * *) |
Un job de chaque heure (0 * * * *, */20 * * * *) |
|---|---|---|
| avancées (de 02:00 à 03:00) | une heure locale qui n'existe pas est sautée : aucune exécution ce jour-là, rien n'est déplacé à 03:00 | garde son rythme : 01:00, puis 03:00, une heure plus tard |
| reculées (de 03:00 à 02:00) | une heure locale qui survient deux fois s'exécute une fois, la première | garde son rythme : l'heure répétée est parcourue deux fois |
Un job est « de chaque heure » quand son champ d'heure commence par * : il suit le temps
écoulé. Tout autre job suit les horloges. Ne planifiez pas dans l'heure qui change ce qui doit
s'exécuter chaque jour : 30 2 * * * en Europe/Paris n'a aucune exécution le dernier dimanche
de mars.
nextOccurrence(parseJobSchedule(schedule), after) et latestOccurrence(parsed, { after, notAfter }) donnent les instants, pour un écran qui montre quand un job s'exécute la prochaine
fois, ou pour une spec qui fige une planification avant son déploiement :
import { describeJobSchedule, parseJobSchedule } from '@ddd-ts-kit/kernel';import { latestOccurrence, nextOccurrence } from '@ddd-ts-kit/scheduling';
const every15 = parseJobSchedule({ every: '15m' });nextOccurrence(every15, new Date('2026-03-02T10:07:00Z')); // 2026-03-02T10:15:00Z, quel que soit le démarrage du processus
const weekdayMornings = { cron: '0 7 * * 1-5', timeZone: 'Europe/Paris' };const parsed = parseJobSchedule(weekdayMornings);describeJobSchedule(weekdayMornings); // 'cron 0 7 * * 1-5 (Europe/Paris)'nextOccurrence(parsed, new Date('2026-03-06T08:00:00Z')); // lundi 2026-03-09T06:00:00Z : 07:00 à Paris, UTC+1latestOccurrence(parsed, { after: new Date('2026-03-02T00:00:00Z'), notAfter: new Date('2026-03-04T12:00:00Z') }); // 2026-03-04T06:00:00Z
// 02:30 n'existe pas à Paris le 2026-03-29 : ce jour-là n'a aucune exécutionnextOccurrence(parseJobSchedule({ cron: '30 2 * * *', timeZone: 'Europe/Paris' }), new Date('2026-03-28T12:00:00Z')); // 2026-03-30T00:30:00ZÉcrites à côté de la planification : { every: '15m', overlap: 'queue', timeoutMs: 60_000 }.
| Option | Par défaut | |
|---|---|---|
overlap |
'skip' |
une occurrence qui arrive pendant que l'exécution précédente est en cours n'est pas démarrée (skipped-overlap). 'queue' la démarre quand l'exécution se termine ; une occurrence attend au plus, les suivantes sont sautées |
missed |
'skip' |
les occurrences que le planificateur n'a pas atteintes à temps sont abandonnées (missed) et le job attend la suivante. 'run-once' exécute la plus récente d'entre elles, une fois, quel que soit le nombre écoulé |
timeoutMs |
aucun | le signal d'une exécution plus longue est annulé avec une JobTimeoutError et l'exécution est enregistrée failed, JOB_TIMEOUT |
jitterMs |
0 |
un délai aléatoire, jusqu'à cette valeur, avant chaque exécution, pour que les jobs ne démarrent pas tous à la minute pile |
enabled |
true |
false ne démarre jamais le job selon l'heure ; runNow l'exécute quand même |
singleInstance |
true |
une seule instance exécute une occurrence : voir plus bas |
Chaque option agit à une étape d'une occurrence, et chaque étape qui l'arrête enregistre une issue (voir « Observabilité ») :
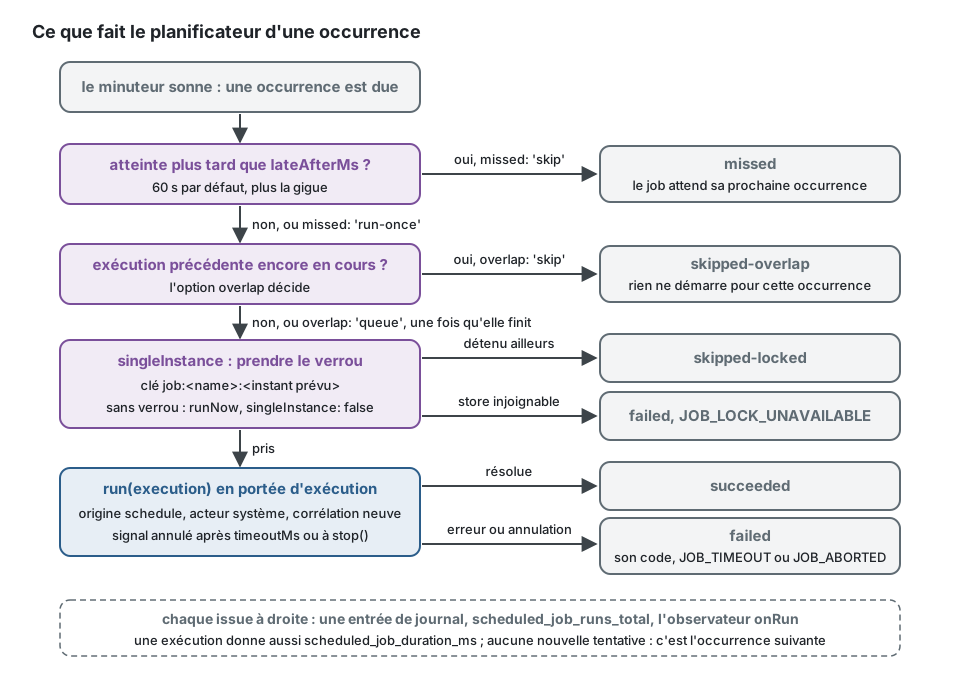
Manquée veut dire atteinte plus tard que lateAfterMs (60 s par défaut, une option du
planificateur) après l'instant, gigue mise à part : le processus était arrêté, en veille, ou sa
boucle d'événements bloquée. Un minuteur en retard de quelques secondes exécute quand même son
occurrence. Ce qui est passé pendant que le processus était arrêté n'est connu qu'avec
checkpoints :
// le port, exporté par ce packageexport abstract class JobCheckpoints {  abstract read(job: string): Promise<Date | undefined>;
  abstract write(job: string, handled: Date): Promise<void>;}
Le planificateur y écrit la dernière occurrence qu'il a traitée pour chaque job et la lit à son
démarrage. Sans lui, un redémarrage oublie : chaque job repart de l'instant du démarrage, et
run-once ne couvre que ce qui a été manqué pendant que le processus était vivant. Le store est
le vôtre, une table ou une clé partagée par les instances. Il est donné au planificateur là où le
planificateur est construit : voir « Remplacer le planificateur ».
Un adaptateur sur un client SQL à vous, une ligne par job :
import { JobCheckpoints } from '@ddd-ts-kit/scheduling';
// le client de votre base de données, un port que lie votre plateformedeclare abstract class Sql {  abstract rows<Row>(text: string, values: readonly unknown[]): Promise<readonly Row[]>;  abstract execute(text: string, values: readonly unknown[]): Promise<void>;}
export class SqlJobCheckpoints implements JobCheckpoints {  constructor(private readonly sql: Sql) {}
  async read(job: string): Promise<Date | undefined> {    const [row] = await this.sql.rows<{ handled_at: Date }>('select handled_at from job_checkpoints where job = $1', [job]);
    return row?.handled_at;  }
  async write(job: string, handled: Date): Promise<void> {    await this.sql.execute(      `insert into job_checkpoints (job, handled_at) values ($1, $2)       on conflict (job) do update set handled_at = greatest(job_checkpoints.handled_at, excluded.handled_at)`,      [job, handled],    );  }}
greatest garde l'instant le plus récent quand deux instances écrivent en même temps : le point
de reprise ne fait qu'avancer.
Un délai d'expiration ne tue pas. Une exécution est une promesse, et rien ne peut arrêter une promesse : le planificateur annule le signal, cesse d'attendre et libère le job pour sa prochaine occurrence. Un job qui ignore son signal continue en arrière-plan, puis chevauche l'exécution suivante. Transmettez le signal, ou vérifiez-le.
// au lieu de : une boucle qui ne regarde jamais le signal, et envoie encore des commandes après le délai d'expirationfor (const batch of batches) { await this.commands.execute(new ArchiveBatch(actor, batch, execution.scheduledAt));}import { AuthorizedCommand, CommandBus, systemActor, type Actor } from '@ddd-ts-kit/kernel';import { Scheduled, type JobExecution, type ScheduledJob } from '@ddd-ts-kit/kernel/declarations';
declare class ArchiveBatch extends AuthorizedCommand { constructor(actor: Actor, batch: number, asOf: Date);}
const BATCHES = 20;
// écrivez : s'arrêter entre deux étapes dès que l'exécution est annulée (délai d'expiration ou stop())@Scheduled('archive.archive-old-records', { cron: '0 3 * * *', timeoutMs: 10 * 60_000 })export class ArchiveOldRecordsJob implements ScheduledJob { constructor(private readonly commands: CommandBus) {}
async run(execution: JobExecution): Promise<void> { const actor = systemActor('archive.archive-old-records');
for (let batch = 0; batch < BATCHES; batch += 1) { execution.signal.throwIfAborted(); // lève la JobTimeoutError ou la JobAbortedError await this.commands.execute(new ArchiveBatch(actor, batch, execution.scheduledAt)); } }}Rendez la commande de chaque lot sûre à renvoyer : ce qu'un délai d'expiration laisse inachevé, l'occurrence suivante le reprend à partir de l'état.
Désactiver un job, par environnement
Section intitulée « Désactiver un job, par environnement »Un job se désactive, se replanifie ou se règle par la configuration, jamais par un changement de
code. Avec @ddd-ts-kit/di :
import { createApplication, type ContextModule } from '@ddd-ts-kit/di';
declare const modules: readonly ContextModule[];declare const config: { readonly jobs: { readonly reminders: { readonly enabled: boolean }; readonly ledgerCron: string } };
createApplication({  modules,  jobs: {    settings: {      'billing.send-payment-reminders': { enabled: config.jobs.reminders.enabled },      'billing.export-ledger': { schedule: { cron: config.jobs.ledgerCron, timeZone: 'Europe/Paris' } },    },  },});
Les réglages d'un job qu'aucun module ne déclare sont refusés (UNKNOWN_JOB), si bien qu'un
job renommé ne peut pas rester actif par une clé périmée ; les réglages illisibles sont refusés
aussi (INVALID_JOB_SETTINGS).
Plusieurs instances
Section intitulée « Plusieurs instances »Chaque instance d'une application mise à l'échelle horizontalement exécute un planificateur et
calcule les mêmes instants. Avant d'exécuter une occurrence d'un job singleInstance, le
planificateur prend le Lock du kernel sous la clé job:<name>:<scheduled instant>. L'instance
qui l'obtient exécute ; les autres enregistrent skipped-locked.
- Le verrou n'est pas libéré à la fin de l'exécution. Une instance dont le minuteur se
déclenche un peu plus tard le prendrait et exécuterait l'occurrence à nouveau. Il est gardé
jusqu'à ce que cette instance traite l'occurrence suivante du job, ou jusqu'à ce que sa durée
de vie soit écoulée :
timeoutMs(15 minutes pour un job sans délai d'expiration,lockTtlMs) plus la gigue etlateAfterMs. - Avec
InMemoryLock, la valeur par défaut dekernelModule(), le verrou n'exclut qu'à l'intérieur d'un processus : deux instances exécutent toutes deux chaque job. Il convient pour une instance unique et pour les tests, et rien de plus. - Avec un verrou entre processus (
RedisLockde@ddd-ts-kit/redis, lié àLock), la garantie est réelle, et c'est celle-ci : au plus une exécution par occurrence, au mieux.
Ce qui n'est pas garanti, pour que vous en teniez compte dans la conception :
- Une occurrence peut s'exécuter deux fois : le verrou expire pendant que son détenteur est en
pause ou que l'exécution survit à la durée de vie et qu'une instance en retard arrive ; le store
du verrou bascule et oublie une clé ; une instance redémarre avec
missed: 'run-once'après l'expiration du verrou de l'occurrence qu'elle rattrape ; les horloges divergent de plus que la durée de vie. - Une occurrence peut s'exécuter zéro fois : l'instance qui a pris le verrou plante avant ou
pendant l'exécution (personne ne retente, le verrou reste), toutes les instances sont arrêtées à
l'instant voulu (
missed), ou le store du verrou est injoignable, auquel cas l'occurrence n'est pas exécutée et est enregistréefailed,JOB_LOCK_UNAVAILABLE, plutôt qu'exécutée partout. runNowne prend aucun verrou : c'est une exécution délibérée.
Un job est donc idempotent, ou la commande qu'il envoie l'est. Une exécution qui a lieu deux
fois doit laisser le même état qu'une seule : déduisez ce qu'il faut faire de l'état (« les
factures échues et pas encore relancées »), pas du fait d'être appelé, ou faites de
scheduledAt la clé du travail, derrière une contrainte d'unicité. Le kernel le dit de Lock lui-même : un outil
d'efficacité, jamais la garde d'un invariant. Un travail qui doit avoir lieu exactement une fois
et survivre à un plantage n'est pas un job planifié mais une ligne dans une table, traitée par un
job qui supporte d'être répété.
Les instances devraient garder leurs horloges à quelques secondes les unes des autres (NTP) : les
instants sont calculés à partir de la Clock, et la clé du verrou est l'instant.
Un processus worker dédié
Section intitulée « Un processus worker dédié »Par défaut, chaque processus qui démarre l'application exécute les jobs. Pour les exécuter dans un déploiement et servir les requêtes dans un autre, dites aux autres de ne pas le faire :
// src/main.ts, le processus qui sert les requêtesconst app = createApplication({ modules, jobs: { start: false } });
// src/apps/worker/main.ts, le processus qui exécute les jobs : les mêmes modules, pas de serveur HTTPconst app = createApplication({ modules, jobs: { settings: jobSettings(config) } });await app.start();process.on('SIGTERM', () => void app.stop());
Avec start: false, les jobs sont toujours enregistrés et décrits, et runNow en exécute
toujours un, ce qui donne gratuitement un point d'accès (endpoint) d'exploitation. Une seule racine
de composition qui lit un indicateur (jobs: { start: config.runJobs }) revient au même avec un
seul point d'entrée. Gardez singleInstance activé même avec un seul worker : un déploiement
progressif en fait tourner deux pendant un moment.
Un contexte extrait en service à part emporte ses jobs avec lui : ce sont des déclarations du contexte, enregistrées par l'application qui liste son module. Rien n'est global.
Dans un projet généré par la CLI : ddd-ts-kit generate job écrit le job et sa ligne dans
src/platform/job-settings.ts (désactivé avec JOB_<CONTEXT>_<JOB>_ENABLED=false), main.ts
passe jobs: { start: config.runJobs, settings: jobSettings(process.env) } (RUN_JOBS), et
ddd-ts-kit generate worker écrit src/apps/worker/main.ts et désactive par défaut RUN_JOBS
pour l'API.
Cycle de vie
Section intitulée « Cycle de vie »application.start() démarre le planificateur en dernier, une fois les consommateurs abonnés, et
application.stop() l'arrête en premier. stop() ne démarre aucune nouvelle exécution, attend
les exécutions en cours jusqu'à graceMs (30 s par défaut), puis annule leurs signaux avec une
JobAbortedError et rend la main ; une exécution qui attendait dans une file est abandonnée et
enregistrée missed. Réglez ce délai de grâce en dessous de celui d'arrêt de la plateforme.
Remplacer le planificateur
Section intitulée « Remplacer le planificateur »kernelModule() construit le planificateur sur les ports du kernel qu'il lie : Clock, Lock,
ExecutionScope, IdGenerator, Logger et Metrics, avec reportFailedRuns sur l'ErrorReporter
lié comme onRun. Pour le construire autrement (avec des points de reprise, un autre délai de
grâce, un autre observateur), donnez le vôtre au module kernel :
import { Clock, ErrorReporter, ExecutionScope, IdGenerator, Lock, Logger, Metrics } from '@ddd-ts-kit/kernel';import { createApplication, kernelModule, type ContextModule } from '@ddd-ts-kit/di';import { InProcessJobScheduler, JobCheckpoints, reportFailedRuns } from '@ddd-ts-kit/scheduling';
declare const platformModule: ContextModule, billingModule: ContextModule;
const kernel = kernelModule({  jobScheduler: (resolve) =>    new InProcessJobScheduler({      clock: resolve(Clock),      // demandé à chaque occurrence : construire le planificateur ne doit ouvrir aucune connexion      lock: { acquire: (key, options) => resolve(Lock).acquire(key, options) },      scope: resolve(ExecutionScope),      ids: resolve(IdGenerator),      logger: resolve(Logger),      metrics: resolve(Metrics),      checkpoints: resolve(JobCheckpoints),      graceMs: 10_000,      // ce que fait le planificateur par défaut des exécutions en échec : gardez-le      onRun: reportFailedRuns(resolve(ErrorReporter)),    }),});
const app = createApplication({ modules: [kernel, platformModule, billingModule] });
avec, dans le module de la plateforme, builder.bind(JobCheckpoints).toClass(SqlJobCheckpoints, [Sql]).
Un module ultérieur remplace le planificateur de la même façon, avec
builder.rebind(JobScheduler).toFactory((resolve) => new InProcessJobScheduler({ ... })), et il
en va de même d'une autre implémentation du port JobScheduler (sur une base de données, sur une
file).
Sans @ddd-ts-kit/di :
import type { Clock, ExecutionScope, IdGenerator, Lock, Logger, Metrics, ScheduledJob } from '@ddd-ts-kit/kernel';import { InProcessJobScheduler } from '@ddd-ts-kit/scheduling';
declare const clock: Clock, lock: Lock, scope: ExecutionScope, ids: IdGenerator, logger: Logger, metrics: Metrics;declare const job: ScheduledJob;
const scheduler = new InProcessJobScheduler({ clock, lock, scope, ids, logger, metrics });scheduler.register({ name: 'billing.send-payment-reminders', schedule: { every: '15m' }, run: (execution) => job.run(execution) });await scheduler.start();| Option | Par défaut | |
|---|---|---|
clock, lock, scope, ids |
requises | chaque instant vient de la Clock ; l'horloge système n'est jamais lue |
logger, metrics |
n'écrivent et ne mesurent rien | |
timers |
systemJobTimers |
comment il dort ; ManualJobTimers dans un test |
checkpoints |
aucun | voir « Options » |
lateAfterMs |
60000 |
au-delà, une occurrence est manquée |
graceMs |
30000 |
combien de temps stop() attend |
lockTtlMs |
900000 |
durée de vie du verrou d'un job sans timeoutMs |
random |
Math.random |
tire la gigue |
onRun |
aucun | (run, error?, detail?) => void pour chaque occurrence traitée, avec ce que le job a levé et l'identifiant de corrélation de l'exécution : reportFailedRuns(errorReporter) est l'observateur qui remonte à l'ErrorReporter du kernel chaque exécution en échec pour toute autre cause qu'une DomainError |
Il dort au plus une heure d'affilée et recalcule à son réveil, si bien qu'une horloge corrigée, ou une machine mise en veille, est remarquée dans l'heure.
Observabilité
Section intitulée « Observabilité »scheduler.describe() donne, pour chaque job, name, schedule (every 15m,
cron 0 7 * * 1-5 (Europe/Paris)), enabled, running, nextRunAt et lastRun, sous forme de
données. application.describe().jobs liste les jobs déclarés avec les réglages sous lesquels
ils s'exécutent.
Chaque occurrence traitée a une issue, enregistrée trois fois :
| Issue | Signifie | Niveau de journal |
|---|---|---|
succeeded |
le job s'est exécuté | info |
failed |
le job a levé une erreur, a dépassé son délai d'expiration, a été annulé, ou son verrou n'a pas pu être demandé | error |
skipped-overlap |
l'exécution précédente était encore en cours | warn |
skipped-locked |
une autre instance exécute cette occurrence | debug |
missed |
l'occurrence est passée sans être exécutée | warn |
- Journal : une entrée,
Scheduled job succeeded,Scheduled job failed,Scheduled job missed,Scheduled job skipped: the previous run is still in progressouScheduled job skipped: another instance runs this occurrence, avecjob,context,outcome,scheduledAtet, pour une exécution,durationMs,correlationId,errorCode,errorType. Ce qui se passe mal autour des exécutions (un point de reprise qui ne peut être ni lu ni écrit) est journalisé au niveauerrorsousScheduled job could not be followed, et le job continue. - Métriques : le compteur
scheduled_job_runs_totalet, pour une exécution, l'histogrammescheduled_job_duration_ms, étiquetésjob,context,status(l'issue) eterror_code. Une alerte sur « aucunsucceededpour ce job depuis N intervalles » détecte toutes les façons dont un job cesse de s'exécuter, ce que ne fait pas une alerte sur les échecs. onRun: le même enregistrement, plus l'erreur et l'identifiant de corrélation de l'exécution.
missed est enregistré une fois pour un trou, avec le premier instant manqué, et non une fois par
instant. L'errorCode est le code de ce qui a été levé (une DomainError, JOB_TIMEOUT,
JOB_ABORTED, JOB_LOCK_UNAVAILABLE) ou UNEXPECTED_ERROR. Le message d'une erreur n'est
jamais enregistré : il cite des données. Un job qui échoue n'arrête ni le planificateur ni les
autres jobs, et son occurrence suivante s'exécute normalement : il n'y a pas de nouvelle
tentative, l'occurrence suivante est la nouvelle tentative.
La spec d'un job est une spec du cas d'usage qu'il déclenche : exécutez le job, vérifiez
les fakes. Le temps n'intervient pas, et l'application de test de @ddd-ts-kit/di ne démarre
jamais les jobs selon l'heure.
import { contextModule, createTestApplication, fake, type DeclaredSource } from '@ddd-ts-kit/di';import { expect } from 'vitest';
// le barrel du contexte, et le fake de son port Mailerdeclare const billing: DeclaredSource;declare abstract class Mailer {  abstract send(to: string, subject: string): Promise<void>;}declare class FakeMailer extends Mailer {  readonly sent: readonly { readonly to: string; readonly subject: string }[];  send(to: string, subject: string): Promise<void>;}const mailer = new FakeMailer();
const app = createTestApplication({ modules: [contextModule('billing', billing)], fakes: [fake(Mailer, mailer)] });
await app.jobs.runNow('billing.send-payment-reminders');
expect(mailer.sent).toHaveLength(2);
app.jobs.runNow(name) exécute le job comme le ferait le planificateur (portée d'origine
schedule, acteur système, verrou mis à part) et lève ce que le job a levé. Pour une spec
qui porte sur le temps lui-même, app.jobs.scheduler est un ManualJobScheduler sur l'horloge de
l'application :
import { FixedClock, FixedExecutionScope, InMemoryLock, SequentialIdGenerator } from '@ddd-ts-kit/kernel';import { ManualJobScheduler } from '@ddd-ts-kit/scheduling/testing';import { expect } from 'vitest';
const run = async (): Promise<void> => undefined;const clock = new FixedClock(new Date('2026-03-02T09:58:30Z'));const scheduler = new ManualJobScheduler({ clock, lock: new InMemoryLock(clock), scope: new FixedExecutionScope(), ids: new SequentialIdGenerator() });scheduler.register({ name: 'billing.send-payment-reminders', schedule: { every: '15m' }, run });await scheduler.start();
await scheduler.advance(32 * 60_000);
expect(scheduler.runs.map((run) => run.scheduledAt.toISOString())).toEqual(['2026-03-02T10:00:00.000Z', '2026-03-02T10:15:00.000Z', '2026-03-02T10:30:00.000Z']);advance(ms)avance l'horloge et déclenche chaque minuteur à son instant, dans l'ordre. Quand elle se résout, chaque job qui n'attend que des promesses est terminé ; un job que le test garde bloqué est encore en cours, et c'est ainsi que se testent le chevauchement, le délai d'expiration et l'arrêt.runsliste chaque occurrence traitée avec son issue,failuresce qu'ont levé les exécutions en échec,runsOf(job)les exécutions d'un job. Il n'y a pas de gigue.ManualJobTimersseul pilote unInProcessJobSchedulerconstruit à la main, pour une spec qui règlerandomoucheckpoints.- Deux planificateurs qui partagent une horloge et un verrou sont deux instances : c'est ainsi que le comportement à instance unique est spécifié dans ce package.
Un autre planificateur (sur une base de données, sur une file) implémente le port JobScheduler
du kernel et passe jobSchedulerContract de @ddd-ts-kit/testing/contracts.
Jobs en arrière-plan
Section intitulée « Jobs en arrière-plan »Un travail qu'un cas d'usage confie à un worker, pour l'exécuter plus tard : le port
(JobQueue), la déclaration (@Background) et le type de la charge utile (payload) vivent dans
le kernel ; ce package les exécute. Pourquoi et quand, avec les garanties :
Jobs en arrière-plan.
| Pièce | |
|---|---|
StoredJobQueue |
la JobQueue du kernel sur un JobStore : nomme le job, capture la corrélation, l'acteur, le tenant et le traceparent du travail qui met en file, l'ajoute au store ; find et cancel n'atteignent que les jobs du tenant du travail en cours (des tenants de son élévation ; tous les jobs quand le travail n'a pas de tenant) |
JobStore |
le port des stores : add, claim (un bail), heartbeat, update (progression, point de reprise), complete, fail, release, cancel, find, retryDead, purgeFinished, stats ; chaque compte rendu nomme sa tentative (JobLease) |
InMemoryJobStore |
le store des tests et d'un processus sans base de données : add, cancel et retryDead attendent la validation (commit) de l'unité de travail ; list() pour les assertions |
tenantKeyOf(enqueuedBy) |
la partie tenant de la clé d'idempotence, pour un store qui la garde dans un index unique : le tenant, ou le texte vide |
QueueWorker |
prend et exécute les jobs des files pour lesquelles il a des jobs : register, start, stop (attend une prise en vol, dont les jobs reviennent sans être comptés, puis les tentatives en cours), runDue |
reportFailedBackgroundJobs(reporter) |
l'observateur qui envoie au rapporteur d'erreurs une tentative en échec inattendu |
import type {  BackgroundJob,  BackgroundJobExecution,  Clock,  ErrorReporter,  ExecutionScope,  IdGenerator,  Logger,  Metrics,} from '@ddd-ts-kit/kernel';import { InMemoryJobStore, QueueWorker, reportFailedBackgroundJobs, StoredJobQueue } from '@ddd-ts-kit/scheduling';import { captureTraceparent } from '@ddd-ts-kit/tracing';
declare const clock: Clock, ids: IdGenerator, scope: ExecutionScope, logger: Logger, metrics: Metrics, errors: ErrorReporter;interface CompileStatementsPayload {  readonly month: string;}declare class CompileStatementsBackgroundJob implements BackgroundJob<CompileStatementsPayload> {  static readonly jobName: 'billing.compile-statements';  run(payload: CompileStatementsPayload, execution: BackgroundJobExecution): Promise<void>;}declare const job: CompileStatementsBackgroundJob;
const store = new InMemoryJobStore(); // KnexJobStore, DrizzleJobStore ou RedisJobStore en production// la JobQueue sur laquelle un cas d'usage met en file : jobs.enqueue(CompileStatementsBackgroundJob, { month: '2026-10' })export const jobs = new StoredJobQueue({ store, clock, ids, scope, traceparent: captureTraceparent });
const worker = new QueueWorker({  store,  clock,  scope,  logger,  metrics,  concurrency: { billing: 4, default: 1 }, // la file d'un job est son contexte  onRun: reportFailedBackgroundJobs(errors),});
worker.register({  name: CompileStatementsBackgroundJob.jobName,  options: { maxAttempts: 3 },  // la charge utile revient du store en JSON brut  run: (payload, execution) => job.run(payload as CompileStatementsPayload, execution),});await worker.start();
@ddd-ts-kit/di fait tout cela : kernelModule({ jobStore }) lie le store, la file et le
worker, les jobs déclarés sont enregistrés sur le worker, et le worker tourne dans les
processus qui exécutent les jobs (jobs: { start: true }).
Option de QueueWorker |
Par défaut | |
|---|---|---|
concurrency |
1 |
tentatives simultanées d'une file dans ce processus : un nombre, ou { <queue>: n, default: n } |
pollIntervalMs |
1000 |
combien de temps une file inactive attend avant de redemander au store |
graceMs |
30000 |
combien de temps stop() attend les tentatives en cours avant de les annuler ; une tentative annulée rend son job sans qu'il soit compté |
timers |
le runtime | ManualJobTimers dans une spec |
Chaque tentative est enregistrée comme un BackgroundJobRun (succeeded, retried, dead,
released, interrupted), journalisée au niveau info, warn ou error, et comptée dans
background_job_runs_total et background_job_duration_ms (BACKGROUND_RUNS_COUNTER,
BACKGROUND_DURATION_HISTOGRAM), étiquetés job, context, status et error_code. Un store à
vous passe jobStoreContract de @ddd-ts-kit/testing/contracts, avec son unité de travail.
Gestionnaires de processus
Section intitulée « Gestionnaires de processus »StoredProcessRunner est le ProcessRunner du kernel : new StoredProcessRunner({ store, jobs, commands, unitOfWork }). Une étape s'exécute dans une unité de travail : l'instance est
chargée, l'étape décide, les délais d'expiration qu'elle désarme sont annulés et ceux qu'elle arme
sont mis en file sur la JobQueue comme jobs différés du timeoutJob du processus
(NoTimeoutJobError s'il n'en a pas), l'état est enregistré à la version suivante, puis les
commandes sont envoyées. timeout(process, { id, timeout, jobId }, step) ne s'exécute que tant
que jobId est le job armé de ce délai d'expiration. @ddd-ts-kit/di le lie sur
ProcessStore, JobQueue, CommandBus et UnitOfWork. Voir
Sagas et gestionnaires de processus.
- Aucune persistance propre. Les exécutions, les issues et
lastRunvivent dans la mémoire de l'instance ;describe()est la vue d'une instance, et seulcheckpointstraverse un redémarrage. - Ni nouvelle tentative ni temporisation (backoff). Une occurrence en échec est terminée.
Placez la nouvelle tentative là où est l'échec : un aspect sur l'adaptateur (
retryde@ddd-ts-kit/aspects), ou une commande qui supporte d'être renvoyée à l'occurrence suivante. - Résolution à la minute pour le cron, à la milliseconde pour les intervalles ; un intervalle inférieur à une seconde est possible et rarement judicieux, car chaque occurrence coûte un verrou.
- Au plus une fois par occurrence, au mieux, comme dit plus haut. Exactement une fois n'existe pas ici.
- Le planificateur n'est pas une file. Un job planifié fait une quantité bornée de travail selon une planification. Le travail qu'une commande demande, qui ne doit pas être perdu et doit être retenté, est un job en arrière-plan (plus haut).
- Le worker : au moins une fois, aucun ordre, concurrence par processus, interrogation périodique (polling) : voir les limites de Jobs en arrière-plan.
- Un processus, une boucle d'événements. Un job qui bloque la boucle retarde tous les autres
jobs ; au-delà de
lateAfterMs, leurs occurrences sont manquées. - Les règles des fuseaux horaires sont celles du runtime. Un fuseau dont les règles ont changé demande un Node à jour. Deux changements de décalage à moins de deux jours d'intervalle, ce qu'aucun fuseau ne connaît, ne sont pas gérés.