
Brokers de messages : en processus, RabbitMQ, Kafka, NATS JetStream, Redis Streams
Résumé. Les événements d'intégration entre contextes délimités (bounded contexts) partent par l'outbox transactionnelle et atteignent les consommateurs au moins une fois ; le broker est le transport entre les deux, derrière deux ports du noyau. Le kit livre cinq providers qui passent la même suite de contrat : le bus en mémoire, RabbitMQ, Apache Kafka, NATS JetStream et Redis Streams (sur Redis, Dragonfly ou Valkey). Ils ne sont pas interchangeables dans ce qu'ils garantissent : seul Kafka garde l'ordre des événements d'un agrégat, seuls RabbitMQ et Kafka confirment après une écriture répliquée sur disque, et Redis Streams garde les événements en mémoire. Commencez sans broker ; ajoutez-en un quand un contexte tourne dans son propre processus, et choisissez-le selon l'ordre, la durabilité et ce que votre équipe exploite déjà.
Ce que le broker fait ici, et ce qu'il ne fait pas
Section intitulée « Ce que le broker fait ici, et ce qu'il ne fait pas »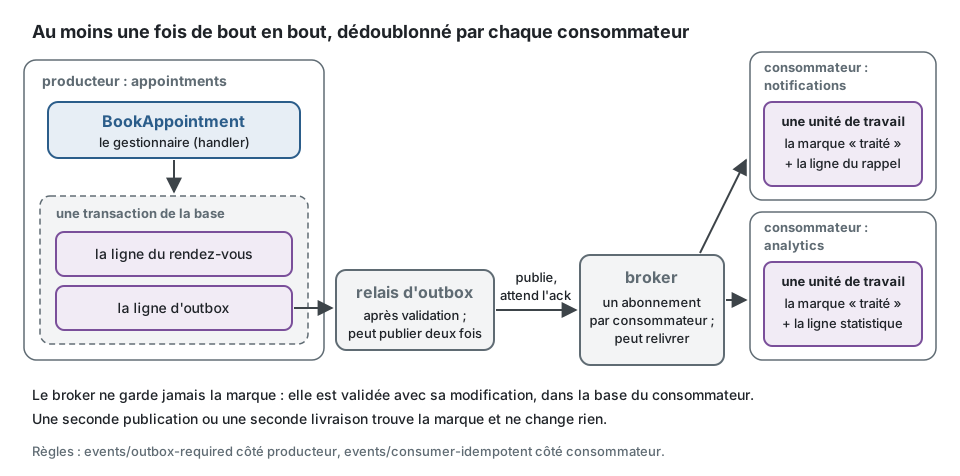
Quel que soit le broker, trois choses sont fixées par l'architecture (events/outbox-required,
events/consumer-idempotent dans ARCHITECTURE.md) :
- l'événement est écrit dans l'outbox dans la transaction de la commande, jamais envoyé au broker par un gestionnaire (outbox transactionnelle) ;
- le relais publie et peut publier deux fois ; le broker peut livrer deux fois ; le consommateur déduplique avec un registre des événements traités dans sa propre base de données (livraison et idempotence) ;
- le registre des événements traités n'est jamais dans le broker ni dans Redis : la marque doit être validée avec la modification d'état qu'elle représente.
« Exactement une fois » n'est donc pas une propriété à acheter. Le travail du broker est de garder les événements de façon durable entre deux processus, de donner à chaque consommateur son propre abonnement, de réessayer un nombre borné de fois et de mettre de côté ce qui ne peut pas être traité.
Ce que la première règle veut dire dans le code. Au lieu d'envoyer au broker depuis le gestionnaire :
await this.appointments.save(appointment);await this.rabbit.publish([booked]); // la validation peut encore échouer après cette ligne : un événement pour une réservation qui n'existe paspubliez vers le port IntegrationEventPublisher depuis le gestionnaire d'un événement du
domaine. La racine de composition lie ce port à l'OutboxPublisher, qui ne fait qu'ajouter une
ligne dans la transaction de la commande ; le relais l'envoie après la validation, quel que soit
le broker derrière lui :
import { defineIntegrationEvent } from '@ddd-ts-kit/events';import { IdGenerator, IntegrationEventPublisher, type DomainEvent } from '@ddd-ts-kit/kernel';import { zodSchema } from '@ddd-ts-kit/validation/zod';import { z } from 'zod';
// contexts/appointments/domain/events/appointment-booked.event.tsexport class AppointmentBooked implements DomainEvent {  static readonly eventName = 'appointments.appointment.booked';
  readonly name = AppointmentBooked.eventName;
  constructor(    readonly aggregateId: string,    readonly occurredAt: Date,    readonly startsAt: Date,  ) {}}
// contexts/appointments/published-language/appointment-booked.v1.integration-event.tsexport const appointmentBooked = defineIntegrationEvent({  type: 'appointments.appointment.booked',  version: 1,  description: 'An appointment was booked.',  payload: zodSchema(z.object({ appointmentId: z.string(), startsAt: z.iso.datetime() })),});
// contexts/appointments/application/integration/publishers/appointment-booked.publisher.tsexport class AppointmentBookedPublisher {  constructor(    private readonly publisher: IntegrationEventPublisher,    private readonly ids: IdGenerator,  ) {}
  async handle(event: AppointmentBooked): Promise<void> {    const published = appointmentBooked.create(      { appointmentId: event.aggregateId, startsAt: event.startsAt.toISOString() },      { id: this.ids.next(), occurredAt: event.occurredAt },    );
    // Lié à l'outbox : une ligne dans la transaction de la commande, pas un message sur le réseau.    await this.publisher.publish([published]);  }}
Dans un projet, le publisher est déclaré avec @DomainEventHandler(AppointmentBooked),
rattaché au eventName que déclare la classe d'événement, et le générateur l'écrit
(événements du domaine et d'intégration).
Comparaison
Section intitulée « Comparaison »Versions des serveurs et licences vérifiées le 2026-10-10 (versions publiées sur GitHub et fichiers de licence). Les lignes « kit » reprennent ce qu'affirment les README des providers.
| En processus | RabbitMQ | Apache Kafka | NATS JetStream | Redis Streams | |
|---|---|---|---|---|---|
| Nature | des appels de fonction dans un processus | broker à files d'attente (AMQP 0-9-1) | journal répliqué et partitionné | persistance de streams sur NATS | journal en mémoire dans un serveur clé-valeur |
| Serveur et licence | aucun | 4.3.6, MPL 2.0 | Apache 2.0 (kit testé contre la 4.3, KRaft ; dernière version non revérifiée) | 2.15.1, Apache 2.0 | Redis 8.10.2 (RSALv2, SSPLv1 ou AGPLv3), Valkey 9.1.2 (BSD-3), Dragonfly 2.0.2 (BSL 1.1) |
| La confirmation d'une publication veut dire | les gestionnaires ont tourné | le broker l'a prise ; les files quorum répliquent avant de confirmer | écrite sur les réplicas synchronisés (acks=all) |
stockée dans le stream | gardée en mémoire par un serveur |
| Survit à un plantage du serveur | non (l'outbox, oui) | oui, avec des files quorum durables | oui, avec un facteur de réplication de 3 et min.insync.replicas=2 |
oui, selon le stockage et les réplicas du stream | dépend des réglages de persistance ; peut perdre des entrées acquittées |
| Ordre | par clé avec un seul relais, dans un processus | aucun | par partition, donc par clé | aucun | aucun entre instances |
| Rétention | aucune | jusqu'à la consommation | par durée ou par taille, rejouable | selon les limites que vous fixez ; rejouable | bornée par la mémoire ; le rognage ignore les entrées non lues |
| Un nouveau consommateur voit l'historique | non | non | oui (commence au plus ancien par défaut) | oui (politique de distribution all) |
non par défaut (commence à la fin) |
| Déduplication côté publication | pas nécessaire | aucune | nouvelles tentatives du client seulement, pas celles du relais | par identifiant de message, dans une fenêtre courte (deux minutes par défaut) | aucune (clé de garde facultative) |
| Nouvelles tentatives dans le provider du kit | le délai croissant du relais | délai fixe, file de nouvelle tentative | délai fixe, sur place, bloque la partition | délai fixe | délai fixe |
| Files de rejet (dead letters) | l'outbox (dead) |
une file de rejet par file de consommateur | un topic de rejet | un stream de rejet | un stream de rejet |
| Client utilisé par le kit | aucun | amqplib 2.2 | @confluentinc/kafka-javascript 1.11 (module natif) |
@nats-io/transport-node, @nats-io/jetstream 3.4 |
ioredis 6 |
| Exploitation | aucune | un cluster, des files à surveiller | un cluster, des partitions, le retard des consommateurs | un serveur léger, des streams à dimensionner | un serveur que vous faites peut-être déjà tourner |
Critères de choix
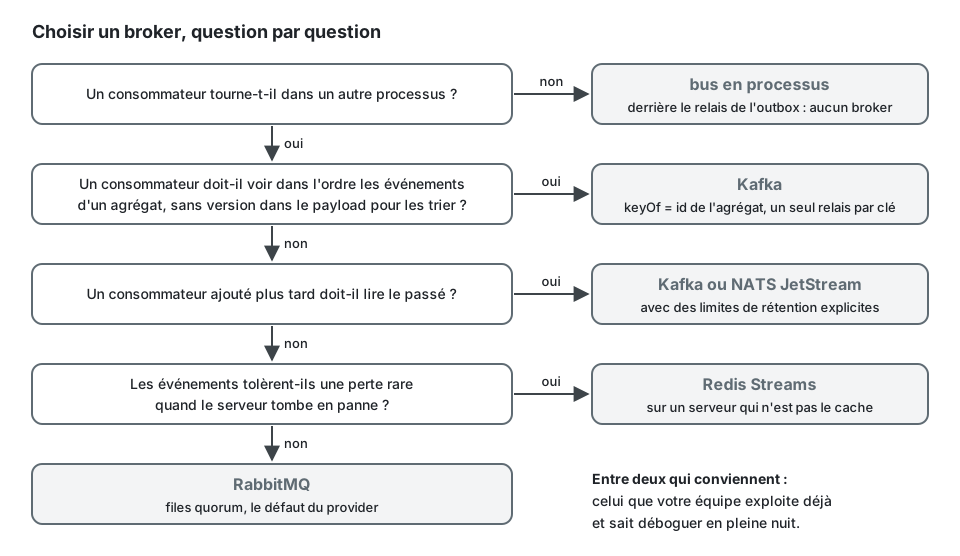
Section intitulée « Critères de choix »- Existe-t-il deux processus ? Tant que tous les contextes tournent dans un seul processus, le bus en mémoire derrière le relais de l'outbox suffit, et une extraction plus tard change le provider, pas les gestionnaires (monolithe modulaire).
- L'ordre des événements d'un agrégat compte-t-il pour un consommateur ? Si
analyticsdoit voirbookedavantcancelledpour un même rendez-vous et ne peut pas utiliser une version dans le payload, seul Kafka le donne, sous conditions (plus bas). La réponse la moins chère est presque toujours de porter une version ou une séquence dans le payload et de laisser le consommateur ignorer les événements périmés. - Un événement acquitté peut-il jamais être perdu ? Avec Redis Streams, oui, selon la persistance. Pour des rappels, cela peut être acceptable ; pour la facturation, cela ne l'est pas.
- Un consommateur ajouté l'an prochain doit-il lire les événements de cette année ? Seul un journal avec rétention le permet (Kafka, JetStream).
- Qu'exploite l'équipe aujourd'hui ? Un broker que personne dans l'équipe ne sait déboguer la nuit est un plus mauvais choix qu'un moins puissant qu'elle connaît.
- Contraintes de construction et d'image. Le client Kafka est un module natif avec un script d'installation.
La deuxième question trouve d'ordinaire sa réponse dans le payload, pas dans le broker. Un producteur qui met la version de l'agrégat dans son événement permet à chaque consommateur d'ignorer ce qui arrive en retard, sur n'importe quel broker, à travers les redémarrages et les relivraisons :
import { consume, defineIntegrationEvent } from '@ddd-ts-kit/events';import type { ProcessedEventStore, UnitOfWork } from '@ddd-ts-kit/kernel';import { zodSchema } from '@ddd-ts-kit/validation/zod';import { z } from 'zod';
export const appointmentStatusChanged = defineIntegrationEvent({  type: 'appointments.appointment.status-changed',  version: 1,  description: 'The status of an appointment changed.',  payload: zodSchema(    z.object({      appointmentId: z.string(),      status: z.enum(['booked', 'cancelled']),      // La version de l'agrégat après la modification : ce qui permet à un consommateur de trier les événements.      appointmentVersion: z.number().int().positive(),    }),  ),});
interface OccupancyRow {  readonly status: 'booked' | 'cancelled';  readonly appointmentVersion: number;}
declare const occupancy: {  find(appointmentId: string): Promise<OccupancyRow | undefined>;  save(appointmentId: string, row: OccupancyRow): Promise<void>;};declare const processed: ProcessedEventStore;declare const unitOfWork: UnitOfWork;
// analytics : la marque de l'événement et la ligne sont validées ensemble, dans une unité de travail.export const occupancyOnStatusChanged = consume(  appointmentStatusChanged,  { consumer: 'analytics.occupancy-on-status-changed', processed, unitOfWork },  async ({ payload }) => {    const known = await occupancy.find(payload.appointmentId);
    if (known !== undefined && known.appointmentVersion >= payload.appointmentVersion) {      return; // dépassé : une modification plus récente de ce rendez-vous est déjà appliquée    }
    await occupancy.save(payload.appointmentId, { status: payload.status, appointmentVersion: payload.appointmentVersion });  },);
Avec ce champ, cancelled qui arrive avant booked n'est plus un problème : booked arrive en
second, porte une version plus basse, et il est ignoré.
Ce que ce kit prend en charge et a vérifié
Section intitulée « Ce que ce kit prend en charge et a vérifié »Les quatre providers de broker implémentent IntegrationEventPublisher et
IntegrationEventSubscriber, passent eventBusContract, partagent l'enveloppe, les noms des
en-têtes, les noms des options et les méthodes (forConsumer, assertTopology,
describeTopology, replayDead, close), se reconnectent avec un délai croissant, traitent un
message illisible comme un poison, et ne laissent voyager que les codes d'erreur, jamais les
messages d'erreur. Les faits ci-dessous viennent des README des packages
(rabbitmq, kafka,
nats, redis,
events).
| Provider | Testé avec | Topologie par consommateur | Limites déclarées |
|---|---|---|---|
| en mémoire | la suite de contrat | les gestionnaires tournent dans publish |
un processus ; une relivraison exécute à nouveau chaque gestionnaire du type |
| RabbitMQ | amqplib 2.2, RabbitMQ 4.3 ; seul RabbitMQ a été exécuté | un exchange de type topic ; une file de travail, une file de nouvelle tentative et une file de rejet par consommateur et par type d'événement, quorum par défaut | pas d'ordre ; un seul délai de nouvelle tentative ; arguments des files fixés à la création ; les files classiques peuvent perdre une nouvelle tentative expirée lors d'un plantage du broker ; le chemin du plantage en plein gestionnaire relève du broker et n'est pas exercé par la suite |
| Kafka | client 1.11 (librdkafka 2.16), Apache Kafka 4.3 en mode KRaft, Node 24 ; seul Apache Kafka a été exécuté | un groupe de consommateurs par contexte consommateur, un topic par type d'événement, un topic de rejet | un enregistrement en échec retarde sa partition ; une validation (commit) par enregistrement ; le gestionnaire doit finir dans maxHandlingMs ; transactions non utilisées ; partitions d'un topic existant jamais modifiées |
| NATS JetStream | client 3.4, NATS Server 2.15 avec -js, Node 24 |
un consommateur pull durable par consommateur et par type d'événement, un stream de rejet | pas d'ordre ; le gestionnaire doit finir dans ackWaitMs ; fenêtre de doublons courte ; rétention limits sans limite fixée par défaut ; des noms qui diffèrent par un caractère remplacé entrent en collision |
| Redis Streams | ioredis 6 contre Dragonfly 2.0.2, Valkey 9.1.2 et Redis 8.10.2, même suite, mêmes résultats | un groupe de consommateurs par consommateur, un stream de rejet | la durabilité est un réglage du serveur ; pas de déduplication côté publication ; rétention bornée par la mémoire ; une entrée à la fois par stream et par instance ; à faire tourner avec noeviction, pas sur le serveur du cache |
Non vérifié par les suites de tests, tel que chaque README le liste :
- Kafka : un cluster de plusieurs brokers (élection de leader, ensemble synchronisé qui se réduit), TLS et SASL, l'assignateur coopératif et le protocole de groupe de nouvelle génération, un consommateur tué en plein gestionnaire, une erreur fatale du producteur, des brokers antérieurs à la 4.3, Debezium à la place du relais.
- NATS : un cluster de plusieurs serveurs, TLS et l'authentification, une attente d'acquittement
qui expire pendant un gestionnaire, un consommateur tué en plein gestionnaire, la rétention
interest, des serveurs antérieurs à la 2.15, le transport WebSocket. - Redis Streams : Redis Cluster (« not tested on a cluster » ; les clés doivent partager un slot).
- RabbitMQ : les autres brokers AMQP 0-9-1 ; la limite de livraison des files quorum après le plantage d'un consommateur.
Autrement dit : chaque provider a été éprouvé contre un nœud unique, sur une machine de développeur ou en CI. Le comportement multinœud, la configuration de sécurité et la reprise après plantage du processus consommateur sont à tester par vous avant la production.
Comme les quatre partagent leurs noms d'options, changer de broker est une modification de la
plateforme, dans src/platform/events/create-event-provider.ts pour un projet généré. Les
gestionnaires, l'outbox et les consommateurs restent tels quels :
import { KafkaEventBus } from '@ddd-ts-kit/kafka';import type { EventBus } from '@ddd-ts-kit/kernel';import { NatsEventBus } from '@ddd-ts-kit/nats';import { RabbitMqEventBus } from '@ddd-ts-kit/rabbitmq';import { RedisStreamsEventBus } from '@ddd-ts-kit/redis/event-bus';
declare const url: string;declare const broker: 'rabbitmq' | 'kafka' | 'nats' | 'redis';
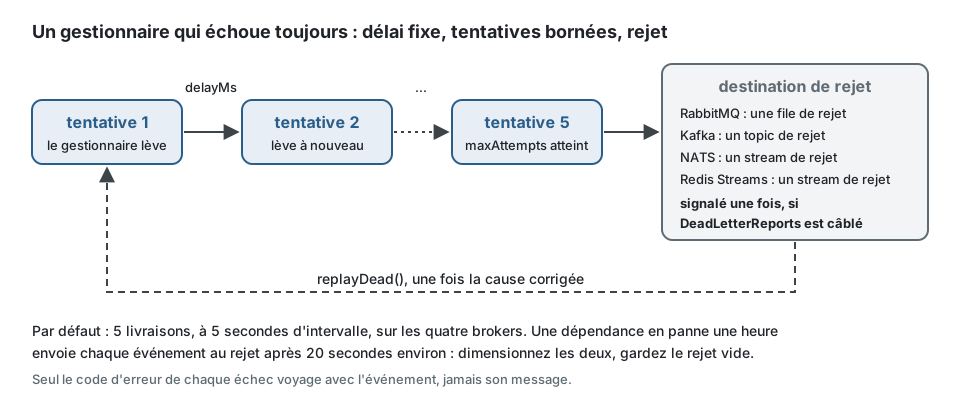
// La même politique partout : cinq livraisons, à cinq secondes d'intervalle (les défauts), puis la destination de rejet.const retry = { maxAttempts: 5, delayMs: 5_000 };
const providers: Record<typeof broker, () => EventBus> = {  rabbitmq: () => new RabbitMqEventBus({ connection: url, retry }), // files quorum par défaut  kafka: () => new KafkaEventBus({ brokers: url, retry }), // keyOf : la clé de chaque enregistrement, pour l'ordre  nats: () => new NatsEventBus({ connection: url, retry }),  redis: () => new RedisStreamsEventBus({ connection: url, retry }), // Redis, Valkey ou Dragonfly};
export const bus = providers[broker]();
Quand un gestionnaire échoue sans cesse, les quatre font la même chose :
Ce que le kit ne fournit pas du tout : SQS/SNS, Google Pub/Sub, Azure Service Bus, Pulsar,
Redpanda (peut fonctionner comme broker au protocole Kafka ; jamais exécuté), la capture des
changements de données (change data capture, décrite comme une stratégie de relais, non livrée),
un délai croissant côté consommation (un seul délai fixe partout), les transactions Kafka, les
registres de schémas, et les sagas ou gestionnaires de processus
(sagas et gestionnaires de processus).
stack.broker: custom génère pour vous un fichier de bus et sa spec de contrat à remplir.
L'ordre avec Kafka ne tient que si tout ceci est vrai : keyOf donne l'identifiant de
l'agrégat, le relais tourne avec ordering: 'per-key' et la même clé, un seul relais tourne,
et le topic garde son nombre de partitions. La mémoire par clé du relais est perdue au
redémarrage, si bien qu'un événement peut en dépasser un autre une fois après un plantage ; l'ordre
strict à travers les redémarrages est déclaré comme non fait.
Limites, et quand ne pas l'utiliser
Section intitulée « Limites, et quand ne pas l'utiliser »- Un broker ne remplace pas l'outbox. Publier depuis un gestionnaire perd des événements quand la validation échoue après la publication, ou en invente quand la publication échoue après la validation.
- Un broker ne rend pas les consommateurs idempotents. Chaque provider relivre.
- Le même délai fixe de nouvelle tentative sur les quatre : une dépendance en panne pendant
une heure envoie les événements vers la destination de rejet après
maxAttemptsfois le délai. Dimensionnez les deux, surveillez la destination de rejet (elle doit être vide), et utilisezreplayDeadaprès la correction. - Redis Streams sur le serveur du cache : une politique d'éviction qui convient à un cache
peut évincer un stream. Des serveurs séparés, ou
noeviction. - Les nouveaux consommateurs et l'historique diffèrent selon le provider (voir le tableau) : un consommateur ajouté à Kafka ou à JetStream rejoue ce qui est retenu et doit tolérer de vieux événements ; un consommateur ajouté à RabbitMQ ou à Redis Streams part de maintenant et a besoin d'un rattrapage par d'autres moyens.
Quand ne pas ajouter de broker : un seul déployable, une seule équipe, aucun consommateur hors
du processus. Le provider en mémoire derrière l'outbox a la même sémantique pour les
gestionnaires, et npm run dev a besoin d'un conteneur de moins.
Recommandation selon la situation
Section intitulée « Recommandation selon la situation »| Situation | Choix |
|---|---|
| Monolithe modulaire, un seul déployable | en processus, relais de l'outbox réveillé par la base de données ou par scrutation |
| Premier contexte extrait, l'équipe connaît RabbitMQ, aucun besoin d'ordre | RabbitMQ avec des files quorum |
| Ordre par agrégat exigé par les consommateurs, rejeu de l'historique, nombreux consommateurs | Kafka, si quelqu'un sait l'exploiter ; sinon une version dans le payload et RabbitMQ |
| Petit budget d'exploitation, rejeu voulu, ordre pas nécessaire | NATS JetStream, avec des limites de rétention fixées explicitement |
| Redis, Valkey ou Dragonfly déjà exploité, volume modéré, événements qui tolèrent une perte rare | Redis Streams, sur un serveur qui n'est pas le cache |
| Un service de files d'attente cloud imposé | un provider custom tenu à eventBusContract, selon le tableau des stratégies du package events |
Quel que soit le choix, écrivez-le dans la documentation d'intégration du projet (garanties de livraison, politique de nouvelles tentatives et de rejet, façon de rejouer) et consignez-le dans un enregistrement de décision.
- Documentation de RabbitMQ : confirmations de publication https://www.rabbitmq.com/docs/confirms , files quorum https://www.rabbitmq.com/docs/quorum-queues , files de rejet https://www.rabbitmq.com/docs/dlx
- Documentation d'Apache Kafka (
acksdu producteur, idempotence, groupes de consommateurs) : https://kafka.apache.org/documentation/ - Documentation de NATS JetStream : https://docs.nats.io/nats-concepts/jetstream
- Redis Streams : https://redis.io/docs/latest/develop/data-types/streams/ ; Valkey : https://valkey.io/topics/streams-intro/ ; Dragonfly : https://www.dragonflydb.io/docs
- Versions publiées sur GitHub et fichiers de licence de
rabbitmq/rabbitmq-server,nats-io/nats-server,redis/redis,valkey-io/valkey,dragonflydb/dragonfly, lus le 2026-10-10. - Chris Richardson, Microservices Patterns, Manning, 2018, chapitre 3 ; microservices.io : Transactional outbox, Idempotent consumer.
- Gregor Hohpe et Bobby Woolf, Enterprise Integration Patterns, Addison-Wesley, 2003 : Guaranteed Delivery, Dead Letter Channel, Idempotent Receiver.
- Martin Kleppmann, Designing Data-Intensive Applications, O'Reilly, 2017, chapitre 11.
- Non vérifié : la dernière version publiée d'Apache Kafka au jour de la rédaction (le README du kit nomme la 4.3) ; tout comportement des providers sur des clusters multinœuds.