
@ddd-ts-kit/kafka
Le fournisseur d'événements d'intégration pour Apache Kafka : un EventBus du noyau qui publie
avec un producteur idempotent et acks=all, pour que le relais de l'outbox puisse marquer un
enregistrement comme publié en toute sûreté, et qui consomme avec un groupe de consommateurs par
contexte consommateur, des offsets validés une fois les gestionnaires (handlers) terminés, un
nombre borné de nouvelles tentatives (retry) différées sur place et un topic de rejet (dead
letter). C'est la ligne « Kafka and other logs » du tableau des stratégies de
docs/ARCHITECTURE.md, implémentée, et il passe eventBusContract de @ddd-ts-kit/testing.
npm i @ddd-ts-kit/kafka @ddd-ts-kit/events @confluentinc/kafka-javascriptTesté avec @confluentinc/kafka-javascript 1.11 (librdkafka 2.16) contre Apache Kafka 4.3 en
mode KRaft, sur Node 24. Les autres brokers qui parlent le protocole Kafka devraient
fonctionner ; seul Apache Kafka a été exécuté.
Le client
Section intitulée « Le client »@confluentinc/kafka-javascript est le client maintenu par Confluent : une liaison de
librdkafka avec une API à promesses à la manière de KafkaJS, et c'est celle qu'utilise ce
package.
| Candidat | Examiné le 2026-10-10 | Verdict |
|---|---|---|
kafkajs 2.2.4 |
dernière version publiée en février 2023 | non maintenu : écarté |
@platformatic/kafka 2.14.0 |
JavaScript pur, 2,2 Mo, publié presque chaque semaine, environ 500 000 téléchargements par semaine, demande Node 22.22 ou 24.6 | une option sérieuse sans code natif ; son protocole de groupe de consommateurs est une réimplémentation jeune et sa plage de moteurs est au-dessus de celle de ce kit (22.12) |
@confluentinc/kafka-javascript 1.11.0 |
publié le 2026-10-07, environ 830 000 téléchargements par semaine, librdkafka dessous | choisi : le producteur idempotent, le protocole de rééquilibrage et la reconnexion sont ceux du client C de référence, et c'est là qu'un fournisseur ne doit pas être à peu près juste |
Le prix est un module natif. Rien n'est compilé quand un binaire précompilé existe : le script
d'installation du package en télécharge un (13 Mo, 30 Mo une fois installé) depuis les
versions publiées du client sur GitHub. Des binaires précompilés existent pour Linux x64 et
arm64 sur glibc et musl, macOS arm64 et Windows x64, pour Node 18 à 24. Vérifié ici : Ubuntu
avec Node 24.21, et les images node:24-alpine et node:24-bookworm-slim, chacune sans
compilateur, en cinq secondes environ.
Ce que cela demande à la CI et aux images :
- le script d'installation doit s'exécuter : pas de
--ignore-scripts, et avec un gestionnaire de paquets qui demande d'approuver les scripts d'installation (npm 11 avertit, pnpm bloque), approuvez ce package ; le client documente npm comme pris en charge, Yarn et pnpm comme expérimentaux ; - l'installation doit pouvoir joindre
github.com; derrière un proxy qui l'interdit, faites un miroir du binaire et pointeznode-pre-gypvers ce miroir, sinon l'installation se rabat sur la compilation de librdkafka, qui demande Python, make et un compilateur C++ et prend des minutes ; - construisez l'image sur la libc avec laquelle elle tourne : un
node_modulesinstallé sur Debian ne se charge pas sur Alpine ; - rien d'autre n'est nécessaire à l'exécution : le binaire n'est lié qu'à la libc et à libstdc++.
Racine de composition
Section intitulée « Racine de composition »Les gestionnaires ne voient jamais ce package. Ils publient vers l'outbox ; le relais publie
vers Kafka ; chaque contexte consommateur écoute par le bus sous son propre nom. Le bus est
donné à l'application sous la forme de deux ports du noyau : IntegrationEventPublisher reste
l'outbox, et EventSubscribers remet à chaque contexte l'abonné de son propre nom de
consommateur.
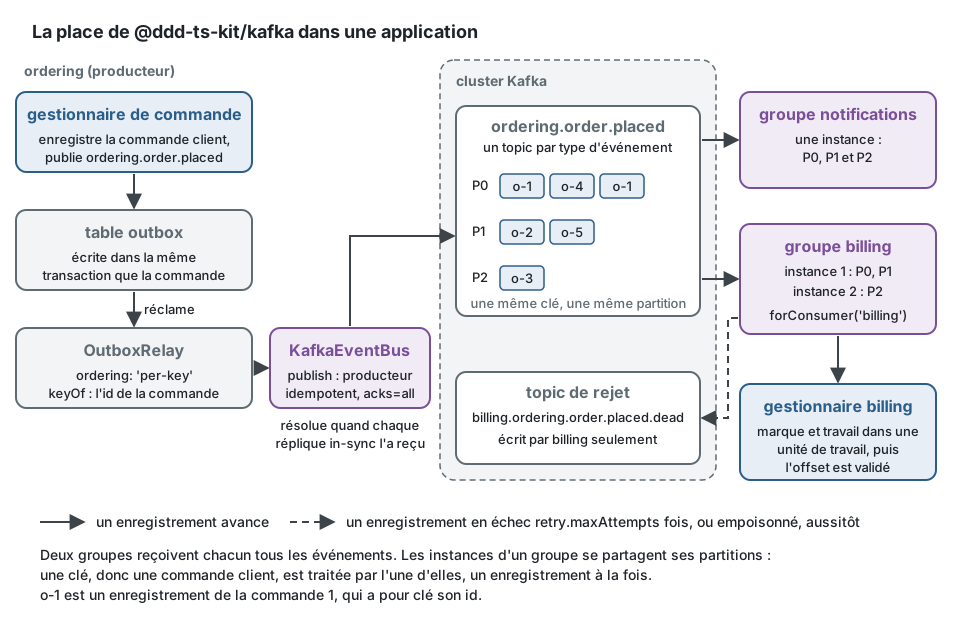
init --broker kafka écrit ce câblage dans la plateforme du projet : le bus est construit par
platform/events/create-event-provider.ts, avec la clé de platform/events/aggregate-key-of.ts,
platform/platform.module.ts y lie de nouveau EventSubscribers, et main.ts le donne, tracé, au
relais de l'outbox de platform/events/start-outbox-relay.ts, qui tourne en
ordering: 'per-key' avec la même clé. À la main, la même chose s'écrit :
import { defineContextModule } from '@ddd-ts-kit/di';import { EventSubscribers, IntegrationEventPublisher, type IntegrationEvent } from '@ddd-ts-kit/kernel';import { OutboxPublisher, OutboxStore, type IntegrationEventDefinition } from '@ddd-ts-kit/events';import { KafkaEventBus } from '@ddd-ts-kit/kafka';
// La clé d'ordre, donnée au relais et au bus : l'id de l'agrégat dont parle un événement.export const aggregateOf = (event: IntegrationEvent): string | undefined =>  orderPlaced.is(event) ? event.payload.orderId : undefined;
export const bus = new KafkaEventBus({  brokers: config.kafkaBrokers, // 'kafka-1:9092,kafka-2:9092' ou une liste  client: { 'security.protocol': 'sasl_ssl', 'sasl.mechanism': 'SCRAM-SHA-512' /* ... */ },  keyOf: aggregateOf, // par défaut : l'id de l'événement, qui n'ordonne rien  publishedTypes: ['billing.invoice.issued'], // leurs topics sont créés par assertTopology  topics: { partitions: 6, replicationFactor: 3 }, // par défaut : ceux du broker  retry: { maxAttempts: 5, delayMs: 5_000 }, // les valeurs par défaut  onFailure: (failure) => logger.warn('event bus failure', { ...failure }), // des codes seulement, jamais un message d'erreur  onDelivery: ({ consumer, topic, outcome }) => deliveries.add(1, { consumer, topic, outcome }),});
export const messagingModule = defineContextModule({  name: 'messaging',  register(builder) {    // Côté publication : les gestionnaires écrivent dans l'outbox, dans la transaction de la commande.    builder.rebind(IntegrationEventPublisher).toClass(OutboxPublisher, [OutboxStore]);    // Côté consommation : un abonné par contexte consommateur, à son nom.    builder.rebind(EventSubscribers).toValue({ forContext: (name) => bus.forConsumer(name) });  },});
// Ce que le projet a ailleurs, déclaré pour que cet exemple compile seul.declare const orderPlaced: IntegrationEventDefinition<{ readonly orderId: string }>;declare const config: { readonly kafkaBrokers: string };declare const logger: { warn(message: string, fields: object): void };declare const deliveries: { add(value: number, attributes: Record<string, string>): void };import type { IntegrationEventDefinition } from '@ddd-ts-kit/events';import { CommandBus, systemActor, type Actor, type Command, type IntegrationEvent } from '@ddd-ts-kit/kernel';import { IntegrationEventHandler } from '@ddd-ts-kit/kernel/declarations';
@IntegrationEventHandler(orderPlaced, { consumer: 'billing.invoice-on-order-placed' })export class InvoiceOnOrderPlacedIntegrationHandler { constructor(private readonly commands: CommandBus) {}
// Personne n'appelle : le gestionnaire agit comme un acteur système nommé d'après son consommateur. readonly actor = systemActor('billing.invoice-on-order-placed');
async handle(event: IntegrationEvent<OrderPlacedPayload>): Promise<void> { await this.commands.execute(new IssueInvoice(this.actor, event.payload.orderId)); }}
// Ce que le projet a ailleurs : le langage publié d'ordering, la commande de billing.interface OrderPlacedPayload { readonly orderId: string;}declare const orderPlaced: IntegrationEventDefinition<OrderPlacedPayload>;declare const IssueInvoice: new (actor: Actor, orderId: string) => Command;import { contextModule, createApplication, kernelModule } from '@ddd-ts-kit/di';import { Clock } from '@ddd-ts-kit/kernel';import { OutboxRelay, OutboxStore } from '@ddd-ts-kit/events';import { aggregateOf, bus, messagingModule } from '@/platform/messaging.module';
const app = createApplication({ modules: [ kernelModule(), persistenceModule, messagingModule, contextModule('ordering', orderingDeclarations), contextModule('billing', billingDeclarations), ],});
// La cible du relais est le bus. Un enregistrement est marqué publié quand chaque réplique in-sync l'a.const relay = new OutboxRelay({ store: app.resolve(OutboxStore), publisher: bus, clock: app.resolve(Clock), ordering: 'per-key', // un seul relais en marche : les événements d'un agrégat partent dans l'ordre keyOf: aggregateOf,});
await app.start(); // abonne le gestionnaire de billing sur bus.forConsumer('billing')await bus.assertTopology(); // échouer au démarrage, pas au premier enregistrementrelay.start({ intervalMs: 500 });
process.on('SIGTERM', async () => { await relay.stop(); // le tour en cours se termine await app.stop(); // les gestionnaires sont désabonnés await bus.close(); // les consommateurs s'arrêtent, les gestionnaires en cours finissent et valident});persistenceModulelieOutboxStore, et lie de nouveauUnitOfWorketProcessedEventStoreà la base de données : voir le README de l'adaptateur de persistance. Un gestionnaire d'événement d'intégration déclaré est abonné sur l'abonné de son propre contexte (forContextreçoit le nom de son module), et puisqueUnitOfWorketProcessedEventStoresont liés, sa marque d'idempotence et son travail sont validés dans une seule unité de travail : une nouvelle livraison est dédupliquée, un échec ne laisse rien derrière lui.- Sans outbox, le bus est le bus d'événements du module du noyau, et les gestionnaires publient
directement vers le broker :
kernelModule({ eventBus: bus, eventSubscribers: () => ({ forContext: (name) => bus.forConsumer(name) }) }). - Sans conteneur, les mêmes objets se câblent à la main :
bus.forConsumer('billing')est unIntegrationEventSubscriber, à donner àsubscribeAllet àconsumede@ddd-ts-kit/events. publish(events)ne se résout que quand chaque réplique in-sync a acquitté chaque enregistrement du lot, et rejette sinon (PUBLISH_NOT_ACKNOWLEDGEDavec le code de librdkafka dansreason,BROKER_UNAVAILABLE,EVENT_BUS_CLOSED). Rien n'est mis en tampon pour plus tard : l'outbox est le tampon.- Un nom de consommateur est requis pour s'abonner, et c'est l'id du groupe de consommateurs,
tel quel :
bus.forConsumer('billing')donne unIntegrationEventSubscriberpour un contexte sur les clients du bus (un monolithe modulaire en a plusieurs), et l'optionconsumernomme celui pour lequel travaillebus.subscribe. Un contexte extrait dans son propre service garde son nom, donc son groupe et ses offsets : rien ne change sur le cluster. - Le traçage s'applique de l'extérieur des deux côtés, comme avec tout fournisseur :
tracedPublisher(bus)comme cible du relais, et côté consommation l'instrumentation du module du noyau (kernelModule({ instrumentation: traceApplication() })), qui donne à chaque gestionnaire déclaré un spanprocess <consumer>par tentative.tracedSubscriber(bus.forConsumer(name))sert à une composition sanskernelModule. Le bus transportetraceparentetcorrelationIdintacts, dans l'enveloppe et dans les en-têtes de l'enregistrement. - La corrélation fait l'aller-retour. Publiez par
scopedPublisher(publisher, scope)du noyau : un gestionnaire déclaré (ouconsume(definition, { ..., scope }, handler)à la main, ou un callback enveloppé parinEventScope) s'exécute dans un contexte d'exécution dont lecorrelationIdest celui de la requête HTTP qui a publié, dont lecausationIdest l'événement, et une nouvelle tentative s'exécute dans le même. - La capture des changements de données (le routeur d'événements d'outbox de Debezium) peut remplacer le relais et le côté publication de ce bus ; donnez-lui les mêmes topics, clés et en-têtes. Le côté consommation reste.
Topologie
Section intitulée « Topologie »bus.describeTopology() renvoie les topics et les groupes sous forme de données, pour une
revue ou un document généré ; bus.assertTopology() crée les topics qui n'existent pas et se
résout une fois que les consommateurs ont leurs partitions. Pour forConsumer('billing') abonné
à ordering.order.placed :
| Objet | Nom | Propriétés |
|---|---|---|
| topic d'événements | ordering.order.placed |
topicOf(type), par défaut le type ; partitions et réplication de topics, ou du broker |
| groupe de consommateurs | billing |
abonné aux topics d'événements de ses types ; commence au plus ancien enregistrement |
| topic de rejet | billing.ordering.order.placed.dead |
<consumer>.<topic>.dead ; écrit par ce consommateur seulement |
| groupe de rejeu | billing.replay |
existe une fois que replayDead a tourné ; ses offsets validés sur les topics de rejet disent ce qui a été rejoué |
La même chose, telle que le bus la décrit :
import { KafkaEventBus, deadTopicOf, replayGroupOf } from '@ddd-ts-kit/kafka';
const bus = new KafkaEventBus({ brokers: 'kafka-1:9092', publishedTypes: ['billing.invoice.issued'] });
bus.forConsumer('billing').subscribe('ordering.order.placed', async () => {});
export const { topics, groups } = bus.describeTopology();// topics: [//   { name: 'billing.invoice.issued', role: 'events', partitions: -1, replicationFactor: -1 },//   { name: 'ordering.order.placed', role: 'events', partitions: -1, replicationFactor: -1 },//   { name: 'billing.ordering.order.placed.dead', role: 'dead', partitions: -1, replicationFactor: -1 },// ]   (-1 : les valeurs par défaut du broker, puisque `topics` n'est pas donné)// groups: [{ groupId: 'billing', topics: ['ordering.order.placed'] }]
export const dead = deadTopicOf('billing', 'ordering.order.placed'); // 'billing.ordering.order.placed.dead'export const replay = replayGroupOf('billing'); // 'billing.replay'
Un topic par type d'événement est le défaut. topicOf: (type) => type.split('.')[0] donne à
la place un topic par contexte producteur : un consommateur lit alors tous les types de ce
contexte et saute, en les validant, ceux auxquels il n'est pas abonné ; c'est ce qui garde
l'ordre entre deux types d'un même agrégat.
Les topics sont aussi créés à la demande : la première publication d'un type crée son
topic, le premier abonnement crée le topic d'événements et le topic de rejet. On ne
compte jamais sur la création automatique par le broker (elle donne une partition et la
réplication par défaut, en silence). Un topic existant n'est jamais modifié : topics ne
s'applique qu'à la création. Avec topics: { create: false }, le bus ne crée rien et un
topic manquant fait échouer la publication.
Un enregistrement est l'enveloppe en JSON (id, type, version, occurredAt, payload,
traceparent, correlationId, tenantId), sa clé est keyOf(event), et ses en-têtes sont
x-event-id, x-event-type, x-event-version, traceparent, x-correlation-id et
x-tenant-id. N'importe quel client Kafka peut le consommer.
Deux consommateurs d'un type sont deux groupes, et tous deux reçoivent chaque événement. Deux instances d'un consommateur sont deux membres de son groupe : chaque partition, donc chaque clé, va à l'une d'elles.
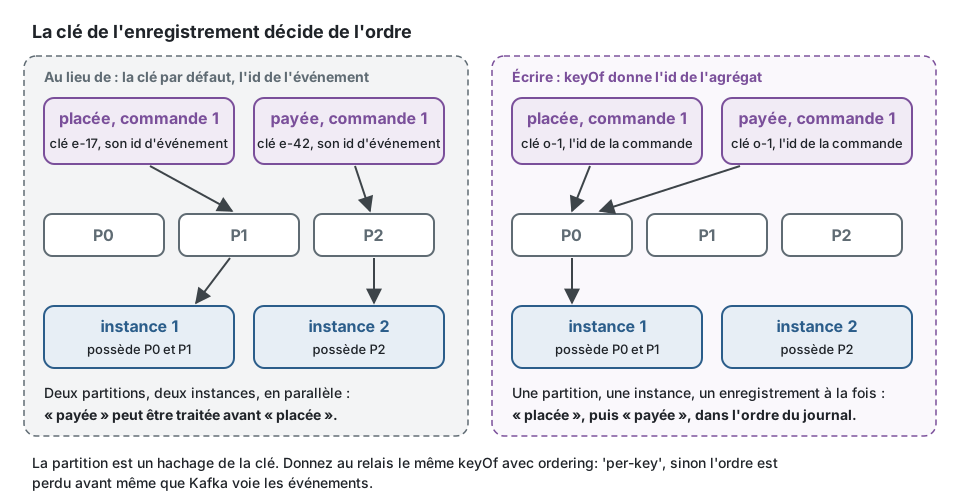
Kafka ordonne les enregistrements d'une partition, et la clé choisit la partition. Donc :
- Donnez à
keyOfl'id de l'agrégat. La clé par défaut est l'id de l'événement : chaque événement est alors seul dans son ordre. - Faites tourner le relais avec
ordering: 'per-key'et le mêmekeyOf, sinon l'ordre est perdu avant que Kafka voie les événements. - Le bus fait le reste : une publication écrit les enregistrements d'un topic dans l'ordre du lot (producteur idempotent : une nouvelle tentative du client ne peut ni les réordonner ni les dupliquer), un consommateur traite les enregistrements d'une partition un à la fois, et un enregistrement en échec est retenté sur place, voir plus bas.
import { OutboxRelay, type IntegrationEventDefinition, type OutboxStore } from '@ddd-ts-kit/events';import { KafkaEventBus } from '@ddd-ts-kit/kafka';import type { Clock, IntegrationEvent } from '@ddd-ts-kit/kernel';
declare const orderPlaced: IntegrationEventDefinition<{ readonly orderId: string }>;declare const orderPaid: IntegrationEventDefinition<{ readonly orderId: string; readonly amount: number }>;declare const store: OutboxStore;declare const clock: Clock;
// Au lieu de : la clé par défaut, l'id de l'événement. Chaque événement est seul dans son ordre :// deux événements d'une même commande peuvent se trouver sur deux partitions et être traités en parallèle.export const unordered = new KafkaEventBus({ brokers: 'kafka-1:9092' });
// Écrire : l'id de l'agrégat, une seule fonction donnée au bus comme au relais.const orderIdOf = (event: IntegrationEvent): string | undefined =>  orderPlaced.is(event) || orderPaid.is(event) ? event.payload.orderId : undefined;
export const bus = new KafkaEventBus({ brokers: 'kafka-1:9092', keyOf: orderIdOf });
// Un seul relais en marche : les enregistrements d'une commande partent dans l'ordre où ils ont été écrits.export const relay = new OutboxRelay({ store, publisher: bus, clock, ordering: 'per-key', keyOf: orderIdOf });
Un événement pour lequel keyOf répond undefined est publié sans clé : Kafka répartit alors
ces enregistrements sur les partitions, et ils ne gardent aucun ordre entre eux.
concurrency est le nombre de partitions qu'un consommateur traite à la fois (1 par défaut) ;
les enregistrements d'une partition ne sont jamais traités en parallèle.
Nouvelles tentatives et rejet
Section intitulée « Nouvelles tentatives et rejet »- Un offset est validé une fois que chaque gestionnaire abonné au type de l'enregistrement
s'est terminé, jamais avant, et jamais automatiquement. Un
@IntegrationEventHandlerdéclaré (ouconsumede@ddd-ts-kit/eventsà la main) valide son travail et sa marque d'idempotence dans une seule unité de travail : la validation de l'offset suit alors cette validation, et une nouvelle livraison est dédupliquée. - Quand un gestionnaire lève une exception, le bus met en pause la partition de
l'enregistrement pendant
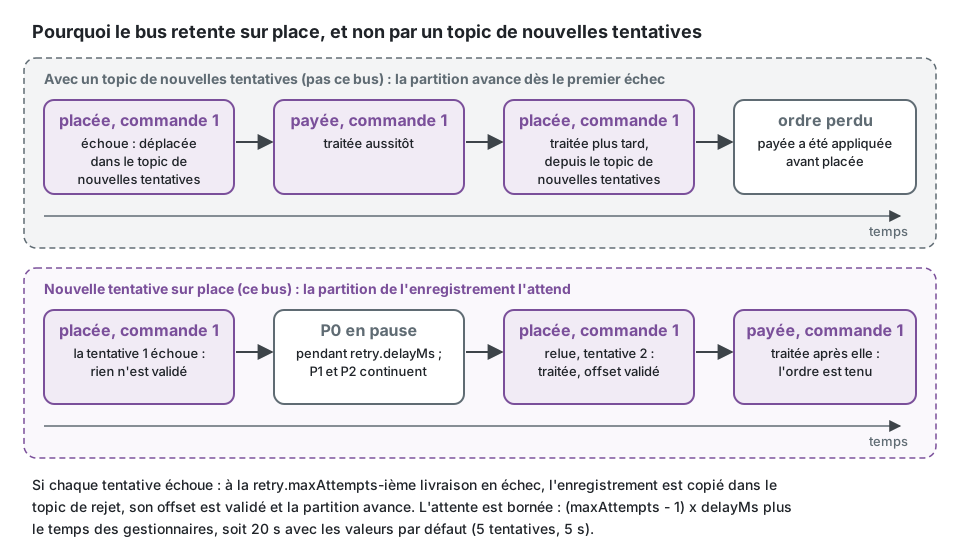
retry.delayMset relit le même enregistrement : pas de boucle active, les autres partitions continuent de s'écouler, et le consommateur continue d'interroger le broker, si bien que l'attente ne retarde pas un rééquilibrage et ne compte pas dansmax.poll.interval.ms. - À la
retry.maxAttempts-ième livraison en échec, l'enregistrement est copié dans le topic de rejet avecx-dead-reason: max-attempts,x-error-code,x-attemptetx-source(<topic>/<partition>/<offset>), son offset est validé et la partition avance. Un enregistrement en échec retient sa partition pendant(maxAttempts - 1) x delayMsplus le temps de ses gestionnaires (20 s avec les valeurs par défaut), jamais pour toujours. - Un enregistrement dont la valeur n'est pas une enveloppe (illisible, ou sans
id,type,version,occurredAt) est empoisonné : il part directement dans le topic de rejet avecx-dead-reason: poisonetx-error-code: POISON_MESSAGE, et aucun gestionnaire ne le voit. - Seuls des codes circulent :
x-error-codeest lecodede l'erreur ou le nom de sa classe. Le message d'une erreur n'est jamais journalisé, signalé ni joint, parce qu'il peut citer des données de la charge utile. Le client journalise les messages et les piles de ce qu'il attrape : le bus coupe son logger.
Pourquoi retenter sur place et non par des topics de nouvelles tentatives. Un topic de nouvelles tentatives laisse la partition avancer dès le premier échec, et c'est justement le problème : l'événement suivant du même agrégat est traité avant celui qui a échoué. Une base de données tombée deux secondes appliquerait « order paid » avant « order placed ». Retenter sur place garde l'ordre d'une clé à travers tout échec qui se résorbe dans le nombre de tentatives ; le coût est que les autres clés de cette partition attendent aussi, pendant un temps borné. L'ordre n'est abandonné qu'à l'étape du rejet : les événements qui suivent un événement rejeté sont traités sans lui, et un rejeu le ramène en retard. Un consommateur qui ne peut pas le tolérer doit s'arrêter lui-même sur le rejet (porter une version dans la charge utile, refuser un trou).
Le bus décide d'après ce que fait le gestionnaire : un gestionnaire qui cache son échec le cache aussi au bus.
import type { KafkaEventBus } from '@ddd-ts-kit/kafka';import type { IntegrationEvent } from '@ddd-ts-kit/kernel';
declare const bus: KafkaEventBus;declare const logger: { warn(message: string, fields: object): void };declare function sendReceipt(event: IntegrationEvent): Promise<void>;
const notifications = bus.forConsumer('notifications');
// Au lieu de : attraper l'erreur. Le gestionnaire se termine, l'offset est validé, et// l'événement est perdu : pas de nouvelle tentative, pas de rejet, rien à rejouer.notifications.subscribe('billing.invoice.issued', async (event) => {  try {    await sendReceipt(event);  } catch {    logger.warn('receipt not sent', { eventId: event.id });  }});
// Écrire : la laisser se propager. Le bus met la partition en pause, relit l'enregistrement// après retry.delayMs, et après retry.maxAttempts le copie dans// notifications.billing.invoice.issued.dead, où replayDead peut le reprendre.notifications.subscribe('billing.invoice.issued', async (event) => {  await sendReceipt(event);});
La livraison se fait au moins une fois. L'ordre copier puis valider fait qu'un crash entre les deux livre l'enregistrement deux fois, jamais zéro fois.
Rééquilibrages. Les offsets sont validés un enregistrement à la fois, pour les seuls enregistrements traités : une partition qui passe à un autre membre reprend donc exactement après le dernier enregistrement traité. Un gestionnaire en cours quand sa partition lui est retirée se termine ; sa validation est alors refusée, et le nouveau propriétaire traite de nouveau l'enregistrement : le registre des événements traités l'absorbe. Le compte des tentatives vit dans la mémoire du membre : un enregistrement en cours de nouvelle tentative quand sa partition change de membre, ou quand le processus redémarre, repart avec un budget neuf.
Connexions perdues. librdkafka se reconnecte de lui-même, producteurs comme consommateurs,
avec son propre délai croissant. Tant que le cluster est absent, publish rejette après
publishTimeoutMs (30 s par défaut) avec PUBLISH_NOT_ACKNOWLEDGED : le relais de l'outbox
garde donc les enregistrements et les retente ; une publication coupée a pu être écrite, et sa
nouvelle tentative est alors un second enregistrement avec le même id d'événement, que les
consommateurs dédupliquent. Un consommateur qui n'a pas pu démarrer, valider ou écrire un rejet
signale kind: 'connection' et réessaie après le délai de reconnect (200 ms, doublé jusqu'à
30 s), sans dépasser l'enregistrement.
Identifiants de connexion. Les propriétés de client (mot de passe SASL, clés TLS) vont à
la bibliothèque cliente quand le bus est construit et ne sont gardées nulle part ailleurs. Un
KafkaEventBus journalisé, étalé ou sérialisé montre KafkaEventBus [clients concealed] et
rien d'autre : ses champs ne sont pas énumérables, et toJSON et util.inspect répondent ce
nom. Les échecs qu'il signale sont des codes. Ce que la bibliothèque cliente montre elle-même
quand on inspecte l'un de ses propres objets n'est pas entre les mains de ce package : ne
journalisez pas ces objets.
Ce qu'on dit à un gestionnaire. À côté de l'événement, chaque gestionnaire reçoit la
livraison (EventDelivery du noyau) : { attempt, maxAttempts, system: 'kafka', destination, consumer },
où destination est le topic. Les gestionnaires de l'application l'ignorent ;
@ddd-ts-kit/tracing la lit pour faire un span CONSUMER par tentative et pour marquer les
nouvelles livraisons et la tentative après laquelle l'événement est enterré. Le bus se nomme
messagingSystem: 'kafka', et traceparent voyage dans l'enveloppe et comme un vrai en-tête,
intact à travers une nouvelle tentative.
Exploitation
Section intitulée « Exploitation »Ce qu'il faut surveiller :
| Signal | Où | Sens |
|---|---|---|
stats() de l'outbox (pending, failed, dead) |
le registre de l'outbox | le côté publication : voir @ddd-ts-kit/events |
retard du groupe <consumer> sur ses topics d'événements |
cluster (kafka-consumer-groups.sh --describe, un exportateur) |
le consommateur est en retard, arrêté, ou retente un enregistrement : un retard qui ne bouge pas est une partition retenue par un enregistrement en échec |
retard du groupe <consumer>.replay sur <consumer>.<topic>.dead, ou l'offset de fin de ce topic avant tout rejeu |
cluster | la profondeur du rejet : doit être 0, alertez sur toute autre valeur |
onDelivery compté par outcome |
ce bus | taux de retried, dead, poison rapporté à acknowledged |
onFailure avec kind: 'connection' |
ce bus | les consommateurs qui n'ont pas pu démarrer, valider ou rejeter, avec le code de librdkafka |
DeadLetterReports du noyau sur onFailure |
l'outil de suivi des erreurs | un rapport par événement abandonné (rejeté ou empoisonné), avec l'erreur qu'a levée son gestionnaire ; une livraison retentée n'est pas signalée |
bus.deliveriesInFlight |
ce bus | les gestionnaires en cours d'exécution ; bloqué au-dessus de 0, c'est un gestionnaire qui ne rend pas la main |
bus.partitionsAssigned |
ce bus | 0 sur une instance abonnée signifie qu'elle ne consomme rien (plus d'instances que de partitions, ou pas encore dans le groupe) |
partitions sous-répliquées, min.insync.replicas |
cluster | sous 2 répliques in-sync, acks=all ne protège rien |
Les signaux du bus, branchés sur un compteur de métriques et un logger, et le rejeu des enregistrements rejetés une fois la cause corrigée :
import { KafkaEventBus } from '@ddd-ts-kit/kafka';import { DeadLetterReports, type ErrorReporter, type EventSubscribers } from '@ddd-ts-kit/kernel';
declare const deliveries: { add(value: number, attributes: Record<string, string>): void };declare const logger: { warn(message: string, fields: object): void };declare const errorReporter: ErrorReporter;
const deadLetters = new DeadLetterReports(errorReporter);
export const bus = new KafkaEventBus({  brokers: ['kafka-1:9092', 'kafka-2:9092', 'kafka-3:9092'],  // Un comptage par enregistrement réglé : acknowledged, retried, dead ou poison.  onDelivery: ({ consumer, topic, outcome }) => deliveries.add(1, { consumer, topic, outcome }),  // Des codes seulement, jamais un message d'erreur : sûr à journaliser tel quel.  onFailure: (failure) => {    logger.warn('event bus failure', failure);    deadLetters.onFailure(failure);  },});
// Lié à EventSubscribers : les rapports des événements enterrés portent alors ce qu'a levé le gestionnaire.export const subscribers: EventSubscribers = { forContext: (name) => deadLetters.observing(bus.forConsumer(name)) };
// Pour une jauge : les gestionnaires en cours, et les partitions que consomme cette instance.export const gauges = () => ({ inFlight: bus.deliveriesInFlight, partitions: bus.partitionsAssigned });
// Une fois la cause corrigée : jusqu'à 100 enregistrements renvoyés vers ordering.order.placed, pour billing seulement.export async function replayBillingDeadLetters(): Promise<number> {  return bus.replayDead({ consumer: 'billing', type: 'ordering.order.placed' }, 100);}
Il recopie jusqu'à ce nombre d'enregistrements du topic de rejet vers le topic d'où ils
viennent, avec l'en-tête x-replay-for: billing, et valide sa progression sur le topic de
rejet sous le groupe billing.replay. Les consommateurs de ce kit autres que billing sautent
un enregistrement marqué pour quelqu'un d'autre ; un consommateur écrit sans ce kit voit
l'événement une seconde fois et doit dédupliquer sur x-event-id. L'enregistrement rejoué va à
la fin du topic, donc après les événements qui l'ont suivi. Regardez d'abord x-dead-reason
et x-error-code : rejouer un enregistrement empoisonné ne fait que le tuer de nouveau. Les
topics de rejet sont des topics ordinaires : donnez-leur une rétention qui laisse le temps
de regarder.
Pour arrêter un consommateur définitivement, supprimez son groupe, son groupe de rejeu et ses topics de rejet. Désabonner un gestionnaire ne déplace pas le groupe : un enregistrement dont le type n'a plus de gestionnaire retient sa partition jusqu'à ce qu'un gestionnaire revienne ou que le bus se ferme.
- Un enregistrement en échec retarde toute sa partition, pendant
(maxAttempts - 1) x delayMsplus le temps de ses gestionnaires. Gardez cette durée bien en dessous de la latence que les autres agrégats peuvent accepter. - Un seul délai. L'attente est la même à chaque tentative, sans délai exponentiel.
- Une validation par enregistrement, synchrone : le débit d'une partition est borné par le gestionnaire plus un aller-retour de validation. C'est le prix de ne jamais valider un enregistrement non traité.
- Un gestionnaire doit terminer en moins de
maxHandlingMs(max.poll.interval.ms, 5 minutes par défaut). Au-delà, le membre est tenu pour mort, ses partitions changent de main, et l'enregistrement est traité deux fois, en parallèle. - Un nouveau groupe commence au plus ancien enregistrement de ses topics
(
startFrom: 'earliest') : un consommateur déployé après les producteurs ne manque rien, et un consommateur ajouté un an plus tard lit un an d'événements retenus. Choisissezlatesten connaissance de cause, en sachant que ce qui est publié entre la création du groupe et sa première affectation est alors sauté. - Une nouvelle tentative exécute de nouveau tous les gestionnaires du type, y compris ceux qui ont réussi, quand plusieurs gestionnaires d'un même consommateur sont abonnés au même type. Chacun doit être idempotent.
- Un lot n'est pas atomique. Quand
publishrejette, certains enregistrements ont pu être écrits. Le relais publie un par un et retente, les consommateurs dédupliquent. Les transactions ne sont pas utilisées. - Le producteur idempotent déduplique les nouvelles tentatives du client, pas celles du relais. Un enregistrement publié de nouveau par le relais est un second enregistrement : le registre des événements traités n'est pas facultatif.
- La durabilité est un réglage du cluster.
acks=allattend les répliques in-sync, quel que soit leur nombre : utilisez un facteur de réplication de 3 avecmin.insync.replicas=2. Les valeurs par défaut d'un broker à un seul nœud acquittent avec une seule copie. publishn'échoue pas vite tant que le cluster est absent : il attendpublishTimeoutMs. Baissez-le pour un relais qui doit s'en apercevoir vite ; c'est aussi la borne d'un acquittement sain mais lent.- Les noms de topics et de groupes sont le type d'événement et le nom du consommateur tels
quels : ils doivent tenir dans les 249 caractères et l'alphabet
[a-zA-Z0-9._-]de Kafka, suffixe de rejet compris. - Les partitions d'un topic existant ne sont pas modifiées par le bus, et ajouter des partitions à la main déplace des clés vers d'autres partitions : l'ordre d'une clé est perdu à travers ce changement.
- Le client natif est chargé dans le processus : un plantage de librdkafka est un plantage du
processus, et
clientlui est passé sans vérification.
Non vérifié par la suite de tests : un cluster de plusieurs brokers (élection d'un leader, un
ensemble de répliques in-sync qui rétrécit, min.insync.replicas), TLS et SASL, l'assignateur
coopératif et le protocole de groupe de nouvelle génération (group.protocol=consumer), un
processus consommateur tué en plein traitement, une erreur fatale du producteur (le bus ouvre
alors un nouveau producteur ; le chemin n'est pas exercé), les brokers antérieurs à 4.3, et
Debezium à la place du relais.
Autres fournisseurs
Section intitulée « Autres fournisseurs »@ddd-ts-kit/rabbitmq et @ddd-ts-kit/nats implémentent les deux mêmes ports et passent la
même suite de contrat. Les trois partagent l'enveloppe, les noms d'en-têtes (traceparent,
x-correlation-id, x-event-version, x-attempt, x-error-code, x-dead-reason), les noms
d'options (consumer, retry, reconnect, onFailure, onDelivery) et les méthodes
(forConsumer, assertTopology, describeTopology, replayDead, close).
RedisStreamsEventBus de @ddd-ts-kit/redis est un quatrième : mêmes ports, même suite de
contrat, mêmes noms d'options et mêmes méthodes, sur un serveur que vous faites peut-être déjà
tourner. Kafka est celui à choisir quand l'ordre des événements d'un agrégat compte.
Les suites demandent un vrai broker et sont sautées sans DDD_TS_KIT_TEST_KAFKA_BROKERS :
docker run -d --rm --name ddd-ts-kit-test-kafka -p 127.0.0.1:9092:9092 -p 127.0.0.1:9094:9094 -e KAFKA_NODE_ID=1 -e KAFKA_PROCESS_ROLES=broker,controller -e KAFKA_LISTENERS=PLAINTEXT://:9092,RELAYED://:9094,CONTROLLER://:9093 -e KAFKA_ADVERTISED_LISTENERS=PLAINTEXT://127.0.0.1:9092,RELAYED://127.0.0.1:9095 -e KAFKA_LISTENER_SECURITY_PROTOCOL_MAP=CONTROLLER:PLAINTEXT,PLAINTEXT:PLAINTEXT,RELAYED:PLAINTEXT -e KAFKA_CONTROLLER_QUORUM_VOTERS=1@localhost:9093 -e KAFKA_CONTROLLER_LISTENER_NAMES=CONTROLLER -e KAFKA_INTER_BROKER_LISTENER_NAME=PLAINTEXT -e KAFKA_OFFSETS_TOPIC_REPLICATION_FACTOR=1 -e KAFKA_TRANSACTION_STATE_LOG_REPLICATION_FACTOR=1 -e KAFKA_TRANSACTION_STATE_LOG_MIN_ISR=1 -e KAFKA_GROUP_INITIAL_REBALANCE_DELAY_MS=0 apache/kafka:4.3.1DDD_TS_KIT_TEST_KAFKA_BROKERS=127.0.0.1:9092 DDD_TS_KIT_TEST_KAFKA_RELAY=127.0.0.1:9095=127.0.0.1:9094 npx vitest run packages/kafkadocker rm -f ddd-ts-kit-test-kafkaUn client Kafka se connecte aux adresses que le broker annonce : on ne peut donc pas provoquer
une panne réseau en pointant le bus vers un relais réseau. Le broker a un second écouteur,
RELAYED, qui annonce 127.0.0.1:9095, où les tests écoutent et relaient vers le port qui se
trouve derrière (9094). DDD_TS_KIT_TEST_KAFKA_RELAY donne les deux adresses ; sans elle, les
trois tests de panne réseau sont sautés et le reste s'exécute.
Ils exécutent la suite de contrat sur des topics d'une et de trois partitions, puis les
comportements de ce fournisseur, une suite par comportement (publishing, consuming,
correlation, retries sur place, dead-letters, partitions pour l'ordre par clé à travers
une nouvelle tentative et l'arrivée d'une seconde instance, topology, connection-loss avec
la publication acquittée coupée en plein vol, closing), et toute la chaîne de l'outbox
jusqu'à un consommateur idempotent. Chaque test travaille sur ses propres topics et groupes,
et les supprime.