
La discipline des commits et des pull requests
Résumé. Un commit porte un cas d'usage ou un concept, avec tout ce qui a été généré à partir de lui ; une pull request porte une idée relisible et reste assez petite pour être lue d'une traite. Ce guide donne l'unité d'un commit, la règle des fichiers générés, le format des messages, des tailles cibles avec les raisons qui les fondent (qualité de la revue, recherche par bissection, possibilité d'annuler), des façons de découper un changement qui a grossi, et la liste exacte de ce que les hooks et le pipeline du kit imposent, et de ce qu'ils laissent aux personnes.
L'unité : un cas d'usage ou un concept
Section intitulée « L'unité : un cas d'usage ou un concept »L'architecture découpe déjà le travail en unités qui font de bons commits :
| Unité | Ce que contient le commit |
|---|---|
| un concept du domaine | un objet-valeur ou une méthode d'agrégat, sa spec, la modification de son builder, le terme du glossaire |
| un cas d'usage | la commande ou la requête, son gestionnaire (handler), le comportement du domaine dont il a besoin, les specs, la route, le document OpenAPI régénéré |
| un contrat | la déclaration d'un événement d'intégration, son publisher, le catalogue et le document AsyncAPI régénérés |
| un consommateur | un gestionnaire d'événement d'intégration, sa spec, les listes régénérées |
| un adaptateur | l'adaptateur, sa spec d'intégration, l'appel de la suite de contrat pour lui et pour le fake |
| une décision | un ADR, et l'entrée de configuration ou la désactivation qu'il justifie |
| un changement de structure | un renommage ou un déplacement, sans aucun changement de comportement |
Deux choses ne partagent jamais un commit : un changement de structure et un changement de comportement. Un renommage qui touche quarante fichiers est trivial à relire seul, et impossible à relire quand un changement de règle se cache dedans.
Chaque commit devrait laisser le projet dans un état où npm run verify passe. C'est ce qui rend
l'historique utilisable par git bisect et permet d'annuler n'importe quel commit isolément.
Les fichiers générés voyagent avec ce qui les a générés
Section intitulée « Les fichiers générés voyagent avec ce qui les a générés »Plusieurs fichiers sont des produits des sources et sont commités : openapi/openapi.yaml,
docs/integration/asyncapi.yaml, docs/integration/event-catalog.md, docs/context-map.md et
les listes générées de chaque CONTEXT.md, le barrel <context>.declarations.ts,
.dependency-cruiser.cjs.
La règle : le fichier régénéré est dans le même commit que le changement qui l'a causé.
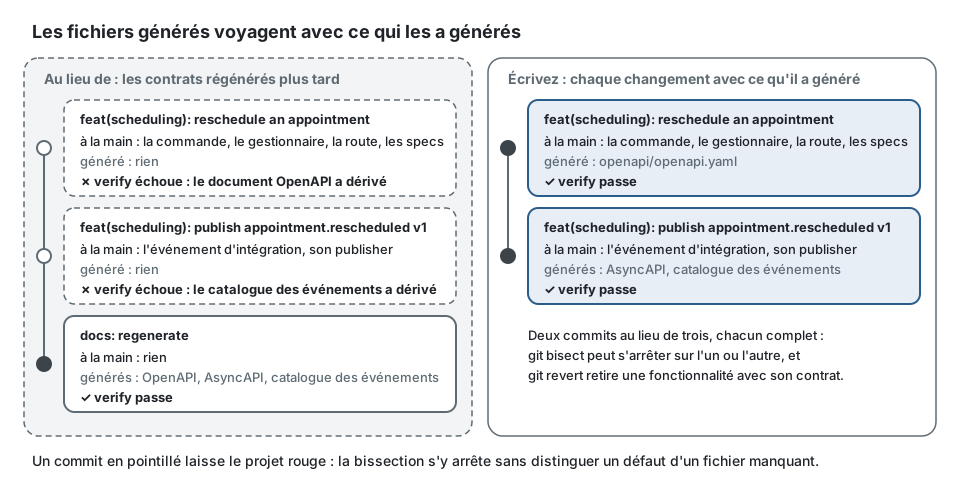
- Une route ajoutée sans son diff OpenAPI échoue à la porte de dérive en CI.
- Un relecteur lit le diff généré comme un résumé : le diff du catalogue dit en dix lignes ce que le changement d'événement signifie pour les consommateurs.
- Un commit « regenerate docs » qui suit trois commits de fonctionnalité rend ces trois commits rouges chacun pris isolément, ce qui casse la bissection.
En revue, les diffs générés se lisent, ils ne se commentent pas ligne par ligne : si le produit
est faux, c'est la source ou le générateur qui est faux. Ils ne sont jamais modifiés à la main, et
le hook du plugin refuse une telle modification pour les trois contrats générés, les barrels
et .dependency-cruiser.cjs.
Les messages : conventional commits
Section intitulée « Les messages : conventional commits »<type>(<scope>): <summary>
<body: why, not what>- type :
feat,fix,refactor,test,docs,chore,perf,build,ci(le jeu conventionnel). - scope : le contexte délimité (bounded context), ou
platform,pipeline,docs. Il dit quel propriétaire relit. - summary : à l'impératif, dans le langage omniprésent (ubiquitous language) :
feat(scheduling): refuse to book a slot that is already taken, pasfeat: add check in handler. - body : la raison, la règle encodée et où, ce qui a été délibérément laissé de côté. Le diff dit déjà ce qui a changé.
- changements cassants : un
!après le scope et un pied de messageBREAKING CHANGE:, pour une route ou un événement dont le contrat casse.
Des exemples, avec les contextes de examples/scheduling :
feat(scheduling): publish scheduling.appointment.cancelled v1
docs(scheduling): add TimeOff to the glossary
refactor(scheduling): extract BookingWindow from Calendar
fix(notification): send one reminder when the event is redelivered
Un message est lu dans git log --oneline un an plus tard, par quelqu'un qui n'a pas le diff en
tête :
# Au lieu defix: stufffeat: add check in handlerwip
# Écrivezfeat(scheduling): refuse to book a slot that is already taken
Two patients confirming the same slot at once both got it. The aggregate nowrefuses the second booking; the unique index on the slot stays as the last lineof defence, not as the rule.
Avec les fusions par squash, le titre de la pull request devient le commit sur la branche par défaut ; le titre suit donc le même format, et le pipeline le vérifie avec la même configuration.
Des tailles cibles, et pourquoi
Section intitulée « Des tailles cibles, et pourquoi »Ce sont des cibles pour se guider. Le kit en mesure une, avec un seuil un peu au-dessus des
cibles : npx ddd-ts-kit check --commit-size compte les fichiers et les lignes sur le point
d'être commités (--staged ne lit que l'index) et les compare à commit dans la configuration,
20 fichiers et 600 lignes modifiées par défaut, fichiers générés non comptés (voir
Configuration). Au-delà des limites, il nomme les tranches à commiter une par
une. Il ne fait que conseiller : il ne sort en 1 qu'avec --strict. Le lefthook.yml généré le
lance au pre-commit sans --strict, et le hook du plugin fait le même rappel dans une
session d'agent, sans bloquer. Sa réponse tient sur une ligne, coupée ici :
$ npx ddd-ts-kit check --commit-size --staged34 changed files and 912 changed lines are staged (advised at most 20 files and 600 lines acommit, generated files not counted): over the limits. Commit each finished slice on its own,with the files its generator wrote: scheduling: reschedule-appointment (12 files),scheduling: cancel-appointment (10 files), scheduling: domain (8 files), scheduling: test (4 files).Une tranche est un cas d'usage d'un contexte (le dossier de sa commande ou de sa requête, sa
route, leurs specs), sinon une couche d'un contexte, sinon platform ou le dossier de premier
niveau du fichier. « Généré » désigne ce qu'une commande réécrit : les fichiers de verrouillage,
les documents OpenAPI et AsyncAPI, le catalogue d'événements, docs/context-map.md,
.dependency-cruiser.cjs, et les fichiers barrel et de dépendances de chaque contexte. Les
limites sont une clé de ddd-ts-kit.config.json :
{ "commit": { "maxFiles": 15, "maxLines": 400 }}et une équipe qui veut que la limite bloque ajoute --strict au job de son lefthook.yml :
- name: commit size run: npx --no -- ddd-ts-kit check --commit-size --staged --strict| Mesure | Cible | Au-delà, attendez-vous à |
|---|---|---|
| lignes modifiées à la main dans une pull request | jusqu'à environ 400 | des relecteurs qui survolent au lieu de lire |
| fichiers modifiés à la main | jusqu'à environ 15 | un changement qui porte plus d'une idée |
| cas d'usage par pull request | 1 | un échec de l'un qui bloque la fusion de l'autre |
| contextes touchés à la main | 1 | deux propriétaires, deux revues, un déploiement couplé |
| âge d'une branche | 1 à 2 jours | des conflits dans l'agrégat et dans chaque fichier généré |
Les fichiers générés sont exclus des comptes : un diff OpenAPI de 600 lignes causé par une route de 40 lignes est un changement de 40 lignes.
Qualité de la revue. Les mesures les plus connues viennent d'une étude de la revue de code chez Cisco publiée par SmartBear : la détection des défauts chutait nettement dès qu'une revue dépassait quelques centaines de lignes, et les relecteurs étaient les plus efficaces en dessous d'environ 200 à 400 lignes et en une heure environ. Les pratiques d'ingénierie de Google ne donnent pas de chiffre mais la même direction : un changement devrait être une seule chose autonome, et environ 100 lignes y sont qualifiées de taille généralement raisonnable, alors que 1000 est généralement trop. Prenez ces chiffres comme des ordres de grandeur ; le mécanisme, lui, ne fait pas de doute : l'attention est limitée, et un relecteur qui ne peut pas garder le changement en tête l'approuve.
Recherche par bissection. git bisect trouve le commit qui a introduit une faute en un
nombre d'étapes logarithmique dans la taille de l'historique. Sa réponse n'est utile que si ce
commit est petit et compile. Trouver « la faute est quelque part dans ce commit de 3000
lignes » n'est pas une réponse.
Possibilité d'annuler. Un petit commit à un seul objet peut être annulé en production sans emporter du travail sans rapport. Un cas d'usage et son contrat régénéré s'annulent ensemble précisément parce qu'ils ont été commités ensemble.
Conflits de fusion. Ils grandissent avec la durée de vie et l'étendue d'une branche, et les fichiers partagés de cette architecture (voir Travail en parallèle) rendent les branches longues particulièrement coûteuses.
Sessions d'agent. Une tâche petite et délimitée borne aussi ce qu'un agent de code doit lire et ce qu'il peut casser ; voir Économie de tokens.
Découper un changement qui a grossi
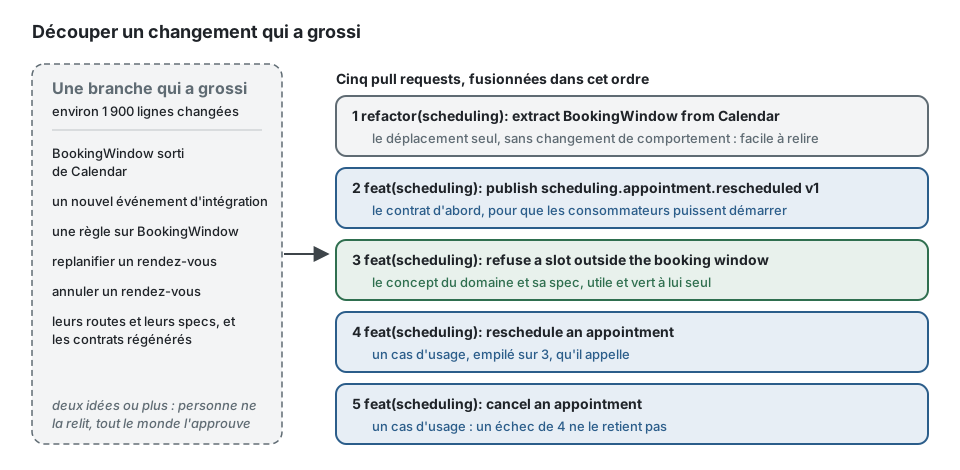
Section intitulée « Découper un changement qui a grossi »Cela arrive : un cas d'usage s'est révélé avoir besoin d'un nouvel objet-valeur, d'un port, d'un changement de contrat. Découpez avant la revue, pas après.
- Extraire la refonte. Si la fonctionnalité demandait d'abord un renommage ou un déplacement, celui-ci va dans son propre commit, avant la fonctionnalité : « rendre le changement facile, puis faire le changement facile » (Kent Beck).
- Extraire le contrat. Un événement d'intégration ou une définition de route, nouveau ou modifié, forme sa propre pull request, fusionnée en premier ; voir « Les contrats d'abord » dans Organisation du travail en équipe.
- Ne découper selon les couches que de l'intérieur vers l'extérieur. Le concept du domaine avec sa spec d'abord (utile et vert à lui seul), puis le cas d'usage qui l'utilise. Jamais le gestionnaire avant le comportement du domaine qu'il appelle.
- Découper selon les cas d'usage.
RescheduleAppointmentetCancelAppointmentécrits ensemble font deux pull requests. - Les empiler. Quand la seconde dépend de la première, ouvrez-la par-dessus la première et dites-le ; fusionnez dans l'ordre.
La mécanique avec git : git add -p pour indexer une partie d'un fichier, git reset jusqu'à la
base (les changements restent dans l'arbre de travail) puis recommiter en morceaux pour une
branche que personne d'autre n'utilise, ou git rebase -i en local. Ne réécrivez jamais une
branche que quelqu'un d'autre a récupérée ; ajoutez plutôt des commits.
# une branche que personne d'autre n'a récupérée : défaire ses commits, garder les changements, recommiter en morceauxgit reset "$(git merge-base HEAD origin/main)"
# la refonte d'abord, morceau par morceaugit add -p src/contexts/scheduling/domain/aggregates/calendar.aggregate.tsgit add src/contexts/scheduling/domain/value-objects/booking-window.vo.tsgit commit -m "refactor(scheduling): extract BookingWindow from Calendar"
# puis un cas d'usage avec tout ce que son générateur et docs:generate ont écrit :# commande et gestionnaire, route, leurs specs, le barrel régénéré et le contratgit add src/contexts/scheduling/application/commands/reschedule-appointment/ \        src/contexts/scheduling/presentation/http/appointments/reschedule-appointment/ \        src/contexts/scheduling/test/unit/reschedule-appointment.*.spec.ts \        src/contexts/scheduling/scheduling.declarations.ts \        openapi/openapi.yamlnpx ddd-ts-kit check --commit-size --stagedgit commit -m "feat(scheduling): reschedule an appointment"
Après tout découpage, passez la porte sur chaque morceau : un commit qui ne compile qu'avec le suivant n'est pas découpé, seulement coupé. Pour tester exactement ce qui est indexé, mettez d'abord le reste de côté :
git stash push --keep-index --include-untracked # l'arbre de travail est maintenant l'indexnpm run verifygit stash popCe que les hooks et le pipeline imposent
Section intitulée « Ce que les hooks et le pipeline imposent »Énoncé exactement, d'après pipeline/lefthook.yml, pipeline/README.md et le plugin :
| Moment | Ce qui tourne | Impose |
|---|---|---|
| chaque écriture de fichier dans une session d'agent | le hook du plugin | refuse un fichier écrit à la main là où un générateur existe, une modification d'un fichier généré (contrats, barrels, .dependency-cruiser.cjs) et, pour un worker d'un seul contexte, une écriture hors de ce contexte ; demande au propriétaire avant une désactivation, un test sauté ou un changement des fichiers gouvernés ; renvoie les violations du fichier écrit ; refuse de terminer tant que des erreurs d'architecture restent, puis rappelle la taille du commit sans bloquer |
pre-commit (lefthook) |
ESLint et le formateur (biome format) sur les fichiers indexés ; ddd-ts-kit check sur les sources indexées sous src/ ; ddd-ts-kit check --commit-size --staged |
les règles de code, le format et la structure de ce qui est commité ; la taille du commit, à titre de conseil |
commit-msg (lefthook) |
commitlint | le format conventional commits |
pre-push (lefthook) |
la vérification des types et les tests unitaires | le projet compile et ses tests rapides passent |
| pull request | la vérification du titre | le titre est un conventional commit |
| CI | vérification des types, lint, architecture, code mort, tests, dérive de la documentation et des contrats, sécurité, build, image, puis le job unique gate |
tout, y compris les fichiers générés périmés |
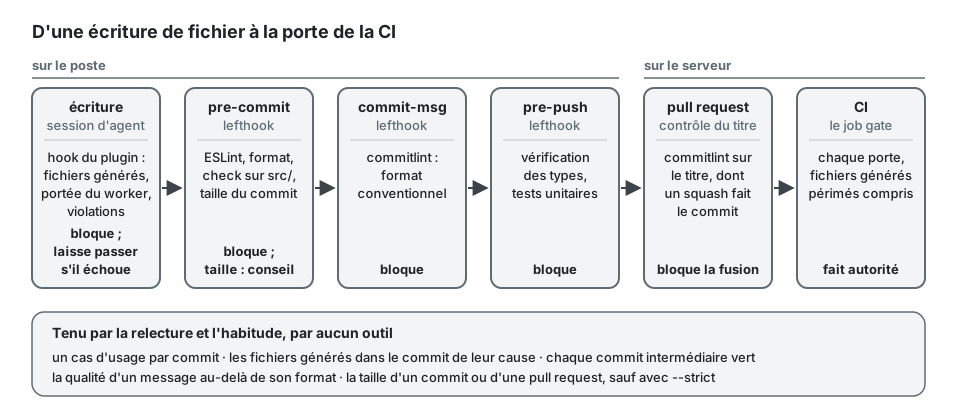
Les hooks s'installent une fois par clone (npm run hooks:install). Le hook du plugin
laisse passer en cas d'échec, par conception : une garde cassée ne bloque jamais le travail ; il
est donc une commodité, et la CI fait autorité.
Imposé par aucun outil : la taille d'un commit ou d'une pull request (check --commit-size et le hook du plugin ne font que conseiller, sauf si vous ajoutez --strict au
job pre-commit), un cas d'usage par commit, la présence des fichiers générés dans le même
commit que leur cause (la porte vérifie l'état final de la branche, pas chaque commit), la
qualité d'un message au-delà de son format, et le fait que chaque commit intermédiaire compile.
Ce sont la revue et l'habitude qui les tiennent. Si le vert à chaque commit compte pour vous,
fusionnez par squash : le seul commit qui atteint alors la branche par défaut est celui que la
porte a vérifié.
Limites et quand ne pas l'utiliser
Section intitulée « Limites et quand ne pas l'utiliser »- Les petites pull requests demandent une revue rapide. Si une revue prend deux jours, dix petites pull requests prennent plus de temps qu'une grande, et les gens réagissent en les regroupant. Corrigez d'abord le délai de revue.
- Les pull requests empilées sont malcommodes sur les plateformes qui ne les prennent pas en charge nativement : un changement demandé dans la première se répercute sur les autres.
- Certains changements sont atomiques et gros : une montée de version majeure d'une dépendance, un renommage mécanique, une migration de chaque adaptateur de repository. Gardez-les purs (rien d'autre dans le commit) plutôt que petits.
- La fusion par squash échange l'historique contre la propreté. Elle garantit un commit vert et titré par pull request et perd les étapes intermédiaires ; une équipe qui fait des bissections à l'intérieur des pull requests devrait fusionner sans squash et garder elle-même chaque commit vert.
- Les tailles cibles sont des heuristiques. L'étude citée repose sur les données d'une seule entreprise dans les années 2000 ; la direction est bien étayée, les seuils exacts ne sont pas des lois.
- Conventional Commits 1.0.0, https://www.conventionalcommits.org/en/v1.0.0/
- SmartBear, « Best Practices for Peer Code Review » (qui rapporte l'étude de Cisco, Jason Cohen, 2006), https://smartbear.com/learn/code-review/best-practices-for-peer-code-review/
- Google Engineering Practices, « Small CLs », https://google.github.io/eng-practices/review/developer/small-cls.html
- Documentation de Git,
git-bisect, https://git-scm.com/docs/git-bisect - Kent Beck, sur le fait de rendre le changement facile avant de faire le changement facile (2012).
- Ce dépôt : pipeline/README.md, la section du README racine sur le hook.