
Quand extraire un microservice, et quand ne pas le faire
Résumé. Commencez par un monolithe modulaire : une seule unité déployable dont les contextes délimités (bounded contexts) sont tenus isolés par des règles. N'extrayez un contexte dans son propre service que lorsqu'un signal mesurable dit que le déploiement unique est désormais le problème : un besoin de mise à l'échelle indépendante, un conflit de rythme de livraison, la propriété d'équipe et la charge cognitive, le besoin d'isoler une panne ou un périmètre de conformité, ou une contrainte technologique différente. La taille du code, la mode et « on pourrait en avoir besoin » ne sont pas des signaux. L'extraction apporte des coûts dès son premier jour (panne distribuée, exploitation, cohérence des données, tests, latence, observabilité) ; ce guide donne donc les signaux avec la façon de les mesurer, une liste de préparation liée aux règles du kit, les étapes de l'extraction et les conditions dans lesquelles deux services doivent être fusionnés de nouveau.
Commencer par un monolithe modulaire
Section intitulée « Commencer par un monolithe modulaire »Un monolithe modulaire est un seul processus et un seul déploiement, dans lequel chaque contexte délimité possède son modèle et ses données et ne parle aux autres qu'à travers des contrats publiés. La page de concept l'explique ; l'argument pour commencer par là est court :
- Au départ, les frontières sont des hypothèses. Déplacer une frontière à l'intérieur d'un dépôt est une refonte. La déplacer entre deux services est une migration, avec des données, des contrats et des déploiements. L'observation de Fowler (« MonolithFirst ») est que les systèmes de microservices réussis sont pour la plupart issus d'un monolithe, et que les systèmes conçus en microservices dès le départ ont souvent rencontré des difficultés, parce que les frontières avaient été tracées avant que le domaine soit compris.
- Les microservices se paient d'une prime. Le « MicroservicePremium » de Fowler : la charge opérationnelle et cognitive se paie dès le premier service, et ne rapporte qu'au-delà d'une certaine complexité du système. En dessous, un monolithe est plus productif.
- Les bénéfices qui comptent au début n'ont pas besoin d'un réseau. Une propriété claire, un modèle par contexte, un raisonnement indépendant : tout cela vient de la frontière, pas du déploiement. Newman recommande le monolithe modulaire comme première étape pour la même raison, et prévient que le résultat à éviter est le monolithe distribué, qui a les coûts des deux et les bénéfices d'aucun.
Ce kit rend ce choix par défaut explicite : un contexte délimité est une unité déployable en attente, et l'extraction doit être un changement de racine de composition et d'adaptateurs, jamais de code du domaine ou de l'application (référence d'architecture, « Contextes extractibles »).
Les signaux qui justifient d'extraire un contexte
Section intitulée « Les signaux qui justifient d'extraire un contexte »Chaque signal est une chose que vous pouvez mesurer ou montrer du doigt. Un seul signal fort suffit ; aucun signal veut dire rester.
| Signal | Ce que vous observez | Comment le mesurer | Réponse moins chère à essayer d'abord |
|---|---|---|---|
| Besoin de mise à l'échelle indépendante | la charge d'un contexte diffère d'un ordre de grandeur de celle du reste, ou a une autre forme (par rafales, limitée par le processeur, connexions de longue durée) | des métriques par contexte : débit de requêtes HTTP, processeur, mémoire, profondeur de file d'attente ; le coût de la mise à l'échelle de toute l'unité déployable pour servir un seul contexte | mettre le monolithe à l'échelle horizontalement ; déplacer le travail dans une file d'attente ; exécuter les consommateurs ou les jobs du contexte dans un worker dédié de la même base de code |
| Conflit de rythme de livraison | un contexte doit livrer plusieurs fois par jour alors qu'un autre demande une livraison lente et auditée ; ou le déploiement raté d'un contexte fait sans cesse revenir en arrière les autres | fréquence de déploiement et taux d'échec des changements par contexte ; heures perdues à cause d'un train de livraison partagé | des feature flags ; un meilleur pipeline ; le développement sur le tronc (trunk-based development) |
| Propriété d'équipe et charge cognitive | plusieurs équipes font des commits dans une même unité déployable et attendent les unes derrière les autres ; aucune équipe ne peut tout garder en tête | l'attente dans la file de fusion, le délai de revue entre équipes, le temps qu'il faut à un nouveau venu pour faire son premier changement | la propriété du code par contexte, que la carte des contextes porte déjà ; découper le périmètre de l'équipe, pas l'exécution |
| Isolation des pannes | une faute dans un contexte non critique (une fuite mémoire dans le reporting, un job qui s'emballe) fait tomber la prise de rendez-vous | les incidents dont le rayon d'impact a dépassé le contexte fautif | des cloisons (bulkheads) et des délais d'expiration (timeouts) sur les appels ; un processus worker séparé pour les jobs et les consommateurs |
| Isolation d'un périmètre de conformité | un contexte traite des données soumises à un régime (données de carte de paiement, dossiers de santé) dont le périmètre d'audit couvrirait sinon tout le système | le périmètre d'audit et son coût ; qui a besoin d'un accès de production à quoi | une base de données et des identifiants séparés pour ce contexte à l'intérieur du monolithe (souvent insuffisant pour les auditeurs) |
| Contrainte technologique différente | un contexte a besoin d'un autre environnement d'exécution, d'une bibliothèque qui entre en conflit, d'un GPU, d'une région, ou d'un stockage de données au profil d'exploitation différent | une exigence concrète que l'environnement d'exécution actuel ne peut pas satisfaire | un adaptateur derrière un port, qui appelle un composant externe |
Dans l'application de prise de rendez-vous (examples/scheduling, quatre contextes : identity,
scheduling, notification, analytics) : notification peut envoyer par rafales chaque matin
et dépend de fournisseurs externes lents, un candidat à l'isolation des pannes, d'abord comme
processus worker, ensuite seulement comme service. analytics peut vouloir un autre stockage
et tolérer des heures de retard, un candidat pour des raisons technologiques. Les rendez-vous et
les agendas changent ensemble et appartiennent à une seule équipe, c'est pourquoi ils forment un
seul contexte, scheduling : les séparer n'apporterait rien. Aujourd'hui aucun des signaux n'y
tient : chaque contexte indique Deployable alone: no dans la
carte des contextes de l'exemple, et seuls les
jobs planifiés tournent dans un processus à part.
Regardez la troisième colonne : plusieurs signaux ont une réponse moins chère, qui garde une seule
unité déployable. Un processus worker dédié est la plus utile d'entre elles, et le kit la prend
en charge pour les jobs planifiés sans quitter la base de code : npx ddd-ts-kit generate worker écrit src/apps/worker/main.ts, les mêmes modules que main.ts sans serveur HTTP, et
démarre l'API avec ses jobs désactivés (voir Jobs planifiés).
L'exemple exécute ses jobs de cette façon.
Les signaux qui ne le justifient pas
Section intitulée « Les signaux qui ne le justifient pas »| Pas une raison | Pourquoi |
|---|---|
| La taille du code | une grande base de code aux frontières claires se parcourt bien ; une petite découpée en dix services, non. La taille est une raison de vérifier les frontières, pas de les déployer séparément |
| La mode, ou ce que font d'autres entreprises | leur contrainte, c'étaient des centaines d'ingénieurs ; le patron répond à un problème d'organisation que vous n'avez peut-être pas |
| « On pourrait en avoir besoin plus tard » | les règles d'isolation gardent l'option bon marché. Payer le coût maintenant pour un besoin qui ne viendra peut-être pas relève de la spéculation |
| « Une séparation propre » | la séparation est imposée par le checker et le graphe des imports. Un réseau n'impose aucune conception ; il ne fait que ralentir les violations |
| Des builds ou des tests lents | se corrigent avec des niveaux de test, du cache et des exécutions limitées à ce qui est touché. Les portes rapides du pipeline tournent en quelques secondes |
| L'envie de réécrire dans un autre langage | une contrainte technologique est une exigence, pas une préférence |
| Un contexte est « en désordre » | extraire un désordre produit un désordre distribué. Corrigez d'abord le modèle |
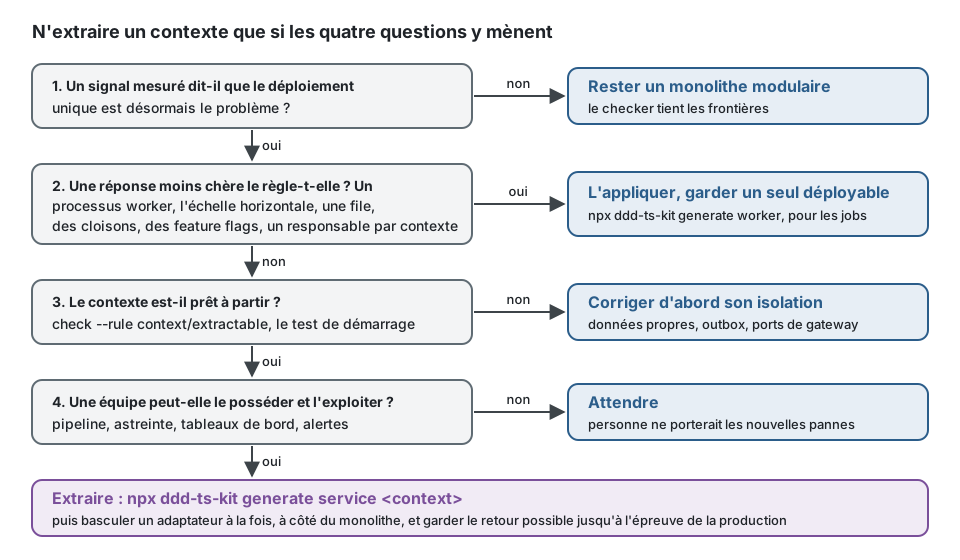
Mise bout à bout avec la liste de préparation et les questions d'exploitation plus bas, la décision se lit comme quatre questions dans l'ordre :
Les coûts qui arrivent dès le premier jour
Section intitulée « Les coûts qui arrivent dès le premier jour »Aucun n'est différé ; chacun commence avec le premier service extrait.
- Panne distribuée. Un appel qui ne pouvait pas échouer peut désormais expirer, échouer à mi-chemin, ou réussir sans que l'appelant le sache. Chaque appel synchrone a besoin d'un délai d'expiration, d'une politique de nouvelle tentative sûre pour l'opération, et d'un comportement défini quand l'autre côté est indisponible (Résilience). Les disponibilités se multiplient : deux services à 99,9 % en chaîne donnent moins que chacun des deux.
- Exploitation. Un second pipeline, une seconde image, un second déploiement, un second jeu de secrets, un second tableau de bord, une seconde procédure d'astreinte ; un broker à faire tourner là où le bus en mémoire suffisait ; des versions des deux services qui doivent rester compatibles pendant chaque déploiement progressif.
- Cohérence des données. Aucune transaction ne couvre les deux. Ce qui était atomique devient un processus avec compensation (Sagas et gestionnaires de processus), et ce qui était une lecture devient une projection qui est en retard (Cohérence à terme).
- Tests. Un test de bout en bout demande désormais les deux services, un broker et leurs bases de données. Les tests de contrat entre les deux deviennent obligatoires là où un compilateur vérifiait l'appel.
- Latence. Un appel dans le processus, mesuré en microsecondes, devient un aller-retour réseau mesuré en millisecondes, avec une sérialisation aux deux bouts, et une traîne qui grandit à chaque saut.
- Observabilité. Une pile d'appels ne traverse plus la frontière. Sans traçage distribué et sans identifiant de corrélation porté par chaque appel et chaque événement, un incident ne peut pas être suivi (Observabilité).
- Évolution des contrats. Le langage publié est désormais déployé à deux endroits, à deux moments ; chaque changement doit rester rétrocompatible pendant un déploiement progressif (Versionnement des événements).
Liste de préparation
Section intitulée « Liste de préparation »Un contexte est prêt à partir quand l'extraction ne change que la composition et les adaptateurs. Les règles du kit sont la liste de préparation ; les identifiants de règle renvoient à leur énoncé dans la référence d'architecture.
| Exigence | Tenue par |
|---|---|
| Le contexte possède ses données : son propre schéma, aucune clé étrangère, jointure ou requête sur les tables d'un autre contexte | context/extractable, context/published-language-only ; une revue pour le SQL brut, que le checker ne voit pas |
| Aucune transaction ne couvre deux contextes | context/extractable ; une revue (une transaction entre contextes fait partie des angles morts déclarés du checker) |
| Les autres contextes ne sont atteints qu'à travers leur langage publié, avec une relation déclarée et sans cycle | context/published-language-only, context/declared-relationship, context/no-cycle |
| Les événements d'intégration sortent par l'outbox transactionnelle | events/outbox-required |
| Chaque consommateur a un nom stable et unique, et déduplique | events/consumer-idempotent |
| Un besoin synchrone passe par un port de l'appelant dont l'adaptateur pourrait être distant, avec un délai d'expiration et un comportement en cas de panne déjà décidés | layer/application-inward ; le genre gateway ; une revue |
| Le contexte démarre seul avec le noyau et la plateforme | le test/architecture/extractable.spec.ts généré |
| Les adaptateurs ne sont créés que dans la racine de composition ; aucun état mutable partagé | composition/only-in-module, context/extractable |
| L'acteur voyage dans le message, jamais comme une session ambiante | authz/actor-explicit |
| La configuration est lue à travers la plateforme, avec un espace de noms par contexte | une revue |
| Le langage publié est versionné et ses consommateurs connus | le catalogue d'événements généré |
| Le traçage et l'identifiant de corrélation traversent les événements d'intégration | le publisher et l'abonné tracés du package de traçage |
Lancez npx ddd-ts-kit check --rule context/extractable et le test d'architecture. Ajoutez
ensuite les vérifications qu'aucun outil ne fait : y a-t-il une équipe pour posséder et exploiter
le service, une cible de déploiement, une astreinte, des tableaux de bord et des alertes pour les
nouveaux modes de panne ?
L'exigence qui échoue le plus souvent est le besoin synchrone. Un contexte qui lit directement les données d'un autre contexte ne pourra jamais partir :
// Au lieu de : scheduling importe un repository de identity et lit ses tables.// context/published-language-only refuse l'import, et les deux ne pourraient jamais être déployés séparément.import { PersonRepository } from '@/contexts/identity/domain/repositories/person.repository';L'appelant déclare ce dont il a besoin, dans ses propres mots, comme un port de sa couche
application ; l'amont offre un contrat dans son langage publié ; un adaptateur gateway relie les
deux. C'est la forme de l'exemple, où scheduling affiche les noms des patients que identity
connaît :
import { Gateway } from '@ddd-ts-kit/kernel/declarations';
// identity/published-language/person-directory.contract.ts : ce que identity offre aux autres contextesexport interface PersonCard {  readonly personId: string;  readonly displayName: string;}
export abstract class PersonDirectoryContract {  abstract byIds(personIds: readonly string[]): Promise<readonly PersonCard[]>;}
// scheduling/application/ports/person-directory-gateway.port.ts : ce dont scheduling a besoin, dans ses motsexport abstract class PersonDirectoryGateway {  abstract namesOf(personIds: readonly string[]): Promise<ReadonlyMap<string, { readonly displayName: string }>>;}
// scheduling/infrastructure/external/in-process-person-directory.gateway.ts : identity dans le même processus@Gateway(PersonDirectoryGateway)export class InProcessPersonDirectoryGateway implements PersonDirectoryGateway {  constructor(readonly upstream: PersonDirectoryContract) {}
  async namesOf(personIds: readonly string[]): Promise<ReadonlyMap<string, { readonly displayName: string }>> {    const cards = await this.upstream.byIds(personIds);
    return new Map(cards.map((card) => [card.personId, { displayName: card.displayName }]));  }}
Les gestionnaires de scheduling dépendent de PersonDirectoryGateway et de rien d'autre ; que
identity réponde dans le même processus ou à travers le réseau est l'affaire de l'adaptateur.
Dans un projet généré par la CLI, la plateforme enveloppe chaque adaptateur de genre gateway ou
external qui ne déclare pas sa propre politique dans sa politique de résilience (les réglages
resilience de sa configuration : nouvelle tentative, délai d'expiration) ; l'appel est donc déjà
traité comme un appel qui peut échouer.
Les étapes de l'extraction
Section intitulée « Les étapes de l'extraction »Telles que la skill extract-service les conduit :
- Générer le point d'entrée.
npx ddd-ts-kit generate service <context>écritsrc/apps/<context>/main.ts(ce contexte, le noyau et la plateforme), un script de démarrage (npm run start:<context>), un service compose dans le profilservices, et passedeployable: truepour le contexte dans la configuration, ce que la carte des contextes montre dans sa colonne « Deployable alone » une foisnpx ddd-ts-kit docslancé. Le service emporte avec lui les jobs planifiés de son contexte (sauf avecRUN_JOBS=false), et aucun job d'un autre. - Remplacer les gateways dans le processus par des adaptateurs distants. Dans les contextes
qui restent, chaque adaptateur
gatewayqui visait le contexte extrait devient un adaptateur distant du même port, tenu à la même suite de contrat. - Faire passer le fournisseur d'événements à un broker, des deux côtés. Le relais de l'outbox chez le producteur, un abonnement durable chez le consommateur. Les gestionnaires ne changent pas. Choisir le broker : Brokers de messages.
- Déplacer le schéma et ses migrations. Les autres ne le lisent jamais, donc rien d'autre ne bouge.
- Décider comment le langage publié est partagé. Un package versionné ou un dossier source partagé : un contrat dans les deux cas.
- L'enregistrer.
docs/context-map.mdet un ADR : ce qui est déployé où, et les nouveaux modes de panne.
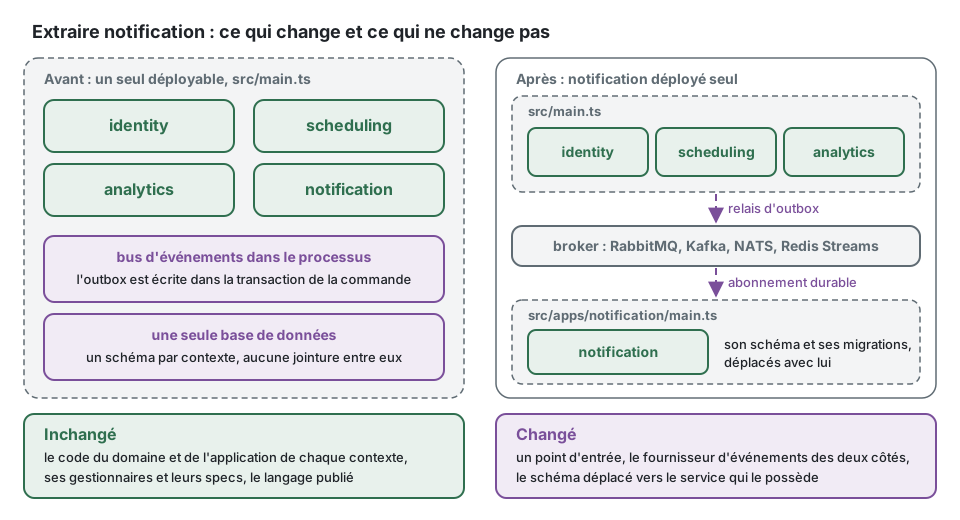
Aucune gateway ne vise notification : l'étape 2 n'a donc rien à changer dans la figure
ci-dessus.
L'étape 2 en code. Quand identity part, la gateway dans le processus de scheduling devient
une gateway distante : le même port, la même déclaration, un client HTTP derrière. Les
gestionnaires, leurs specs et la suite de contrat du port ne changent pas.
import { Gateway } from '@ddd-ts-kit/kernel/declarations';
declare abstract class PersonDirectoryGateway {  abstract namesOf(personIds: readonly string[]): Promise<ReadonlyMap<string, { readonly displayName: string }>>;}
interface PersonCard {  readonly personId: string;  readonly displayName: string;}
/** Le client HTTP du service identity, lié par la plateforme avec son URL de base et ses identifiants. */export abstract class IdentityApi {  abstract getJson<T>(path: string): Promise<T>;}
// scheduling/infrastructure/external/remote-person-directory.gateway.ts : identity derrière le réseau@Gateway(PersonDirectoryGateway)export class RemotePersonDirectoryGateway implements PersonDirectoryGateway {  constructor(private readonly identity: IdentityApi) {}
  async namesOf(personIds: readonly string[]): Promise<ReadonlyMap<string, { readonly displayName: string }>> {    const ids = personIds.map((id) => encodeURIComponent(id)).join(',');    const cards = await this.identity.getJson<readonly PersonCard[]>(`/people?ids=${ids}`);
    return new Map(cards.map((card) => [card.personId, { displayName: card.displayName }]));  }}
Déployez derrière les interfaces existantes : faites tourner le service extrait à côté du monolithe, basculez un adaptateur à la fois, gardez la possibilité de revenir en arrière jusqu'à ce que le nouveau chemin ait porté la charge de production. Monolith to Microservices de Newman recense les patrons pour cela (strangler fig, branch by abstraction, parallel run) ; le port de la gateway est l'abstraction sur laquelle la branche est faite.
Le dépôt ne commence pas en morceaux : la première extraction garde en général un seul dépôt avec
deux points d'entrée, ce qu'est exactement src/apps/<context>/main.ts. Un dépôt séparé est une
décision ultérieure, et distincte.
Quand fusionner deux services de nouveau
Section intitulée « Quand fusionner deux services de nouveau »L'extraction est réversible, et revenir en arrière est parfois la bonne décision. Fusionnez quand :
- ils changent et se déploient toujours ensemble : l'indépendance de livraison qui justifiait la séparation ne s'est jamais concrétisée ;
- la plupart des requêtes HTTP ont besoin d'un appel synchrone entre eux : la latence et le couplage des pannes se paient à chaque requête HTTP, ce qui dit que la frontière de cohérence passe par le milieu ;
- un processus qui traverse les deux a sans cesse besoin de compensation pour ce qui serait une seule transaction : les deux forment un seul contexte (le test de cohérence de Contexte délimité) ;
- l'équipe qui possédait l'un d'eux n'existe plus, et une seule équipe exploite maintenant les deux ;
- le signal a disparu : la charge s'est équilibrée, le périmètre de conformité a changé, la contrainte technologique a été levée.
Fusionner de nouveau, c'est l'extraction à l'envers : les adaptateurs distants redeviennent des adaptateurs dans le processus, le broker peut redevenir le bus en mémoire, le point d'entrée disparaît. C'est bon marché pour la même raison que l'extraction l'était : le code du domaine et de l'application n'en a jamais rien su.
Limites et quand ne pas l'utiliser
Section intitulée « Limites et quand ne pas l'utiliser »- Les vérifications voient des formes, pas des comportements. Le README de la CLI liste ce
que
context/extractablemanque : un nom de schéma dans du SQL brut, une transaction entre contextes, un tableau ou un objet exporté mutable. Une vérification verte est nécessaire, pas suffisante ; le test de démarrage par contexte et une revue couvrent une partie de l'écart. - Le test de démarrage prouve le câblage, pas la tenue en charge. Il montre qu'un contexte démarre seul, pas comment il se comporte quand son amont est lent.
- L'extractibilité a aussi un prix à l'intérieur du monolithe : aucune jointure entre contextes, des projections au lieu de requêtes, des événements au lieu d'appels. Pour un petit système avec une seule équipe, qui ne sera jamais découpé, c'est une charge en trop ; délimitez moins de contextes plutôt que de lutter contre la règle.
- Le kit ne fournit ni maillage de services (service mesh), ni passerelle d'API, ni découverte
de services, ni générateur d'adaptateurs distants pour un protocole donné.
generate adapterécrit un squelette d'adaptateur distant pour un port, avec sa politique de résilience ; le client HTTP ou RPC à l'intérieur est à vous. - Les seuils relèvent du jugement. « Un ordre de grandeur » et « plusieurs équipes » sont des points de départ ; mesurez votre propre système.
- Martin Fowler, « MonolithFirst » (2015) et « MicroservicePremium » (2015), martinfowler.com.
- Sam Newman, Building Microservices, 2e édition, O'Reilly, 2021, chapitres 1 à 3 ; Monolith to Microservices, O'Reilly, 2019 (quand ne pas le faire, patrons de migration).
- Chris Richardson, Microservices Patterns, Manning, 2018, chapitres 1 à 4 (décomposition, sagas) ; microservices.io, « Database per service ».
- Matthew Skelton et Manuel Pais, Team Topologies, IT Revolution, 2019 (la charge cognitive comme critère de frontière).
- Vlad Khononov, Learning Domain-Driven Design, O'Reilly, 2021, chapitre 14 (microservices et contextes délimités).
- Nicole Forsgren, Jez Humble et Gene Kim, Accelerate, IT Revolution, 2018 (fréquence de déploiement et taux d'échec des changements comme mesures).
- Ce dépôt : la skill
extract-service, le README de la CLI.