
Méthodologie : d'une expression des besoins au code qui tourne
Résumé. Ce guide parcourt, étape par étape, le chemin que conduit le plugin : découvrir le domaine par écrit, trouver et classer les contextes délimités (bounded contexts), écrire les glossaires, dessiner la carte des contextes, choisir la stack selon des critères, amorcer le projet, planifier des tranches verticales, les construire (en parallèle quand il y a plusieurs workers), vérifier et documenter. Chaque étape nomme son entrée, le fichier qu'elle laisse dans le dépôt, l'outil qui le produit et la question qui vous dit que l'étape est finie. Les décisions stratégiques appartiennent aux personnes ; les outils les rendent explicites et les gardent vraies.
Le chemin en un coup d'œil
Section intitulée « Le chemin en un coup d'œil »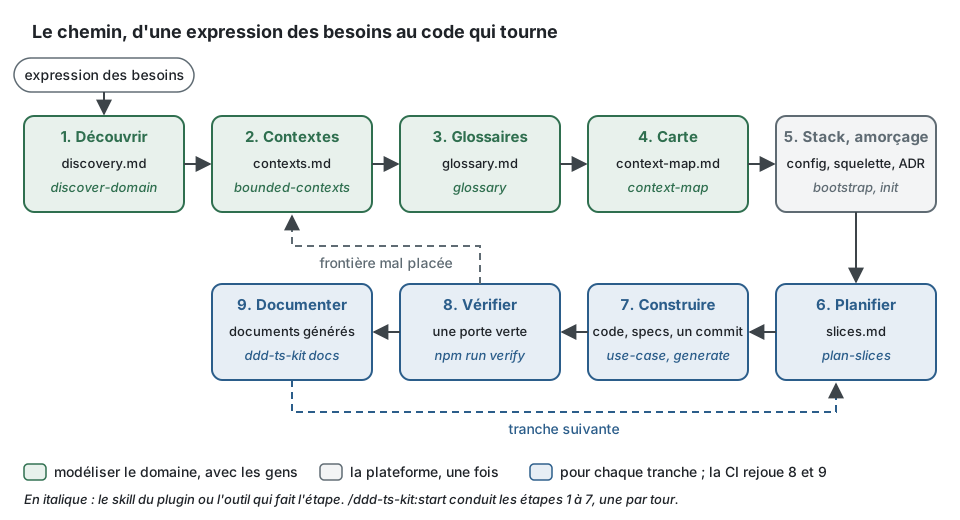
| Étape | Entrée | Artefact produit | Produit par | Finie quand |
|---|---|---|---|---|
| 1. Découvrir | expression des besoins, experts du domaine | docs/architecture/discovery.md |
skill discover-domain (un event storming écrit) |
chaque besoin apparaît comme une commande et un événement du domaine, et chaque désaccord est un point chaud listé |
| 2. Contextes | la chronologie de la découverte | docs/architecture/contexts.md |
skill bounded-contexts |
chaque contexte est un langage et un responsable, le cœur est nommé, chaque frontière est argumentée |
| 3. Glossaires | les noms, les verbes et les faits de chaque contexte | docs/architecture/glossary.md avant l'amorçage, puis le ## Ubiquitous language de chaque CONTEXT.md |
skill glossary ; generate ... --term |
un expert du domaine signerait chaque définition |
| 4. Carte des contextes | les politiques et les modèles de lecture qui franchissent une frontière | docs/architecture/context-map.md (brouillon), puis contexts.<name>.upstreams dans la configuration et docs/context-map.md |
skill context-map ; ddd-ts-kit docs |
chaque flèche a un patron, un contrat et une raison, et il n'y a aucun cycle |
| 5. Stack et amorçage | les contraintes de l'équipe et de l'exploitation ; les trois brouillons | stack dans ddd-ts-kit.config.json, le squelette du projet, le pipeline, un ADR par choix débattu |
skill bootstrap (lancé par une personne), ddd-ts-kit init, generate adr |
npm run verify est vert sur le projet vide, et il est commité |
| 6. Planifier | les commandes et les requêtes de l'étape 1 | docs/architecture/slices.md |
skill plan-slices |
chaque tranche peut être construite et fusionnée seule, dans cet ordre |
| 7. Construire | une tranche | domaine, gestionnaire, adaptateur, route, leurs specs ; un commit par tranche | skill use-case (qui utilise scaffold), ou parallel-work pour plusieurs workers |
il ne reste aucun TODO(domain) ni aucun it.todo dans la tranche |
| 8. Vérifier | le changement | une porte verte | npm run verify, skill quality-gate |
chaque contrôle passe sans nouvelle désactivation |
| 9. Documenter | le diff des documents générés | carte des contextes, la ## Reference de chaque CONTEXT.md, OpenAPI, AsyncAPI, catalogue, ADR |
ddd-ts-kit docs, npm run docs:generate, skill document |
docs --check ne signale rien de périmé |
C'est le chemin pris en charge : suivez-le dans l'ordre. Le README du kit et le README
qu'écrit init en reprennent les étapes ; Quelle commande, quand donne la
commande ou le skill de chaque moment. Une étape sautée se paie plus tard, et le prix est connu :
| Sautée | Ce qui tourne mal |
|---|---|
| 1. Découvrir | le modèle copie les écrans ou les tables ; les politiques entre contextes se découvrent en production |
| 2. Contextes | les frontières suivent le schéma de la base de données, chaque renommage traverse des contextes, et un changement mobilise plusieurs équipes |
| 3. Glossaires | écrit après le code, le glossaire décrit le code au lieu du métier ; les générateurs refusent les noms tant qu'il n'existe pas |
| 4. Carte des contextes | la première intégration est un import direct, que le checker refuse (context/published-language-only, context/declared-relationship), et elle est réécrite tard en événement |
| 5. Amorçage à la main | les fichiers dans lesquels les générateurs enregistrent manquent ; la porte n'est pas verte avant la première ligne, si bien que personne ne sait quel changement l'a cassée |
| 6. Planifier | le travail arrive par couches (toutes les entités, puis tous les gestionnaires) : rien n'est démontrable, et les workers en parallèle se heurtent |
| 7 à 9. Tranche par tranche, porte, documentation | un gros changement non vérifié, des documents générés modifiés à la main, un pipeline rouge que personne ne peut découper par dichotomie |
Sauter une étape est parfois juste (un contexte générique n'a pas besoin d'event storming) ;
c'est alors une décision du propriétaire du projet, enregistrée comme skipped avec sa raison
dans docs/architecture/plan.md.
Les étapes 1 à 7 sont celles que conduit le skill start du plugin (/ddd-ts-kit:start,
lancé par une personne). Il garde l'état du projet dans docs/architecture/plan.md (étapes
faites, décisions, questions ouvertes, et une ligne Next:), si bien qu'une session ultérieure
reprend à partir d'un seul fichier, et il clôt chaque étape sur un oui du propriétaire du projet,
jamais sur son propre jugement. Les étapes 8 et 9 ont lieu à l'intérieur de chaque tranche de
l'étape 7 ; elles sont listées à part parce que ce sont aussi elles que la CI rejoue.
1. Découvrir le domaine : un event storming léger, par écrit
Section intitulée « 1. Découvrir le domaine : un event storming léger, par écrit »L'event storming (Brandolini) se pratique d'ordinaire sur un mur, avec des notes
autocollantes. Les mêmes questions fonctionnent dans un fichier texte, ce qu'une petite équipe ou
un agent de code peut réellement conserver. Le skill discover-domain le rédige à partir des
besoins, ne demande que ce que les besoins ne disent pas, et écrit docs/architecture/discovery.md
sous forme de chronologie. Ses éléments, dans cet ordre :
- Les événements : des faits au passé. « Un rendez-vous a été réservé », « les horaires de travail ont été modifiés », « un rappel a été envoyé ».
- Les commandes : ce que quelqu'un a demandé et qui a causé chaque événement. « Réserver un rendez-vous ».
- Les acteurs : qui donne chaque commande. Un client, un praticien, un job planifié.
- Les politiques : « chaque fois que X s'est produit, alors Y ». « Chaque fois qu'un rendez-vous est réservé, une confirmation est envoyée. » Une politique est le germe d'un gestionnaire d'événement d'intégration.
- Les modèles de lecture : ce que quelqu'un a besoin de voir pour décider. « Les créneaux libres d'un praticien pour une semaine. »
Pour l'application de prise de rendez-vous, un fragment :
| Acteur | Commande | Événement | Politique qui suit | Modèle de lecture nécessaire |
|---|---|---|---|---|
| client | réserver un rendez-vous | rendez-vous réservé | envoyer une confirmation ; planifier un rappel | créneaux libres d'un praticien |
| client ou praticien | annuler un rendez-vous | rendez-vous annulé | libérer le créneau ; prévenir l'autre partie | mes rendez-vous |
| praticien | définir les horaires de travail | horaires de travail modifiés | recalculer les créneaux libres | mon agenda |
| le temps (chaque matin) | envoyer les rappels | rappel envoyé | aucune | rendez-vous du lendemain |
Disposé comme un event storming le lit, de gauche à droite, chaque ligne est une histoire : ce que l'acteur voit, ce qu'il demande, ce qui s'est passé, et ce qui en découle.
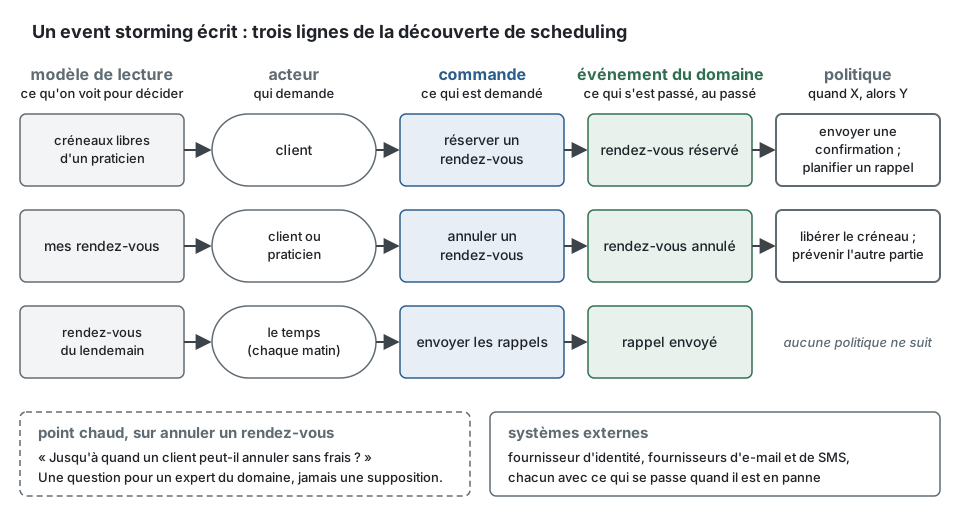
Chaque sorte de note devient plus tard une sorte de code, et c'est pourquoi la découverte vaut d'être écrite : une commande devient une commande et son gestionnaire (étape 7), un événement du domaine un événement que l'agrégat enregistre, une politique qui franchit une frontière un événement d'intégration et son gestionnaire en aval (étape 4), un modèle de lecture une requête ou une projection, un acteur une permission.
Le skill liste aussi les systèmes externes (ici : le fournisseur d'identité, les fournisseurs d'e-mail et de SMS) avec ce qui se passe quand chacun est en panne, et les règles entendues en chemin (« un praticien n'est jamais réservé deux fois »).
Marquez ensuite les points chauds (hot spots) : chaque endroit où deux personnes emploient un même mot différemment, ou où personne ne connaît la règle (« jusqu'à quand un client peut-il annuler sans frais ? »). Un point chaud est une question pour un expert du domaine, jamais une supposition.
Finie quand chaque événement a une commande et un acteur, chaque conséquence transverse est une politique, et les questions ouvertes sont listées.
2. Trouver et classer les contextes
Section intitulée « 2. Trouver et classer les contextes »Regroupez les événements et les commandes qui parlent un même langage et changent ensemble. Le
skill bounded-contexts propose des candidats et éprouve chacun avec vous : le langage (un mot
change-t-il de sens ?), l'autonomie (qui décide des règles ?), la cohérence (qu'est-ce qui doit être
vrai dans la même transaction ?), la taille, et si une personne ou un agent peut le tenir en tête.
Il écrit docs/architecture/contexts.md avec la raison de chaque frontière et les découpages
écartés. Voir Contexte délimité et
l'exemple détaillé.
Classez chacun (core, supporting, generic) : la classification décide où va l'effort de
conception, voir Domaine et sous-domaines.
Finie quand aucun cas d'usage de l'étape 1 n'a besoin d'écrire dans deux contextes en une seule transaction. Si l'un en a besoin, soit les deux ne font qu'un contexte, soit l'exigence devient un processus : l'un décide, l'autre réagit.
3. Écrire les glossaires
Section intitulée « 3. Écrire les glossaires »Avant l'amorçage, le glossaire est un brouillon, docs/architecture/glossary.md, une section par
contexte ; après, le seul exemplaire est le tableau ## Ubiquitous language de chaque
CONTEXT.md. Le glossaire vient avant le code, et les outils tiennent cet ordre : le générateur
refuse un nom dont les mots ne sont pas des termes du contexte, et language/glossary-term le
signale ensuite (tableau des règles).
npx ddd-ts-kit generate context appointments --classification core \ --purpose "Clients book, reschedule and cancel appointments with practitioners. It guards that a practitioner is never booked twice for the same time." \ --term "Appointment=A client's reserved time with a practitioner" \ --term "Book=To reserve a slot for a client" \ --term "Slot=A start and an end instant at which a practitioner can receive"Dès lors, un nom fait de mots que le glossaire ne contient pas est refusé avant qu'aucun fichier
soit écrit. Dans un contexte dont le glossaire contient Order et Place :
$ npx ddd-ts-kit generate command ordering CancelOrder --permission order.cancel --aggregate Ordererror: "CancelOrder" uses "cancel", which the glossary of src/contexts/ordering/CONTEXT.md does not define. fix: Either use an existing term (Order, Place), or add the term in the same command: --term "Cancel=<what it means for the business>". The glossary is written before the code (rule language/glossary-term).La réponse est une définition, pas un contournement : ajoutez
--term "Cancel=To withdraw an order before it is shipped" à la même commande, et le terme
arrive dans CONTEXT.md avec les fichiers.
Remplissez ensuite CONTEXT.md à la main : pour chaque terme, son sens ici et ce avec quoi il ne
faut pas le confondre dans un contexte voisin. Voir
Langage omniprésent.
Finie quand le premier agrégat et le premier cas d'usage peuvent être nommés sans
--allow-name.
4. Dessiner la carte des contextes et choisir les patrons de relation
Section intitulée « 4. Dessiner la carte des contextes et choisir les patrons de relation »Une relation se déclare, elle ne se déduit jamais d'un import. L'aval nomme son amont et le
patron ; published-language est le patron par défaut. Avant l'amorçage, le skill
context-map écrit un tableau brouillon (aval, amont, patron, ce qui passe, pourquoi) ; ensuite,
les relations vivent dans la configuration.
npx ddd-ts-kit generate context notifications --classification supporting \ --upstream appointments:published-languagenpx ddd-ts-kit docsdocs/context-map.md contient alors un diagramme et un tableau générés entre des marqueurs, et
quatre sections écrites en dehors (guide de lecture, pourquoi ces frontières, notes sur les
relations, tensions connues). Écrivez-les : le diagramme montre le quoi, seules des personnes
peuvent dire le pourquoi. Les patrons et leurs coûts sont dans
Carte des contextes.
Déclaré ainsi, l'aval dépend du contrat de son amont, jamais de son modèle. Dans
l'application d'exemple, notification réagit à une
réservation de scheduling :
// Au lieu de : notification va chercher dans le modèle de scheduling (refusé : context/published-language-only)import { Appointment } from '@/contexts/scheduling/domain/aggregates/appointment.aggregate';
// Écrire : notification importe ce que publie scheduling, et y réagitimport { appointmentBookedV1, type AppointmentBookedV1 } from '@/contexts/scheduling/published-language/index';
@IntegrationEventHandler(appointmentBookedV1, { consumer: 'notification.scheduling-appointment-booked' })export class SchedulingAppointmentBookedIntegrationHandler {  async handle(event: AppointmentBookedV1): Promise<void> {    const { patientId, appointmentId, startsAt, status } = event.payload;    // ... envoyer une confirmation (ou une demande, pour une réservation demandée) par le bus de commandes de notification  }}
Le gestionnaire est un extrait de
examples/scheduling/src/contexts/notification/application/integration/handlers/scheduling-appointment-booked.integration-handler.ts.
L'événement est versionné (V1) : scheduling peut changer librement son agrégat, tant qu'il
continue de publier cette charge utile.
Finie quand npx ddd-ts-kit check --rule context/no-cycle --rule context/declared-relationship
ne signale rien et que chaque patron autre que celui par défaut a une phrase de justification.
5. Choisir la stack selon des critères, puis amorcer le projet
Section intitulée « 5. Choisir la stack selon des critères, puis amorcer le projet »Choisir parmi les options prises en charge revient au propriétaire du projet, et ce n'est pas une dérogation. Tranchez chaque ligne avec un critère que vous savez énoncer, et écrivez un ADR pour un choix qui a été débattu :
| Décision | Page |
|---|---|
| Framework HTTP | Frameworks HTTP |
| Bibliothèque de validation | Validation |
| Injection de dépendances | Injection de dépendances |
| ORM et base de données | Persistance |
| Broker, ou aucun | Brokers de messages |
| Cache et verrous | Cache et coordination |
| Fournisseur d'identité | Identité |
| Modèle d'autorisation | Moteurs d'autorisation |
| Traçage, journaux, erreurs | Observabilité |
| Plateforme de CI | Analyse statique et pipeline |
| Lanceur de tests | Lanceurs de tests |
Commencez par le minimum qui fonctionne : aucun broker (le bus en mémoire derrière l'outbox), des rôles pour l'autorisation, un seul déployable. Chacun de ces choix peut changer plus tard en remplaçant un adaptateur ; c'est à cela que servent les ports.
Chaque valeur de stack dans la configuration doit pouvoir se défendre en une phrase.
/ddd-ts-kit:bootstrap est lancé par une personne, pas démarré par l'agent de lui-même. Il
prévisualise avec --dry-run, lance ddd-ts-kit init avec les options choisies, installe, et
prouve le résultat avec npm run verify (pnpm install et pnpm run verify sous pnpm, le
gestionnaire par défaut : init affiche les deux commandes dans les termes du gestionnaire de
paquets choisi, et le projet nu passe toute la porte avant son premier contexte). Un projet
existant est adopté : les fichiers existants sont laissés de côté, sauf si --force est donné.
Un contexte generic pour lequel le kit a un preset est écrit en entier à cette étape plutôt
que construit tranche par tranche : --preset identity écrit les comptes venus du fournisseur
d'identité, les organisations, les membres, les invitations et les délégations, verts tels
qu'écrits (Démarrer avec des contextes bien conçus).
Cette étape est celle qui doit être finie, fusionnée et partagée avant que tout travail en parallèle commence, parce qu'elle crée les fichiers dans lesquels le travail de tous les autres s'enregistre (Travail en parallèle).
Finie quand npm run verify passe sur la branche par défaut et que la porte finale du
pipeline est un contrôle obligatoire.
6. Planifier des tranches verticales par contexte
Section intitulée « 6. Planifier des tranches verticales par contexte »Une tranche est une commande ou une requête, de bout en bout, à l'intérieur d'un contexte : le comportement du domaine, le gestionnaire, l'adaptateur si un nouveau port est nécessaire, la route, les tests. Ordonnez-les par contexte de sorte que chacune soit démontrable :
- la tranche qui crée l'agrégat principal (
BookAppointment) ; - les tranches qui le modifient (
RescheduleAppointment,CancelAppointment) ; - les lectures (
GetAppointment,SearchAppointments) ; - ce qui franchit une frontière : l'événement d'intégration, puis son gestionnaire dans l'aval.
npx ddd-ts-kit list montre ce qui existe par contexte (describe <context> donne un contexte en
entier : cas d'usage, routes, événements, ports, politiques), si bien que le plan est la
différence entre cette sortie et les listes de l'étape 1. Le skill plan-slices l'écrit dans
docs/architecture/slices.md, et npx ddd-ts-kit status le relit : la prochaine étape de
docs/architecture/plan.md, les tranches par statut et par responsable, et ce qui reste à écrire
dans chaque contexte.
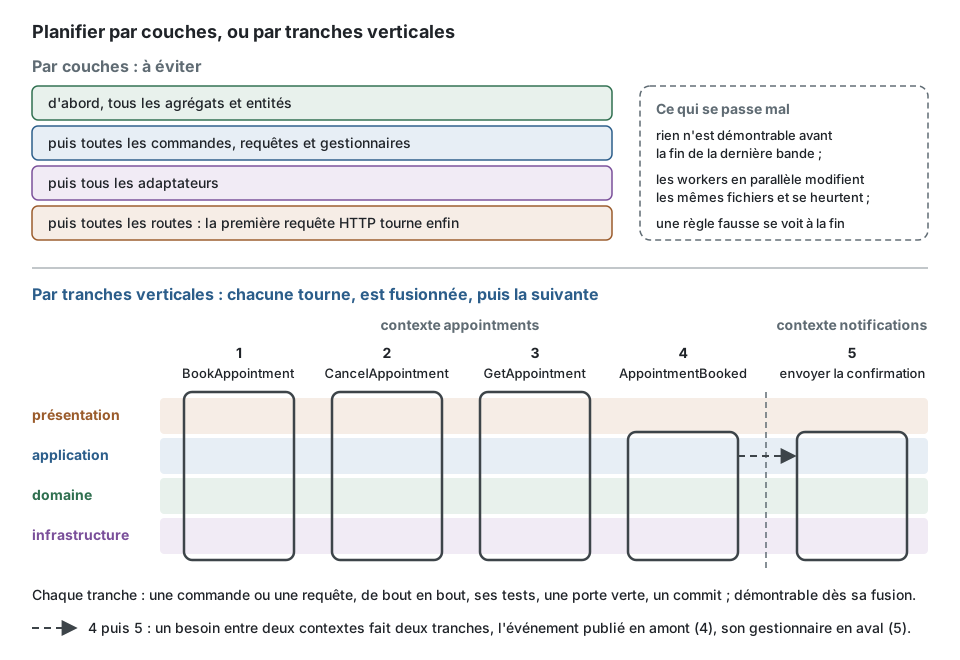
Finie quand aucune tranche ne touche deux contextes, et que chaque besoin entre contextes fait deux tranches : un événement publié en amont, un gestionnaire en aval.
7. Construire, test d'abord, de l'intérieur vers l'extérieur
Section intitulée « 7. Construire, test d'abord, de l'intérieur vers l'extérieur »Le skill use-case conduit une tranche : la reformuler dans les mots du domaine, nommer la
permission (un cas d'usage est protégé ou explicitement public, jamais indécis), générer chaque
fichier avec generate ... --json, n'ouvrir que les endroits TODO(domain) que liste la sortie,
écrire la spec de l'agrégat, puis la spec du gestionnaire avec des fakes, puis l'adaptateur
et la route.
« De l'intérieur vers l'extérieur » commence par la règle elle-même. Pour CancelAppointment, la
spec de l'agrégat s'écrit en premier, dans les mots du glossaire, avec given de
@ddd-ts-kit/testing ; la méthode d'intention de l'agrégat s'écrit ensuite pour la faire passer.
Les deux sont montrées ici dans un seul module ; dans un projet, ce sont
domain/aggregates/appointment.aggregate.ts et test/unit/appointment.aggregate.spec.ts,
générés avec leurs endroits TODO(domain) :
import { AggregateRoot, ConceptError, type DomainEvent } from '@ddd-ts-kit/kernel';import { given } from '@ddd-ts-kit/testing';import { describe, expect, it } from 'vitest';
// Le refus, nommé dans les mots du métier.export class AppointmentError extends ConceptError {  static alreadyCancelled(appointmentId: string) {    return AppointmentError.refusal('APPOINTMENT_ALREADY_CANCELLED', `Appointment ${appointmentId} is already cancelled.`, {      appointmentId,    });  }}
// Le fait, au passé.export class AppointmentCancelled implements DomainEvent {  static readonly eventName = 'appointments.appointment.cancelled';
  readonly name = AppointmentCancelled.eventName;
  constructor(    readonly aggregateId: string,    readonly occurredAt: Date,  ) {}}
type AppointmentStatus = 'booked' | 'cancelled';
export class Appointment extends AggregateRoot {  private constructor(    id: string,    private status: AppointmentStatus,  ) {    super(id);  }
  static book(id: string): Appointment {    return new Appointment(id, 'booked');  }
  get isCancelled(): boolean {    return this.status === 'cancelled';  }
  // Une intention : elle garde sa règle, change l'état et enregistre ce qui s'est passé.  cancel(now: Date): void {    if (this.status === 'cancelled') {      throw AppointmentError.alreadyCancelled(this.id);    }
    this.status = 'cancelled';    this.record(new AppointmentCancelled(this.id, now));  }}
// La spec, écrite en premier : une règle métier par test.const now = new Date('2026-03-01T08:00:00.000Z');
describe('Appointment', () => {  it('is cancelled, and records the fact', () => {    given(Appointment.book('appointment-1'))      .when((appointment) => appointment.cancel(now))      .thenEvents([{ name: 'appointments.appointment.cancelled', aggregateId: 'appointment-1', occurredAt: now }])      .thenState((appointment) => expect(appointment.isCancelled).toBe(true));  });
  it('refuses to be cancelled twice', () => {    const cancelled = Appointment.book('appointment-1');    cancelled.cancel(now);
    given(cancelled)      .when((appointment) => appointment.cancel(now))      .thenError('APPOINTMENT_ALREADY_CANCELLED', { appointmentId: 'appointment-1' });  });});
given écarte les événements enregistrés pendant la mise en place, si bien que thenEvents ne
voit que ce qu'a enregistré l'intention testée. La spec du gestionnaire vient ensuite, à travers
l'application de test avec les fakes qu'a écrits le générateur, puis l'adaptateur et la route :
voir Stratégie de test.
Avec plusieurs workers, un contexte par worker : voir Travail en parallèle.
Finie quand il ne reste dans la tranche aucun TODO(domain) ni aucun it.todo
(npx ddd-ts-kit todo <context> les liste sous forme de file:line) ; un marqueur qui ne peut pas
être résolu est une question pour le propriétaire, listée comme telle.
8. Vérifier
Section intitulée « 8. Vérifier »npm run verify enchaîne les contrôles ; npx ddd-ts-kit check --changed-since origin/main est
la boucle rapide pendant le travail. Une violation porte un identifiant de règle et une phrase de
correction, et npx ddd-ts-kit explain <rule-id> en donne la raison. Corrigez la cause. Une
désactivation, une sévérité abaissée ou un test sauté est une dérogation : elle demande l'accord
du propriétaire et un enregistrement de décision (governance/recorded-deviation).
Finie quand la porte est verte sans nouvelle désactivation.
9. Documenter
Section intitulée « 9. Documenter »Les documents générés se régénèrent, ils ne se modifient jamais : npx ddd-ts-kit docs pour la
carte des contextes, la ## Reference de chaque CONTEXT.md et les barrels ;
npm run docs:generate pour le document OpenAPI, le document AsyncAPI et le catalogue des
événements. Lisez leur diff : c'est le résumé de ce que le changement a fait à l'architecture.
Mettez ensuite à jour les parties écrites que le diff rend périmées, et commitez la documentation
avec le code qui l'a changée (Discipline des commits).
Finie quand npx ddd-ts-kit docs --check et npm run docs:check ne signalent rien.
Limites et quand ne pas s'en servir
Section intitulée « Limites et quand ne pas s'en servir »- La méthode concentre la réflexion au début. Pour un prototype jetable ou un outil CRUD de
trois tables, les étapes 1 à 4 coûtent plus qu'elles ne rapportent. Un contexte
genericou unsupportingsimple mérite un modèle mince ; ne lancez pas une découverte complète pour lui. - Un event storming écrit est un substitut, pas un équivalent. Le format en atelier existe pour réunir experts et développeurs dans une même pièce. Servez-vous de la forme écrite pour préparer ou consigner une conversation, pas pour l'éviter.
- Les premières frontières sont des hypothèses. Attendez-vous à en déplacer une dans les premières semaines ; la section « tensions connues » de la carte des contextes est l'endroit où le soupçon s'écrit avant le déplacement. Déplacer une frontière tard coûte cher : les données se déplacent avec elle.
- Les outils vérifient la forme, pas la vérité. Le checker vérifie qu'un terme existe dans le glossaire, pas que son sens est juste ; qu'une relation est déclarée, pas que le patron convient.
- Le contrôle du glossaire compare les mots grossièrement (voir les limites dans le README de la CLI) : il ne connaît aucun synonyme.
- Alberto Brandolini, Introducing EventStorming, Leanpub (événements, commandes, acteurs, politiques, modèles de lecture, points chauds).
- Eric Evans, Domain-Driven Design, Addison-Wesley, 2003, parties I et IV (langage omniprésent, conception stratégique).
- Vlad Khononov, Learning Domain-Driven Design, O'Reilly, 2021, chapitres 1 à 4 et 12 (sous-domaines, contextes délimités, event storming).
- Michael Nygard, « Documenting Architecture Decisions », 2011.
- Ce dépôt :
plugin/skills, le README de la CLI.