
@ddd-ts-kit/sentry
L'ErrorReporter du noyau sur Sentry ou sur GlitchTip, qui parle le même protocole : un seul
adaptateur, seul le DSN diffère. Les échecs inattendus seulement, chacun menant à sa trace,
nettoyés avant de quitter le processus. Rien dans domain/ ni dans application/ n'importe ce
package, ni ne remonte quoi que ce soit : les gestionnaires (handlers) lèvent une exception, et
ce qui les entoure la remonte.
npm i @ddd-ts-kit/sentry @sentry/node @opentelemetry/apiÉcrit pour @sentry/node 11 : les options sur lesquelles il s'appuie
(enableOpenTelemetrySetup, dataCollection) n'existent pas dans les versions majeures
antérieures.
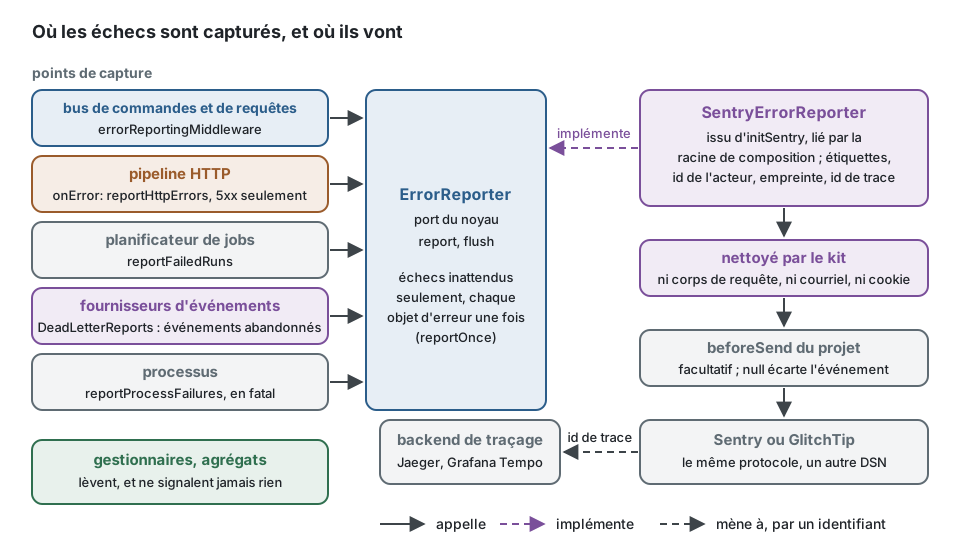
Le code d'un cas d'usage ne voit jamais le rapporteur. Il lève une exception ; ce qui l'entoure
décide si l'échec est un incident, le décrit avec les identifiants du travail en cours et le
confie à l'ErrorReporter du noyau, le seul port que ce package implémente.
Racine de composition
Section intitulée « Racine de composition »// platform/errors.ts : importé en second, juste après platform/tracing.tsimport { reportProcessFailures } from '@ddd-ts-kit/kernel';import { initSentry } from '@ddd-ts-kit/sentry';import { loadConfig } from '@/platform/config/load-config';
// { dsn?, environment, release?, scrubMessages } de la configuration validée.// Sans DSN, rien ne démarre et rien n'est remonté.export const errors = initSentry(loadConfig(process.env).errorReporting);
reportProcessFailures(errors); // uncaughtException et unhandledRejection : remontées, puis sortie 1import { tracing } from '@/platform/tracing'; // en premierimport { errors } from '@/platform/errors'; // en secondimport { DeadLetterReports, ExecutionScope } from '@ddd-ts-kit/kernel';import { createApplication, kernelModule } from '@ddd-ts-kit/di';import { reportHttpErrors } from '@ddd-ts-kit/http';import { RabbitMqEventBus } from '@ddd-ts-kit/rabbitmq';
const deadLetters = new DeadLetterReports(errors);const bus = new RabbitMqEventBus({ url, onFailure: (failure) => deadLetters.onFailure(failure) });
const app = createApplication({ modules: [ kernelModule({ errorReporter: errors, // les bus et les jobs remontent par lui, app.stop() le vide eventBus: bus, eventSubscribers: { forContext: (name) => deadLetters.observing(bus.forConsumer(name)) }, }), ...contexts, ],});
const http = { onError: reportHttpErrors(errors), executionScope: app.resolve(ExecutionScope) };
process.on('SIGTERM', () => void app.stop().then(() => tracing.shutdown()));Trois lignes portent l'ensemble : initSentry, errorReporter: errors,
onError: reportHttpErrors(errors). Les gestionnaires du processus et les files de rejet (dead
letters) tiennent chacun en une ligne, pour qui les veut.
init --errors sentry écrit exactement ces pièces, chacune dans son fichier :
platform/errors.ts comme ci-dessus, avec SENTRY_DSN, SENTRY_ENVIRONMENT (par défaut :
NODE_ENV), SENTRY_RELEASE et SENTRY_SCRUB_MESSAGES lus par
platform/config/load-config.ts ; errors passé par main.ts à composeApplication, qui le
donne à kernelModule({ errorReporter }) ; reportHttpErrors dans
platform/auth/http-boundary.ts ; DeadLetterReports dans
platform/events/create-event-provider.ts (le broker) et dans
platform/events/start-outbox-relay.ts (une publication déclarée morte).
Ordre de chargement. platform/tracing.ts reste le premier import : OpenTelemetry modifie
http et les pilotes lorsqu'ils sont chargés, il doit donc s'exécuter avant eux. initSentry ne
modifie rien, sa place ne change donc rien pour le traçage, quel que soit celui des deux qui
démarre en premier (les deux ordres sont testés). Il vient en second pour qu'un échec pendant le
chargement du reste de l'application soit déjà remonté par reportProcessFailures.
Ce qui est remonté
Section intitulée « Ce qui est remonté »Seulement ce que personne n'a prévu. Une DomainError est un refus métier, une réponse et non un
incident.
| Point de capture | Branché par | Remonte | Ne remonte pas |
|---|---|---|---|
| bus de commandes et de requêtes | kernelModule (les bus par défaut portent errorReportingMiddleware) |
une commande ou une requête qui échoue avec autre chose qu'une DomainError |
une DomainError ; quoi que ce soit pendant la consommation d'un événement |
| HTTP | onError: reportHttpErrors(errors) |
toute requête HTTP qui reçoit une réponse 5xx, une DomainError traduite en 5xx comprise |
une 4xx |
| jobs planifiés | kernelModule (le planificateur par défaut observe avec reportFailedRuns) |
une exécution dont l'issue est failed, dépassements de délai compris |
une DomainError, une occurrence sautée ou manquée |
| événements d'intégration | DeadLetterReports sur le crochet onFailure du fournisseur |
un événement abandonné : nouvelles tentatives épuisées, message empoisonné, publication du relais de l'outbox déclarée morte | une livraison qui échoue et fait l'objet d'une nouvelle tentative |
| processus | reportProcessFailures(errors) |
uncaughtException et unhandledRejection, en fatal |
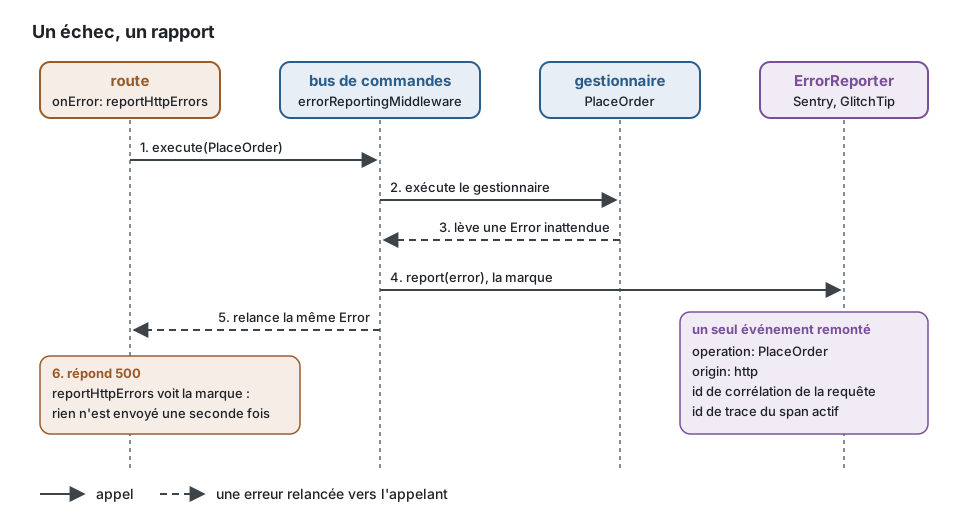
Un échec, un rapport. Le premier point de capture qui voit un objet d'erreur le remonte et le
marque ; les frontières qu'il traverse ensuite le reconnaissent, y compris comme cause d'une
erreur qui l'enveloppe. Une commande qui échoue au sein d'une requête HTTP est donc remontée une
fois, par le bus, sous le nom de la commande, et la route qui répond 500 reste silencieuse. Le
rapport dit tout de même d'où il vient : origin est l'origine du contexte d'exécution (http,
schedule), et l'identifiant de corrélation et la trace mènent à la requête HTTP.
Événements. Un consommateur fait l'objet de nouvelles tentatives : ses premiers échecs sont
attendus, et les remonter enterrerait les vrais incidents. Le middleware du bus ne dit donc
rien pendant la consommation d'un événement, et DeadLetterReports remonte l'événement une fois
que son fournisseur l'abandonne. Les crochets des fournisseurs ne disent que des codes, aussi
observing(subscriber) retient ce que chaque gestionnaire a levé : le rapport porte la vraie
erreur et sa pile. Sans lui, ou pour un message empoisonné, le rapport est une DeadLetterError
qui nomme le code. Un événement enterré par une DomainError est remonté en warning : il est
perdu pour son consommateur tout de même.
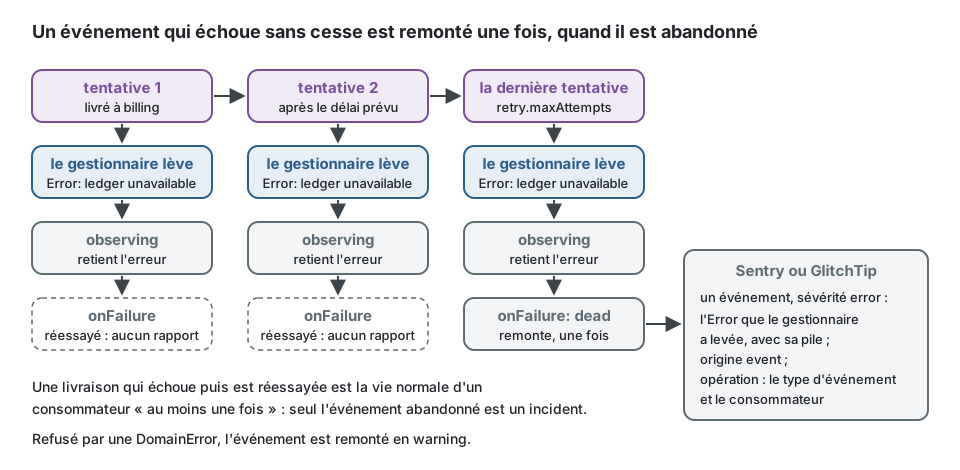
Les mêmes étapes, jouées à la main contre les doubles du noyau, comme le ferait un test du câblage :
import {  DeadLetterReports,  InMemoryErrorReporter,  type IntegrationEvent,  type IntegrationEventCallback,  type IntegrationEventSubscriber,} from '@ddd-ts-kit/kernel';
// Un fournisseur réduit à ce qui compte ici : il garde le gestionnaire qu'on lui donne.const handlers = new Map<string, IntegrationEventCallback>();const provider: IntegrationEventSubscriber = {  subscribe: (type, handler) => {    handlers.set(type, handler);
    return { unsubscribe: () => handlers.delete(type) };  },};
const reporter = new InMemoryErrorReporter();const deadLetters = new DeadLetterReports(reporter);
deadLetters.observing(provider).subscribe('ordering.order.placed', async () => {  throw new Error('ledger unavailable');});
const event: IntegrationEvent = {  id: 'evt-1',  type: 'ordering.order.placed',  version: 1,  occurredAt: '2026-03-01T10:00:00.000Z',  payload: {},};const deliver = handlers.get('ordering.order.placed');
// Ce que le fournisseur dit de chaque livraison échouée : des codes et des identifiants seulement.const failure = { kind: 'handler', code: 'Error', eventId: 'evt-1', eventType: 'ordering.order.placed', consumer: 'billing' };
await deliver?.(event).catch(() => undefined); // la tentative 1 échoue : observing retient l'erreurdeadLetters.onFailure({ ...failure, attempt: 1 }); // nouvelle tentative : aucun rapport
await deliver?.(event).catch(() => undefined); // la tentative 2, la dernière, échouedeadLetters.onFailure({ ...failure, attempt: 2, dead: true }); // abandonné : un rapport
// Un seul rapport : l'Error('ledger unavailable') elle-même, origine 'event', opération 'ordering.order.placed billing'.export const reports = reporter.reports;
Dans un gestionnaire. Rien à écrire : un gestionnaire lève une exception, et le point de capture qui l'entoure la remonte.
import { ConceptError, type ErrorReporter } from '@ddd-ts-kit/kernel';
interface PaymentGateway {  capture(paymentId: string): Promise<'captured' | 'declined'>;}
interface CapturePaymentCommand {  readonly paymentId: string;}
export class PaymentError extends ConceptError {  static declined(paymentId: string) {    return PaymentError.refusal('PAYMENT_DECLINED', `Payment ${paymentId} was declined.`, { paymentId });  }}
// Au lieu de : un gestionnaire qui remonte lui-même, et cache l'échec à son appelant.export class CapturePaymentReportingItself {  constructor(    private readonly gateway: PaymentGateway,    private readonly errors: ErrorReporter,  ) {}
  async execute(command: CapturePaymentCommand): Promise<void> {    try {      await this.gateway.capture(command.paymentId);    } catch (error) {      this.errors.report(error, { origin: 'command', operation: 'CapturePayment', severity: 'error' });    }  }}
// Écrivez : un gestionnaire qui lève une exception. Un refus est une DomainError, à laquelle on répond et qui n'est jamais remontée ;// tout le reste se propage jusqu'au bus, qui le remonte une fois, avec l'acteur, le tenant et la trace.export class CapturePaymentHandler {  constructor(private readonly gateway: PaymentGateway) {}
  async execute(command: CapturePaymentCommand): Promise<void> {    if ((await this.gateway.capture(command.paymentId)) === 'declined') {      throw PaymentError.declined(command.paymentId);    }  }}
Avec OpenTelemetry
Section intitulée « Avec OpenTelemetry »@ddd-ts-kit/tracing possède le fournisseur de traceurs, le gestionnaire de contexte, le
propagateur et les auto-instrumentations. initSentry n'en touche aucun :
enableOpenTelemetrySetup: false: le SDK n'enregistre ni fournisseur de traceurs ni propagateur ;- aucune des intégrations par défaut du SDK, et
enableRuntimeChannelInjection: false: aucune seconde instrumentation dehttpou d'un pilote ; - pas de
tracesSampleRatesauf s'il est donné : aucune donnée de performance ne part vers l'outil de suivi.
Ce qui relie les deux est une seule lecture : quand un échec est remonté, le rapporteur prend
l'identifiant de trace et l'identifiant de span du span OpenTelemetry actif et les met dans
contexts.trace de l'événement. Depuis une issue dans Sentry ou GlitchTip, l'identifiant de
trace ouvre la trace dans le backend de traçage. Les spans eux-mêmes sont exportés une fois,
par l'exportateur du kit.
Confidentialité
Section intitulée « Confidentialité »| Par défaut | Sur demande | |
|---|---|---|
| requête HTTP | jamais collectée. Si autre chose en ajoute une : méthode, URL sans chaîne de requête, en-têtes qui ne portent ni secret d'authentification ni adresse. Aucun corps, aucun cookie | un beforeSend du projet |
| utilisateur | l'identifiant de l'acteur, rien d'autre : ni courriel, ni nom, ni adresse | |
| tenant | non envoyé | tagTenant: true |
| variables locales | jamais | |
| fil d'Ariane (breadcrumbs) | aucun n'est enregistré automatiquement : ni console, ni appel sortant | Sentry.addBreadcrumb là où le projet le décide |
| message de l'exception | envoyé | scrubMessages: true le retire pour chaque erreur qui n'est pas une DomainError |
Messages. Le message est la première chose qu'on lit dans un outil de suivi des erreurs, et
le premier endroit où fuient des données personnelles : un pilote cite la ligne qu'il a refusée.
Par défaut, il est gardé, parce qu'une issue intitulée [message removed] coûte à chaque
investigation, et parce que l'outil de suivi est un outil interne dont le projet contrôle l'accès
et la durée de conservation. Avec scrubMessages: true, seuls survivent les messages que le
projet a écrits lui-même, ceux de ses DomainError ; type, code, pile et trace restent pour les
autres. Activez-le quand l'outil de suivi est hébergé par un tiers ou quand les données sont
assez sensibles pour qu'aucun opérateur ne doive les y lire. Les loggers du kit
(StdoutLogger, @ddd-ts-kit/pino, @ddd-ts-kit/winston) prennent l'option sous le même nom,
avec la même règle et le même marqueur, SCRUBBED_MESSAGE du noyau.
beforeSend s'exécute en dernier, sur l'événement nettoyé, et peut l'écarter en renvoyant
null.
Le DSN reste à l'intérieur du client du SDK. Un SentryErrorReporter journalisé, décomposé ou
sérialisé affiche SentryErrorReporter [client concealed] ; le client du SDK, si vous le
journalisez vous-même, affiche ses options.
Regroupement et étiquettes
Section intitulée « Regroupement et étiquettes »L'empreinte (fingerprint) ne contient jamais le message, si bien que des identifiants dans un
message ne transforment pas un problème en milliers d'issues : une DomainError est sa classe
et son code ; toute autre erreur est sa classe, son code quand elle en a un, et la fonction et le
fichier de son premier cadre de pile, sans numéros de ligne.
Étiquettes : origin, operation, correlation_id, bounded_context, error_code, et
tenant_id sur demande. Les champs qu'un projet ajoute à ErrorReportExtensions sont envoyés
comme contexte report.
| Option | Par défaut | |
|---|---|---|
dsn |
aucun | sans lui, initSentry renvoie un NoopErrorReporter et ne démarre rien. SENTRY_DSN n'est pas lu en dehors de la configuration |
environment, release |
aucun | |
enabled |
true |
false ne remonte rien, quel que soit le DSN |
sampleRate |
1 | part des événements d'erreur envoyés |
tracesSampleRate |
aucun | seulement pour les spans démarrés par l'API de Sentry ; les spans du kit n'y vont jamais |
scrubMessages |
false |
voir « Confidentialité » |
tagTenant |
false |
|
beforeSend |
aucun | s'exécute après le nettoyage du kit |
integrations |
aucune | ajoutées aux erreurs liées et aux lignes de contexte du code source |
flush(timeoutMs) renvoie true quand il ne reste rien à envoyer. app.stop() l'appelle avec
deux secondes ; reportProcessFailures le fait avant de sortir.
GlitchTip pour le développement
Section intitulée « GlitchTip pour le développement »GlitchTip 6 tourne comme un seul service à côté de son PostgreSQL (14 ou ultérieur) et, comme le recommande sa documentation, de Valkey. L'image de développement crée un utilisateur, une organisation et un projet, et affiche le DSN :
services:  glitchtip:    image: glitchtip/glitchtip:6.2.6    profiles: [errors]    depends_on:      glitchtip-postgres: { condition: service_healthy }      glitchtip-valkey: { condition: service_started }    ports: ['127.0.0.1:8000:8000']    environment:      SERVER_ROLE: all_in_one # web et worker dans un seul processus      DATABASE_URL: postgres://postgres:postgres@glitchtip-postgres:5432/glitchtip      VALKEY_URL: redis://glitchtip-valkey:6379      SECRET_KEY: local-development-only-not-a-secret # jamais en production : openssl rand -hex 32      GLITCHTIP_DOMAIN: http://localhost:8000      EMAIL_URL: consolemail://      DEFAULT_FROM_EMAIL: glitchtip@localhost      DEBUG: 'true' # développement seulement : exigé par l'amorçage ci-dessous      GLITCHTIP_BOOTSTRAP_DEV: 'true' # utilisateur test@example.com / admin_pass, organisation, projet, DSN    healthcheck:      test: [CMD, python, healthcheck.py]      interval: 10s      timeout: 6s      retries: 6      start_period: 180s # le premier démarrage migre la base de données  glitchtip-postgres:    image: postgres:18-alpine    profiles: [errors]    environment: { POSTGRES_DB: glitchtip, POSTGRES_PASSWORD: postgres }    volumes: ['glitchtip-postgres:/var/lib/postgresql']    healthcheck:      test: [CMD-SHELL, pg_isready -U postgres -d glitchtip]      interval: 5s      retries: 12  glitchtip-valkey:    image: valkey/valkey:9-alpine    profiles: [errors]
volumes:  glitchtip-postgres:
docker compose --profile errors up -d --waitdocker compose logs glitchtip | grep 'DSN:'Mettez le DSN dans SENTRY_DSN ; depuis un autre conteneur de l'ensemble Compose, remplacez
localhost par glitchtip. Connectez-vous sur http://localhost:8000 avec l'utilisateur
ci-dessus.
Dans un test
Section intitulée « Dans un test »Rien de ce package : l'application de test lie InMemoryErrorReporter, et
app.errors.reports liste ce que les bus et les jobs ont remonté, sous forme de données :
chaque entrée est { error, report }, l'erreur telle qu'elle a été levée et l'ErrorReport qui
la décrit.