
Économie de tokens : dépenser moins avec les agents de code
Résumé. Un agent de code paie tout ce qu'il lit, à chaque tour, et sur un projet sans structure l'essentiel de ce qu'il lit sert à découvrir où se trouvent les choses. Ce kit retire une grande part de ce coût par construction : des chemins prévisibles, un concept par petit fichier, du code répétitif généré, des cartes lisibles par une machine, des règles délimitées par chemin et une documentation générée par contexte. La première moitié de ce guide explique pourquoi cela fonctionne et les habitudes qui vont avec. La seconde moitié passe en revue des outils complémentaires largement utilisés et maintenus au 2026-10-10 (navigation par symboles à travers un serveur de langage, recherche structurelle et textuelle, index de symboles, empaqueteurs de dépôt, récupération de la documentation des bibliothèques), avec ce que fait chacun, sa maturité, ses limites et la façon dont il se combine avec le kit, et se termine par un tableau de décision. Aucun outil ci-dessous n'est exigé par le kit.
Où partent les tokens
Section intitulée « Où partent les tokens »Une session d'agent renvoie toute sa conversation à chaque requête, et chaque résultat d'outil (un fichier lu, une sortie de recherche, un journal de tests) reste dans cette conversation jusqu'à ce qu'elle soit effacée ou compactée. Trois coûts dominent :
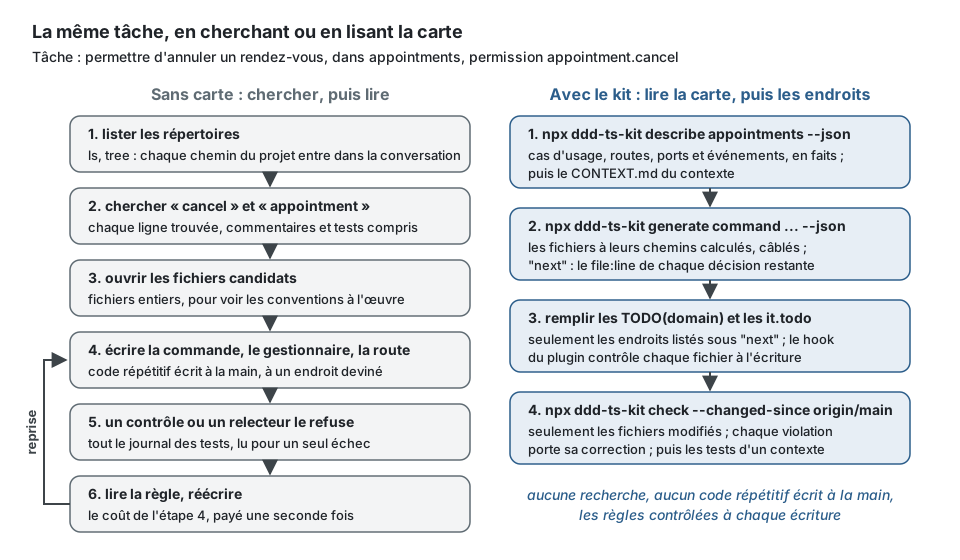
- L'exploration : lister des répertoires, chercher, ouvrir des fichiers candidats pour trouver celui qui compte.
- Lire plus que nécessaire : un fichier de 900 lignes ouvert pour une méthode ; un journal de tests de dix mille lignes lu pour un seul échec.
- La reprise : du code écrit au mauvais endroit ou sous la mauvaise forme, puis repéré par un contrôle ou un relecteur, et réécrit.
La sortie est la part la plus petite, et le code répétitif généré en retire l'essentiel. Les leviers sont donc : savoir où regarder sans chercher, lire de petites choses, et avoir juste du premier coup.
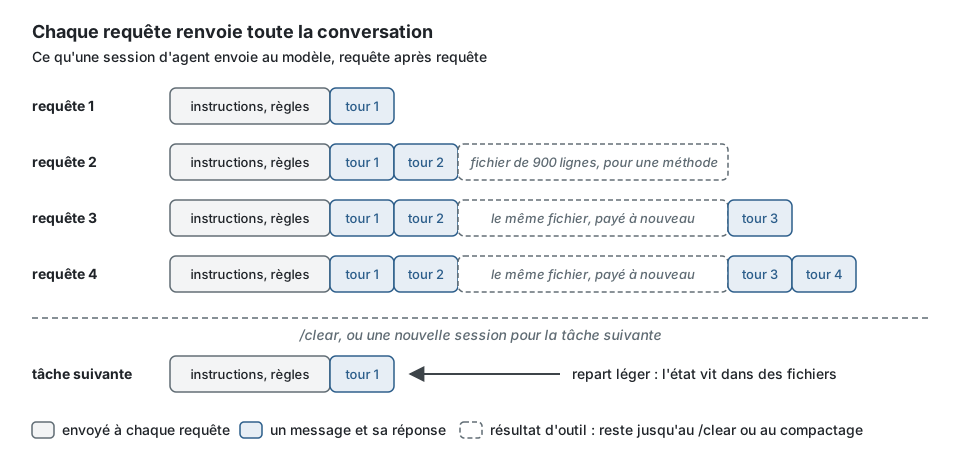
Le deuxième coût est celui qui grossit en silence : un résultat d'outil ne se paie pas une fois, il se paie à chaque requête qui suit, jusqu'à ce que la conversation soit effacée ou compactée. Lire 40 lignes au lieu de 900 économise à chaque tour suivant de la session, pas seulement au tour qui les a lues.
Pourquoi la structure économise des tokens
Section intitulée « Pourquoi la structure économise des tokens »| Propriété d'un projet construit avec le kit | Ce que l'agent ne fait plus |
|---|---|
Des chemins prévisibles. L'arborescence canonique est fermée, et le rôle d'un fichier tient dans son répertoire et son suffixe (*.aggregate.ts, *.handler.ts, *.repository.ts) |
chercher « où est le gestionnaire de X » : le chemin se calcule à partir du nom du cas d'usage |
Un concept par petit fichier (naming/one-concept-per-file, un plafond de taille sur les fonctions et les fichiers) |
lire un gros fichier pour en utiliser dix lignes |
Du code répétitif généré. generate écrit le fichier, sa spec, son builder et son câblage |
écrire, et se tromper subtilement sur, la visibilité du constructeur, le suffixe, l'enregistrement |
Une sortie --json avec next : le file:line de chaque TODO(domain) |
ouvrir les fichiers générés pour trouver ce qui reste à décider |
Des cartes lisibles par une machine. ddd-ts-kit list --json donne les contextes, agrégats, cas d'usage, événements, gestionnaires et permissions ; describe <context> --json donne un contexte sous forme de faits (les cas d'usage avec leur permission, les routes, les événements, les ports avec leurs adaptateurs, les politiques, les gateways, les dépendances) ; status et todo donnent la prochaine étape du plan, les tranches et les marqueurs restants sous forme de file:line |
parcourir l'arborescence pour apprendre ce qui existe et ce qui reste |
Des règles délimitées par chemin. init écrit .claude/rules/*.md, chacune délimitée par un frontmatter paths, les mêmes règles pour Copilot dans .github/instructions/, délimitées par applyTo, à côté d'un AGENTS.md court que lit chaque agent |
garder les règles du domaine en contexte pendant qu'il modifie une route, et l'inverse |
Une documentation générée par contexte. CONTEXT.md avec ses listes générées et sa ## Reference, docs/context-map.md |
lire le code d'un contexte voisin pour apprendre ce qu'il publie |
Une phrase de correction sur chaque violation, et explain <rule-id> |
deviner une règle à partir d'un contrôle en échec |
| Des contrôles à chaque écriture (le hook du plugin lance le contrôle par fichier) | découvrir une violation de couche une fois toute la fonctionnalité écrite |
| Des niveaux de test rapides et locaux : les specs du domaine et de l'application tournent en millisecondes sans infrastructure | attendre, et lire la sortie, d'une stack complète pour vérifier une règle |
La même tâche, faite des deux façons :
Le hook de début de session du plugin rappelle aussi l'ordre de travail, la prochaine étape du
plan et une carte d'une ligne par contexte, de taille plafonnée, si bien qu'une nouvelle session ne
commence pas par les redécouvrir. Quand le ddd-ts-kit installé n'est pas la version que décrivent
les skills du plugin, une ligne le dit d'abord, avec ce qu'il faut faire. Sur l'application d'exemple,
avec la CLI installée, une session commence par :
ddd-ts-kit project (DDD, Clean Architecture). The rules are checked: `npx ddd-ts-kit explain <rule-id>`.Order of work: glossary of the context (CONTEXT.md), `npx ddd-ts-kit generate <kind> ... --json`, fill only the TODO(domain) places it lists, tests, `npx ddd-ts-kit check --changed-since <ref>`, then commit the slice.Never write by hand a file a generator produces; never edit a generated file (declaration barrels, contracts).Read `npx ddd-ts-kit list --json` and the CONTEXT.md of one context instead of browsing the tree.Plan: docs/architecture/plan.md (resume with /ddd-ts-kit:start). Next: doneContexts:analytics [supporting] upstreams: scheduling; glossary: 9 terms; 0 aggregates, 0 commands, 1 queries, 0 published eventsidentity [supporting] upstreams: none; glossary: 21 terms; 3 aggregates, 7 commands, 0 queries, 6 published eventsnotification [supporting] upstreams: scheduling, identity; glossary: 16 terms; 2 aggregates, 4 commands, 1 queries, 0 published eventsscheduling [core] upstreams: identity; glossary: 65 terms; 4 aggregates, 19 commands, 8 queries, 8 published eventsDix lignes, et l'agent connaît les règles de la maison, l'état du projet et ce que contient chaque contexte, avant d'avoir ouvert un seul fichier.
Rien de tout cela n'est propre à un produit d'agent : une convention de chemins et une carte JSON aident tout outil qui lit des fichiers. Les fichiers de règles délimitées par chemin et le hook utilisent les formats de Claude Code, puisque le plugin du kit le cible.
Habitudes
Section intitulée « Habitudes »Générer, puis remplir. Lancez le générateur avec --json, ouvrez seulement les emplacements
listés sous next, implémentez chaque TODO(domain), remplacez chaque it.todo. Ne demandez pas
à un agent de « créer un agrégat » : demandez-lui de lancer le générateur et de remplir les trois
décisions qu'il liste.
npx ddd-ts-kit generate command ordering PlaceOrder --permission order.place --grant customer --aggregate Order --jsonrépond, en abrégé (todos reprend chaque endroit de next avec la décision à y prendre) :
{ "dryRun": false, "created": [ "src/contexts/ordering/application/authorization/ordering.permissions.ts", "src/contexts/ordering/application/commands/place-order/place-order.command.ts", "src/contexts/ordering/application/commands/place-order/place-order.handler.ts", "src/contexts/ordering/test/unit/place-order.handler.spec.ts" ], "updated": [ "src/platform/auth/role.ts", "src/platform/auth/roles.ts", "src/contexts/ordering/ordering.declarations.ts", "src/contexts/ordering/CONTEXT.md" ], "skipped": [], "next": [ "src/contexts/ordering/application/commands/place-order/place-order.command.ts:7", "src/contexts/ordering/application/commands/place-order/place-order.handler.ts:16", "src/contexts/ordering/test/unit/place-order.handler.spec.ts:38", "src/platform/auth/roles.ts:15" ]}Quatre emplacements file:line forment toute la liste de lecture de la tâche : l'entrée de la
commande, la décision du gestionnaire, les tests à écrire, l'attribution au rôle à vérifier.
L'agent lit ces lignes et leurs voisines, pas les quatre fichiers depuis le début, et jamais
les fichiers que le générateur a câblés pour lui.
Lire la carte, pas l'arborescence. Commencez par npx ddd-ts-kit describe <context> --json
(ou list --json pour tout le projet) et le CONTEXT.md du contexte en cours ;
npx ddd-ts-kit todo <context> dit ensuite ce qui reste à écrire, sous forme de file:line.
Lisez le CONTEXT.md et le published-language/ d'un contexte voisin, jamais ses entrailles : les
règles interdisent de toute façon d'en dépendre.
# Au lieu de : parcourir l'arborescence et lire ce que la recherche renvoiels -R src/contexts/orderinggrep -rn "Handler" src/contexts/ordering
# Écrire : un seul appel, rien que des faitsnpx ddd-ts-kit describe ordering --json
Un extrait de ce qu'il répond, pour le contexte de la première tranche ci-dessus :
{ "name": "ordering", "classification": "core", "useCases": [ { "kind": "command", "name": "PlaceOrder", "permission": "order.place", "file": "src/contexts/ordering/application/commands/place-order" } ], "ports": [ { "name": "OrderRepository", "kind": "repository", "adapters": ["DrizzleOrderRepository"], "file": "src/contexts/ordering/domain/repositories/order.repository.ts" } ]}La réponse complète liste aussi le glossaire, les contextes amont et aval, les agrégats, les
routes avec leurs gardes, leurs réponses et leurs codes d'erreur, les événements publiés et
consommés, les politiques, les jobs et les contrats. todo répond une ligne par marqueur :
src/contexts/ordering/application/commands/place-order/place-order.handler.ts:16 TODO(domain) decide what "place order" does to a Order: ...src/contexts/ordering/test/unit/place-order.handler.spec.ts:39 it.todo applies the business decision to the orderDe petites tâches bien délimitées. Un cas d'usage dans un contexte par tâche, puis une
nouvelle session. Une tâche énoncée comme « ajouter la possibilité d'annuler un rendez-vous, dans
appointments, permission appointment.cancel » donne à l'agent le contexte, le chemin et le
vocabulaire ; « améliorer le parcours de réservation » le fait fouiller.
Au lieu de :  Améliorer le parcours de réservation.
Écrire :  Dans appointments, ajouter CancelAppointment : un client annule l'un de ses rendez-vous,  permission appointment.cancel, refusé quand le rendez-vous est déjà annulé  (APPOINTMENT_ALREADY_CANCELLED). Route POST /appointments/:id/cancel.  Générer, remplir les endroits TODO(domain), puis check --changed-since origin/main.
La seconde consigne nomme le contexte (un répertoire), le cas d'usage (les noms de fichiers en découlent), la permission, le code de refus et la route : chacun de ses mots économise une recherche.
Un contexte par agent. Avec plusieurs agents, chacun possède un répertoire et reçoit le contrat de son amont, pas le code de cet amont ; voir Travail en parallèle. Rappelez-vous que chaque agent porte sa propre fenêtre de contexte : le parallélisme achète du temps, pas des tokens.
Contrôler au plus près pendant le travail. npx ddd-ts-kit check --changed-since origin/main
et les tests d'un seul contexte, pas toute la porte après chaque modification. Lancez
npm run verify une fois, à la fin.
npx ddd-ts-kit check --changed-since origin/main # les règles, sur les seuls fichiers modifiésnpx vitest run src/contexts/ordering # les tests d'un seul contextenpm run verify # toute la porte, une fois, avant le commitGarder les sorties bruyantes hors de la conversation principale. Lancez les longues suites de
tests et la lecture des journaux dans un sous-agent, ou filtrez la sortie avant qu'elle soit lue.
Ne demandez que les échecs : avec Vitest 5, le lanceur de tests qu'installe init,
--reporter=minimal affiche les tests en échec et rien d'autre.
npx vitest run src/contexts/ordering --reporter=minimalEffacer entre deux tâches sans rapport. Un contexte périmé se paie de nouveau à chaque tour suivant.
Garder l'état dans des fichiers, pas dans la conversation. Le skill start du plugin
enregistre où en est le projet dans docs/architecture/plan.md, et son étape plan-slices écrit
les tranches dans docs/architecture/slices.md, si bien qu'une nouvelle session reprend à partir
de deux fichiers courts au lieu d'un long historique, et npx ddd-ts-kit status relit les deux en
quelques lignes :
Next: 7 use-case - fill the TODO(domain) places of PlaceOrder
Slices (docs/architecture/slices.md): 3, 1 in progress, 1 todo, 1 done  in progress    #2 ordering slice "Place order" (owner ordering, depends on 1)  todo    #3 ordering slice "Cancel order" (owner ordering, depends on 2)  by owner    conductor: 1 done    ordering: 1 in progress, 1 todo
Remaining  ordering: 25 TODO(domain), 0 TODO(platform), 11 it.todo  outside the contexts: 9 TODO(domain), 6 TODO(platform), 0 it.todo
Ne pas coller ce qu'un chemin peut dire. Renvoyez à docs/ARCHITECTURE.md par identifiant de
règle plutôt que de le citer ; les skills du plugin font de même, à dessein.
Outils complémentaires
Section intitulée « Outils complémentaires »Vérifiés le 2026-10-10 sur le dépôt et la documentation de chaque projet. Les étoiles et les dates montrent l'activité, pas la qualité. Les économies sont qualitatives : aucun chiffre d'éditeur ci-dessous n'a été reproduit ici, et quand un projet en publie un, il est cité comme sa propre affirmation.
Navigation par symboles à travers un serveur de langage
Section intitulée « Navigation par symboles à travers un serveur de langage »Un serveur de langage répond à « où ceci est-il défini » et « qui y fait référence » à partir de la compréhension du code qu'a le compilateur lui-même, en un appel, là où une recherche textuelle renvoie chaque ligne qui contient le mot.
- Un plugin de serveur de langage de l'agent lui-même. Claude Code documente des « code
intelligence plugins » : un par langage, qui relie l'agent à un serveur de langage par LSP. Pour
TypeScript, le plugin est
typescript-lspet le binaire à installer esttypescript-language-server(v6.0.2 publiée le 2026-10-09). L'agent y gagne des diagnostics après chaque modification et un outil de navigation en lecture seule. Limites déclarées : sessions en terminal seulement (pas démarré dans les sessions cloud), consommation de mémoire pendant que le serveur indexe, et de possibles faux diagnostics dans un monorepo. - Serena (
oraios/serena, environ 30 000 étoiles, v1.7.0 publiée le 2026-08-09, des commits cette semaine). Un serveur MCP qui donne à tout agent compatible MCP la recherche et la modification au niveau des symboles : trouver un symbole, un aperçu des symboles d'un fichier, les symboles qui y font référence, renommer, remplacer le corps d'un symbole. Il s'appuie par défaut sur des serveurs de langage (plus de 40 langages listés, TypeScript compris) ou sur un plugin JetBrains payant. Il s'installe avecuv; son README demande de ne pas l'installer par une place de marché de plugins. Licence : l'application est sous GPL-3.0-or-later, sa bibliothèque de serveurs de langage sous MIT. Limites déclarées : la recherche de déclaration échoue en général pour les dépendances externes, la recherche des implémentations dépend du serveur de langage, et déplacer, intégrer (inline) ou déboguer interactivement exigent le moteur JetBrains.
Avec ce kit : la navigation par symboles sert surtout aux jointures que l'arborescence ne rend pas évidentes : qui appelle un port, quels gestionnaires utilisent un objet-valeur, où un événement d'intégration est consommé. À l'intérieur d'un contexte, la convention de chemins répond déjà à « où ». Choisissez l'un des deux, pas les deux : deux serveurs de langage sur un même projet doublent la mémoire et le temps de démarrage.
Limites : un serveur de langage doit indexer le projet avant de répondre, et il reflète l'état des fichiers, si bien qu'il est plus lent et plus lourd qu'une recherche par chemin. Le kit compile avec TypeScript 7 natif et garde TypeScript 6 pour les outils qui ont besoin de l'API JavaScript du compilateur ; lequel des deux un serveur de langage charge, et s'il s'accorde avec votre build sur chaque diagnostic, n'a pas été vérifié ici.
Recherche structurelle : ast-grep
Section intitulée « Recherche structurelle : ast-grep »ast-grep/ast-grep (environ 16 000 étoiles, MIT, 0.50.0 publiée le 2026-10-09). Il cherche,
analyse et réécrit le code par arbre syntaxique, en s'appuyant sur tree-sitter, avec des motifs
écrits comme du code avec des emplacements ($NAME), et des règles en YAML. TypeScript et TSX
sont pris en charge.
Ce qu'il économise : une question comme « chaque classe qui étend AggregateRoot et a un
constructeur public » ou « chaque appel de publish dans application/queries » devient une
requête précise au lieu d'une recherche textuelle suivie de la lecture des faux positifs. Il
effectue aussi des réécritures mécaniques sur de nombreux fichiers sans que l'agent ait à
modifier chacun d'eux.
Limites : il reconnaît la syntaxe, pas le sens. Il n'a aucune information de type et ne résout aucun import, il ne peut donc ni distinguer deux classes du même nom ni suivre une réexportation (sa documentation ne prétend pas le contraire ; c'est inhérent à un outil fondé sur tree-sitter). Il est encore en version antérieure à 1.0.
Avec ce kit : le plugin ESLint porte déjà les règles structurelles propres à l'architecture. Utilisez ast-grep pour des questions ponctuelles et des migrations uniques, pas pour réimplémenter une règle.
Recherche textuelle : ripgrep
Section intitulée « Recherche textuelle : ripgrep »BurntSushi/ripgrep (environ 69 000 étoiles, MIT ou Unlicense, 15.2.0 publiée le 2026-07-15).
Une recherche récursive par expression régulière qui respecte .gitignore. C'est la base :
rapide, sans index, sans mise en place, et plusieurs agents l'utilisent sous leur propre outil de
recherche.
Ce qu'il économise : avec ce kit, beaucoup, parce que les suffixes rendent les motifs de
fichiers exacts : rg -l "appointment.cancel" -g "*.command.ts", ou
rg --files -g "*.integration-handler.ts" pour lister chaque consommateur. Listez les fichiers
(-l) avant de lire les correspondances, et bornez la sortie.
Limites : du texte seulement : il trouve un nom dans un commentaire et manque un import renommé.
Index de symboles : Universal Ctags et SCIP
Section intitulée « Index de symboles : Universal Ctags et SCIP »- Universal Ctags (
universal-ctags/ctags, environ 7 000 étoiles, GPL-2.0, v6.2.1 publiée le 2025-10-25, des commits cette semaine). Il écrit un index à plat des définitions (nom, fichier, ligne, nature). Peu coûteux à construire, indépendant du langage, et suffisant pour répondre à « où X est-il défini » depuis un fichier qu'un script peut lire. Limites : des définitions seulement, ni références ni types ; son analyseur TypeScript est syntaxique. - SCIP (
scip-code/scip, auparavant sous l'organisationsourcegraph, Apache-2.0, v0.10.0 publiée le 2026-09-03) est un protocole d'index de code précis : définitions et références résolues par un vrai compilateur.scip-typescriptest l'indexeur pour TypeScript (v0.4.0 publiée le 2025-10-02, dépôt actif cette semaine). Limites : c'est un format d'index fait pour les plateformes de recherche de code ; aucune intégration à un agent n'a été vérifiée ici, si bien que l'utiliser depuis un agent suppose un consommateur à écrire soi-même. Il lit le projet par l'API du compilateur TypeScript ; qu'il fonctionne avec la double installation TypeScript 6 et 7 d'un projet généré n'a pas été vérifié.
Avec ce kit : ddd-ts-kit list --json (et describe <context> --json) est déjà un index des
concepts de l'architecture (agrégats, cas d'usage, événements, gestionnaires, permissions). Un
index de symboles le complète pour tout ce qui se trouve sous ce niveau. Pour la plupart des
projets, un serveur de langage couvre le besoin et aucun de ces deux outils ne vaut la peine
d'être mis en place.
Empaqueteurs de dépôt : Repomix
Section intitulée « Empaqueteurs de dépôt : Repomix »yamadashy/repomix (environ 29 000 étoiles, MIT, v1.18.1 publiée le 2026-09-21). Il empaquette
un dépôt, ou une sélection, en un seul fichier pour un modèle, avec le nombre de tokens par
fichier, des motifs d'inclusion et d'exclusion, un contrôle des secrets (Secretlint) actif par
défaut, et un serveur MCP facultatif. --compress garde les signatures et retire les corps grâce
à tree-sitter ; le projet le qualifie d'expérimental et annonce une réduction d'environ 70 %, un
chiffre qui est le sien.
Ce qu'il économise : il ne réduit pas ce qu'un modèle lit, il remplace de nombreux appels
d'outil par un seul document. Cela convient à une question ponctuelle posée à un modèle sans
outils (« relis le langage publié de ces deux contextes »), à une passation, ou à la mesure de
l'endroit où partent les tokens d'un dépôt (--token-count-tree).
Limites : pour un agent qui sait déjà lire des fichiers à la demande, empaqueter tout un dépôt
coûte en général plus de tokens qu'il n'en économise : tout est lu, utile ou non. Empaquetez un
contexte, ou seulement les fichiers published-language/ et CONTEXT.md, jamais src/ en
entier.
Avec ce kit : l'arborescence fermée rend les sélections exactes, par exemple chaque
CONTEXT.md et chaque dossier published-language/ comme résumé compact de tout le système.
Récupération de la documentation des bibliothèques : Context7
Section intitulée « Récupération de la documentation des bibliothèques : Context7 »upstash/context7 (environ 63 000 étoiles, MIT pour le client et le serveur MCP, publié presque
chaque jour ; @upstash/context7-mcp 4.3.0 le 2026-10-09). Il renvoie, à la demande, la
documentation et les exemples d'une bibliothèque pour une version donnée, par un serveur MCP
(resolve-library-id, query-docs) ou une CLI utilisée par un skill.
Ce qu'il économise : l'agent ne devine plus une API à partir de données d'entraînement antérieures à la version majeure actuelle de la bibliothèque (plusieurs dépendances de ce kit ont changé de version majeure récemment : Express 5, Fastify 5, zod 4, Prisma 7) et ne va plus chercher puis lire des pages de documentation entières.
Limites, telles que le projet les énonce : la documentation est fournie par la communauté et son exactitude, sa complétude et sa sécurité ne sont pas garanties ; le service est hébergé, son moteur, son analyseur et son robot d'exploration ne sont pas libres ; une clé d'API est recommandée pour des limites de débit plus hautes. C'est un service tiers qui reçoit vos requêtes : traitez ce qu'il renvoie comme une entrée non fiable, et vérifiez une réponse surprenante dans la documentation de la bibliothèque elle-même.
Avec ce kit : les packages du kit sont documentés par leurs README dans le dépôt et dans
node_modules ; lisez-les directement. Utilisez la récupération de documentation pour les
bibliothèques tierces derrière les adaptateurs.
Index sémantiques (par plongements)
Section intitulée « Index sémantiques (par plongements) »Des outils qui plongent le code dans une base vectorielle et le retrouvent par similarité
existent et sont utilisés ; zilliztech/claude-context en est un (environ 12 600 étoiles, MIT,
dernier commit le 2026-07-14, aucune version étiquetée sur GitHub). Il exige un fournisseur de
plongements (embeddings) et une base Milvus ou Zilliz Cloud, et annonce une réduction d'environ
40 % des tokens à qualité de récupération égale, une mesure qui est la sienne. Il n'a pas été
évalué ici, et il envoie le code à un service de plongements, sauf si un modèle local est
configuré. Sur un projet à l'arborescence fermée et aux suffixes de rôle, la recherche par
similarité répond à une question à laquelle les chemins répondent déjà en grande partie ; ce
guide ne le recommande pas par défaut.
Tableau de décision
Section intitulée « Tableau de décision »| Problème | Outil | Économie attendue | Coût de mise en place |
|---|---|---|---|
| « Qu'est-ce qui existe dans ce projet ? » | ddd-ts-kit list --json, describe <context> --json, CONTEXT.md, docs/context-map.md |
élevée : remplace le parcours de l'arborescence | aucun, généré |
| « Où va ce fichier, comment s'appelle-t-il ? » | l'arborescence canonique, ddd-ts-kit generate |
élevée : ni recherche, ni code répétitif écrit | aucun |
| « Que reste-t-il à écrire dans ce qui a été généré ? » | generate --json (next, todos), ddd-ts-kit todo [<context>], ddd-ts-kit status |
élevée : n'ouvre que les endroits à remplir | aucun |
| « Pourquoi ce contrôle échoue-t-il ? » | le fix de la violation, ddd-ts-kit explain <rule-id> |
moyenne : pas de lecture de la référence | aucun |
| « Qui appelle ou implémente ce symbole ? » | un plugin de serveur de langage de l'agent, ou Serena | moyenne à élevée sur les questions entre contextes | installer un serveur de langage et un plugin ou un serveur MCP ; de la mémoire pendant l'indexation |
| « Chaque endroit qui a cette forme de code », une réécriture mécanique | ast-grep | moyenne : une requête, aucun faux positif à lire | un binaire ; apprendre la syntaxe des motifs |
| « Chaque fichier de ce rôle qui mentionne X » | ripgrep avec des motifs de suffixe | moyenne | en général déjà installé |
| « Où X est-il défini ? », sans serveur de langage | Universal Ctags | faible à moyenne | un binaire et une étape de régénération |
| Un index de références croisées précis pour un outil maison | SCIP avec scip-typescript |
inconnue ici : non vérifié avec un agent | une étape d'indexation et un consommateur à écrire |
| Une question ponctuelle à un modèle sans outils ; une passation ; un recensement des tokens | Repomix sur une sélection | moyenne dans ces cas, négative pour empaqueter tout un dépôt dans un agent | npx, aucune installation |
| « Quelle est l'API actuelle de cette bibliothèque ? » | Context7 | moyenne : ni devinette, ni lecture de pages | un serveur MCP ou un skill, une clé d'API recommandée ; service tiers |
| Une longue sortie de tests ou de journaux | un sous-agent, ou un filtre avant que la sortie soit lue | moyenne à élevée | quelques lignes de configuration |
Commencez par les quatre premières lignes, qui ne coûtent rien. Ajoutez ensuite un serveur de langage. N'ajoutez le reste que pour un problème que vous avez constaté : chaque serveur MCP et chaque outil ajoutent aussi leurs propres définitions et leurs propres modes de défaillance.
Limites et quand ne pas s'en servir
Section intitulée « Limites et quand ne pas s'en servir »- La structure se paie d'avance. Le glossaire, l'arborescence fermée et le générateur sont un coût sur un petit script ; l'économie apparaît avec le nombre de fichiers et de sessions.
- Une carte peut être périmée.
listlit le code, elle ne peut donc pas l'être ; une section écrite à la main deCONTEXT.mdle peut. La porte de dérive ne couvre que les listes générées. - Les petites tâches demandent quelqu'un pour les découper. Les habitudes ci-dessus déplacent l'effort de l'agent vers la personne qui écrit la consigne.
- Les économies ne sont pas mesurées ici. Ce guide rapporte des mécanismes et les affirmations des outils eux-mêmes. Mesurez sur votre projet : la plupart des agents indiquent les tokens consommés par session.
- Les outils changent vite. Les versions et les dates ci-dessus sont un instantané du 2026-10-10. Consultez le dépôt avant d'en adopter un, et préférez un outil dont la défaillance laisse l'agent capable de se rabattre sur la lecture des fichiers.
- Plus d'outils ne veut pas dire moins de coût. Chaque serveur ajoute du temps de démarrage, de la mémoire et du contexte ; un serveur de langage et une recherche textuelle couvrent la plupart des besoins.
- Documentation de Claude Code, « Manage costs effectively » (réduire la consommation de tokens : gestion du contexte, code intelligence plugins, hooks, skills, sous-agents), https://code.claude.com/docs/en/costs
- Documentation de Claude Code, « Code intelligence plugins », https://code.claude.com/docs/en/plugins/code-intelligence
- Serena, https://github.com/oraios/serena
- ast-grep, https://ast-grep.github.io/ et https://github.com/ast-grep/ast-grep
- ripgrep, https://github.com/BurntSushi/ripgrep
- Universal Ctags, https://github.com/universal-ctags/ctags
- SCIP, https://github.com/scip-code/scip et https://github.com/sourcegraph/scip-typescript
- Repomix, https://github.com/yamadashy/repomix
- Context7, https://github.com/upstash/context7
- Claude Context, https://github.com/zilliztech/claude-context
- typescript-language-server, https://github.com/typescript-language-server/typescript-language-server
- Ce dépôt : le README de la CLI (
--json,list,describe,status,todo, l'AGENTS.md, les.claude/ruleset les.github/instructionsgénérés), le README racine (le hook).