
Import et export de fichiers
Statut : une conception, pas encore construite. Cette page dit comment le kit entend traiter un gros fichier en arrière-plan, avec les pièces qu'il a déjà : la file de jobs, le stockage de fichiers et les gestionnaires de processus. Aucun générateur, port ni package de cette version ne l'implémente ; ce qu'il faudrait ajouter est nommé sous « Ce qui serait ajouté ».
Résumé. Importer un tableur de dix mille lignes, ou exporter l'agenda d'une année, est un travail qu'un cas d'usage confie à un worker. Le fichier ne passe jamais par la base de données et ne tient jamais en entier en mémoire : un import lit le fichier stocké comme un flux et le transforme en commandes, un lot de lignes par unité de travail, avec sa progression et un point de reprise après chaque lot ; un export lit une recherche page par page et écrit le fichier par parties dans le stockage. Chaque exécution est un job en arrière-plan, relancé, observable et reprenable ; un très gros fichier est découpé en tranches traitées par plusieurs jobs et suivies par un gestionnaire de processus.
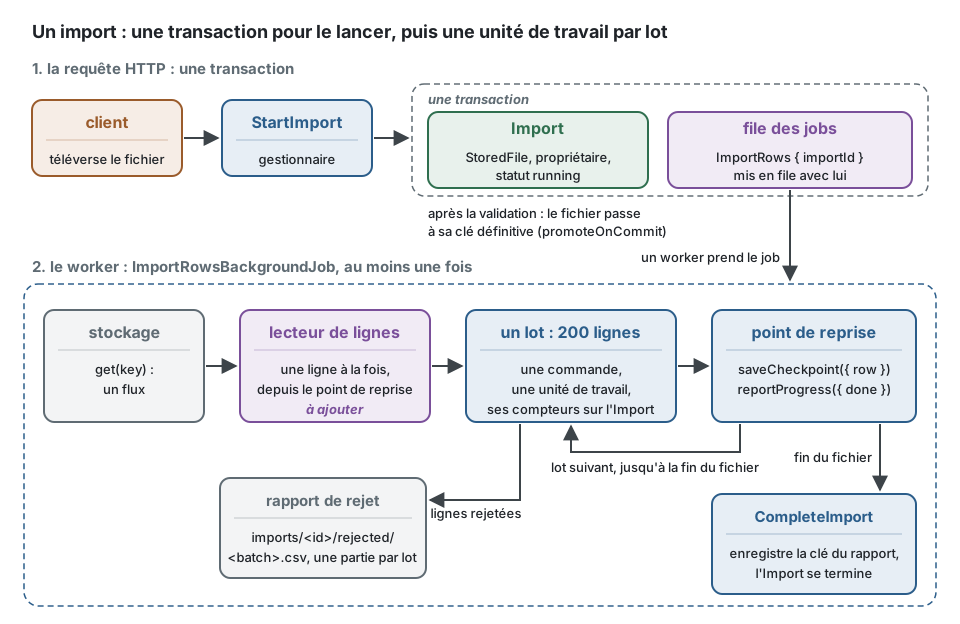
- Réception. Le fichier arrive comme n'importe quel autre : un
FileUploadque le bus met de côté et analyse avant la transaction, ou, pour un gros fichier, un envoi direct confirmé à partir de sonPendingUpload.FileScannerest l'endroit où vit une politique sur le format (un CSV de 50 Mo au plus, une seule feuille). - Lancement. Le gestionnaire de
StartImportenregistre un agrégatImportavec leStoredFile, son propriétaire et son statut, et met en fileImportRowsBackgroundJobavec l'identifiant de l'import pour tout contenu. Les deux sont validés ensemble, si bien qu'un import existe avec son job ou pas du tout ; le client reçoit l'identifiant et le suit. - Lecture. Le job ouvre
FileStorage.get(key)et passe le flux à un lecteur de lignes qui rend une ligne à la fois. Il ne charge jamais le fichier : la mémoire reste à la taille d'un lot. - Écriture. Les lignes sont validées selon l'entrée du cas d'usage qu'elles alimentent, puis
envoyées sous forme d'une commande par lot de, disons, 200 lignes : le bus exécute une commande
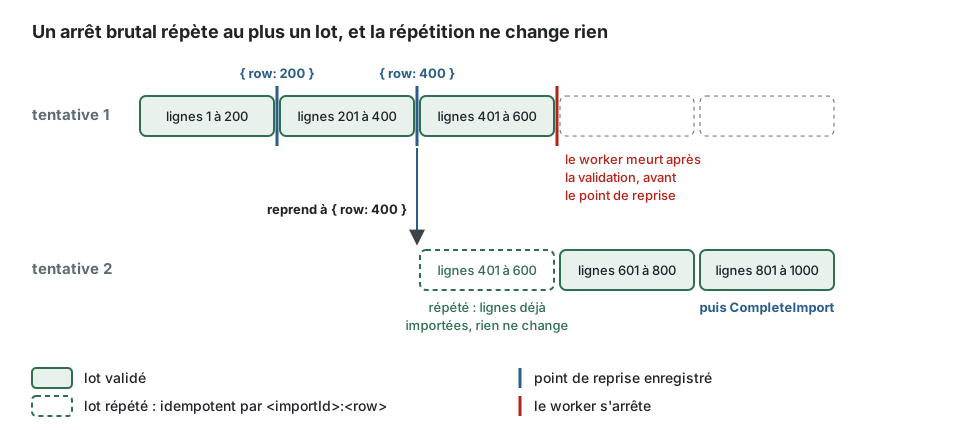
dans une unité de travail, si bien qu'un lot est validé ou annulé en entier et qu'un arrêt
brutal répète au plus un lot. Chaque ligne est idempotente grâce à une clé dérivée de l'import
et de la ligne (
<importId>:<row>), tenue par le cas d'usage (une contrainte d'unicité, ou le registre des clés traitées), si bien qu'un lot répété ne change rien. Le gestionnaire de cette commande enregistre les compteurs du lot sur l'Importdans la même unité de travail, indexés par lot, si bien qu'un lot répété remplace ses compteurs au lieu de les ajouter deux fois. - Reprise. Après chaque lot, le job enregistre
{ row }comme point de reprise (les compteurs sont déjà validés avec le lot, ils ne peuvent donc pas s'écarter de ce qui a été importé) et signale{ done: row }(ettotaldès qu'une première passe a compté les lignes, ou les octets lus rapportés à la taille quand elle ne l'a pas fait). Une nouvelle tentative, un bail expiré ou un arrêt du worker reprend au point de reprise : le flux est rouvert et saute jusqu'à la ligne, ou, quand le port le permettra, lit à partir d'une position en octets. - Rejet. Une ligne qui échoue à la validation ou à une règle métier n'est pas une erreur du
job : elle est comptée et écrite dans le rapport de rejet avec son numéro de ligne, sa
colonne et le code du refus. Le rapport est un fichier à part entière : écrit par parties
pendant l'exécution (
imports/<id>/rejected/<batch>.csv, chaqueputune fois par lot, si bien qu'un lot répété écrase sa propre partie) et assemblé à la fin en un seul fichier proposé par un lien signé. - Fin. Le job envoie
CompleteImport: l'agrégatImport, qui tient déjà les compteurs, enregistre la clé du rapport assemblé et se termine, et son événement d'intégration prévient qui attend (une notification à la personne qui a envoyé le fichier). Un job qui meurt après sa dernière tentative laisse l'importrunningavec son point de reprise : un opérateur relance le job (retryDead), rien n'est perdu.
Le job, avec les pièces qui existent
Section intitulée « Le job, avec les pièces qui existent »Tout ce qui suit compile aujourd'hui avec le kit, sauf le lecteur de lignes, déclaré ici parce qu'il est la première pièce de Ce qui serait ajouté. Le contenu est l'identifiant de l'import, le point de reprise la dernière ligne validée.
import {  AuthorizedCommand,  FileStorage,  type Actor,  type BackgroundJob,  type BackgroundJobExecution,  type CommandBus,} from '@ddd-ts-kit/kernel';import { Background } from '@ddd-ts-kit/kernel/declarations';import type { Readable } from 'node:stream';
// Pas encore dans le kit : un lecteur en flux qui rend une ligne à la fois à partir d'un numéro de ligne.interface Row {  readonly number: number;  readonly cells: Readonly<Record<string, string>>;}declare function readRows(stream: Readable, options: { readonly from: number }): AsyncIterable<Row>;
// Les cas d'usage du contexte qu'alimente l'import (générés comme n'importe quelle commande). Le gestionnaire// d'ImportPatientRows importe les lignes valides de façon idempotente par <importId>:<row>, enregistre les// compteurs du lot sur l'Import, et écrit les lignes rejetées dans imports/<id>/rejected/<batch>.csv.declare class ImportPatientRows extends AuthorizedCommand {  constructor(actor: Actor, importId: string, rows: readonly Row[]);}declare class CompleteImport extends AuthorizedCommand {  constructor(actor: Actor, importId: string);}
/** Ce que le job lit de l'agrégat Import : la clé de son fichier stocké. */export abstract class ImportFiles {  abstract keyOf(importId: string): Promise<string>;}
export interface ImportRowsPayload {  readonly importId: string;}
interface ImportRowsCheckpoint {  readonly row: number;}
const BATCH_SIZE = 200;
@Background({ timeout: '30m', lease: '1m' })export class ImportRowsBackgroundJob implements BackgroundJob<ImportRowsPayload> {  static readonly jobName = 'patients.import-rows';
  constructor(    private readonly storage: FileStorage,    private readonly imports: ImportFiles,    private readonly commands: CommandBus,  ) {}
  async run({ importId }: ImportRowsPayload, execution: BackgroundJobExecution): Promise<void> {    const content = await this.storage.get(await this.imports.keyOf(importId));
    if (content === undefined) {      throw new Error(`The file of import ${importId} is gone.`);    }
    let batch: Row[] = [];
    for await (const row of readRows(content.stream, { from: rowOf(execution.checkpoint) + 1 })) {      batch.push(row);
      if (batch.length === BATCH_SIZE) {        await this.importBatch(importId, batch, execution);        batch = [];      }    }
    if (batch.length > 0) {      await this.importBatch(importId, batch, execution);    }
    await this.commands.execute(new CompleteImport(execution.actor, importId));  }
  /** Une commande, une unité de travail : le lot est validé en entier, puis le point de reprise le dépasse. */  private async importBatch(importId: string, batch: readonly Row[], execution: BackgroundJobExecution): Promise<void> {    execution.signal.throwIfAborted();    await this.commands.execute(new ImportPatientRows(execution.actor, importId, batch));
    const checkpoint: ImportRowsCheckpoint = { row: batch[batch.length - 1]?.number ?? 0 };
    await execution.saveCheckpoint(checkpoint);    await execution.reportProgress({ done: checkpoint.row });  }}
function rowOf(checkpoint: unknown): number {  return typeof checkpoint === 'object' && checkpoint !== null && 'row' in checkpoint && typeof checkpoint.row === 'number'    ? checkpoint.row    : 0;}
Les commandes sont envoyées en tant que execution.actor, la personne qui a envoyé le fichier,
si bien que chaque lot est autorisé et audité comme le sien. Un arrêt brutal entre la validation
d'un lot et son point de reprise répète ce lot à la tentative suivante, et c'est pourquoi
ImportPatientRows garde chaque ligne idempotente par <importId>:<row> :
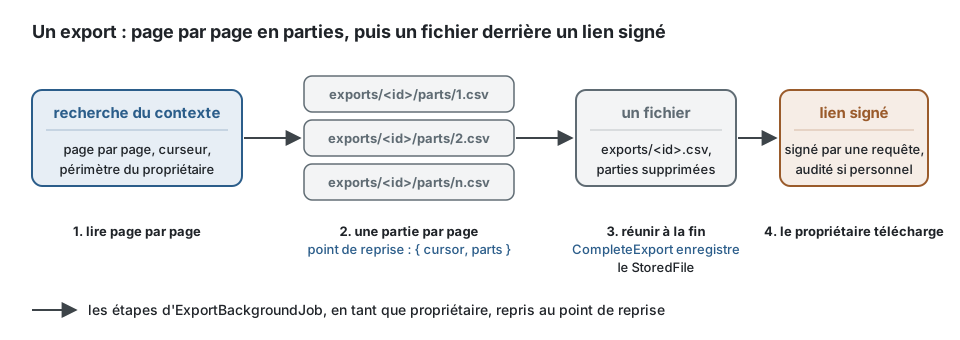
RequestExportenregistre unExportavec ses critères et son propriétaire, et met en fileExportBackgroundJob. Les critères sont ceux d'une recherche du contexte, restreinte au périmètre d'accès du propriétaire au moment où le job s'exécute, puisqu'il s'exécute en tant que cet acteur.- Le job lit la recherche page par page avec un curseur, jamais un décalage, et écrit chaque
page comme une partie,
exports/<id>/parts/<n>.csv: un stockage objet ne sait pas ajouter à la fin d'un objet, et une partie écrite deux fois reste la même partie. Le point de reprise est le curseur et le nombre de parties. - À la fin, les parties sont assemblées en un fichier (un envoi en plusieurs parties du stockage
objet, ou une copie dans une seule clé), les parties sont supprimées, et
CompleteExportenregistre leStoredFile. Le propriétaire le télécharge par un lien signé qu'une requête signe, audité quand les données sont personnelles. - Les exports sont gardés un temps puis purgés par un job planifié (
purgeFinishedde la file pour les jobs, une règle de cycle de vie ou un listage deexports/pour les fichiers).
Très gros fichiers
Section intitulée « Très gros fichiers »Un job par fichier occupe un worker pendant tout le fichier. Au-delà de ce qu'une tentative
peut faire dans son délai d'expiration, l'import se découpe : un premier job compte les lignes
et met en file un job par tranche de lignes ({ importId, from, to }), et un gestionnaire de
processus indexé par l'import compte les tranches terminées à partir de leurs événements et
termine l'import quand toutes le sont. Les tranches s'exécutent en parallèle, dans la limite de
la concurrence de la file du contexte, et chacune reprend à son propre point de reprise. L'ordre
entre les lignes est alors perdu : un fichier dont les lignes dépendent les unes des autres (une
ligne qui fait référence à une ligne précédente) reste un seul job.
Ce qui voyage avec le job
Section intitulée « Ce qui voyage avec le job »Le job s'exécute en tant que l'acteur qui a lancé l'import ou demandé l'export, dans son
tenant et sa corrélation, si bien que chaque commande qu'il envoie est autorisée au nom de cette
personne et auditée sous une seule corrélation avec la requête HTTP qui l'a lancé. Les clés
viennent de FileKeys, sous le tenant du travail ; le rapport et l'export sont des fichiers de
ce tenant. Le job est mis en file avec l'import comme subject et le fichier comme clé
d'idempotence (restreinte au tenant par la file) : la requête qui montre la progression d'un
import vérifie le sujet, comme le fait l'habilitation de l'exemple, et un second envoi du même
fichier dans un même tenant répond par l'import déjà en cours. L'acteur est celui de l'envoi,
capturé à ce moment-là : un droit révoqué pendant un long import s'applique encore à ses derniers
lots.
Ce qui serait ajouté
Section intitulée « Ce qui serait ajouté »| Pièce | Où | Pourquoi |
|---|---|---|
| Un lecteur et un écrivain de lignes (CSV d'abord, XLSX derrière une dépendance peer facultative) | un nouveau package, ou un sous-chemin d'un package existant | lecture et écriture en flux, détection de l'encodage, guillemets, une taille maximale de ligne |
FileStorage.get(key, { from }) |
le port et ses connecteurs | reprendre un import à une position en octets au lieu de sauter des lignes |
Un assemblage de parties (compose(keys, into)) |
le port, sous forme d'envoi en plusieurs parties sur S3 et de concaténation sur le dossier local | construire un export ou un rapport à partir de ses parties |
generate import <context> <Name> --command <UseCase> |
la CLI | l'agrégat, le job, le rapport et leurs specs, comme le fait generate background-job pour une commande |
| Une suite de contrat pour les imports | @ddd-ts-kit/testing |
un arrêt brutal entre deux lots répète un lot et ne change rien |
- Au moins une fois, par lot. Un lot est répété quand son worker meurt après la validation et avant le point de reprise : les commandes d'un import sont idempotentes, ou l'import n'est pas sûr.
- Aucune transaction autour du fichier entier. Un import est une suite de lots validés : un
fichier à moitié importé est un état normal et visible (
running,{ done: 4200 }). Un cas d'usage qui exige tout ou rien valide d'abord le fichier entier, dans une exécution à blanc qui n'envoie rien, puis importe. - Un worker par job. La concurrence vient des tranches, au prix de l'ordre.
- Les formats sont une politique. Un format que le lecteur de lignes ne connaît pas est refusé à l'analyse, pas lu à moitié.